AIエージェント
GPT-6 Astraは公開重みLLMに勝てるか――3本のFortranコードCPU高速化を完全ブラインド評価
GPT-6 Astraへ3本の公開Fortranコードを各32分23秒、完全ブラインドで高速化させた。単体最高は49.72倍。しかし3本総合ではKimi K3が首位を守った。勝敗以上に、モデルごとの得意構造が見えた。
AIエージェント
GPT-6 Astraへ3本の公開Fortranコードを各32分23秒、完全ブラインドで高速化させた。単体最高は49.72倍。しかし3本総合ではKimi K3が首位を守った。勝敗以上に、モデルごとの得意構造が見えた。
LLM
同じ3本の公開Fortran、同じ1,943秒、同じ40コア、完全一致。最大級3モデルに加えてQwen 27BとDS4 Q4を同条件で評価すると、小型モデルにも本格的な高速化はできたが、総合到達点には大きな差が出た。
LLM
同じ公開Fortran、同じ1,943秒、同じ40コア、完全一致。勝者はGPT-5.6 Solだった。しかし公開重みのKimi K3との差は、わずか1.247%だった。

GPUサーバー・ハードウェア
H100 80GB PCIeは本当に販売終了したのか。国内流通とソフトウェアサポートの違い、現在の価格・在庫、アウトレット購入時の診断・保証・互換性を整理します。
HPC・科学計算
近畿大学の研究用Fortranコードを、Intel oneAPI MKL、OpenMP、計算条件間の依存関係を保った並列分割、CPUコアとメモリの配置、出力統合の改善により、同一40コア環境で399.60秒から20.73秒へ、約19.3倍高速化した事例です。
AI・ローカルLLM
Local LLM controller、Web検索、安全なCLI操作を組み合わせ、LLZOのLiイオン拡散評価に向けたQuantum ESPRESSO環境構築とbounded sanity runまでを実践しました。
AI・ローカルLLM
RTX PRO 6000 Blackwell 2GPU評価機で、Qwen2.5-72B BF16/FP8/NVFP4、Nemotron3 120B FP8、Qwen3 235B NVFP4をQE/LAMMPS入力生成タスクで比較しました。
HPC・科学計算
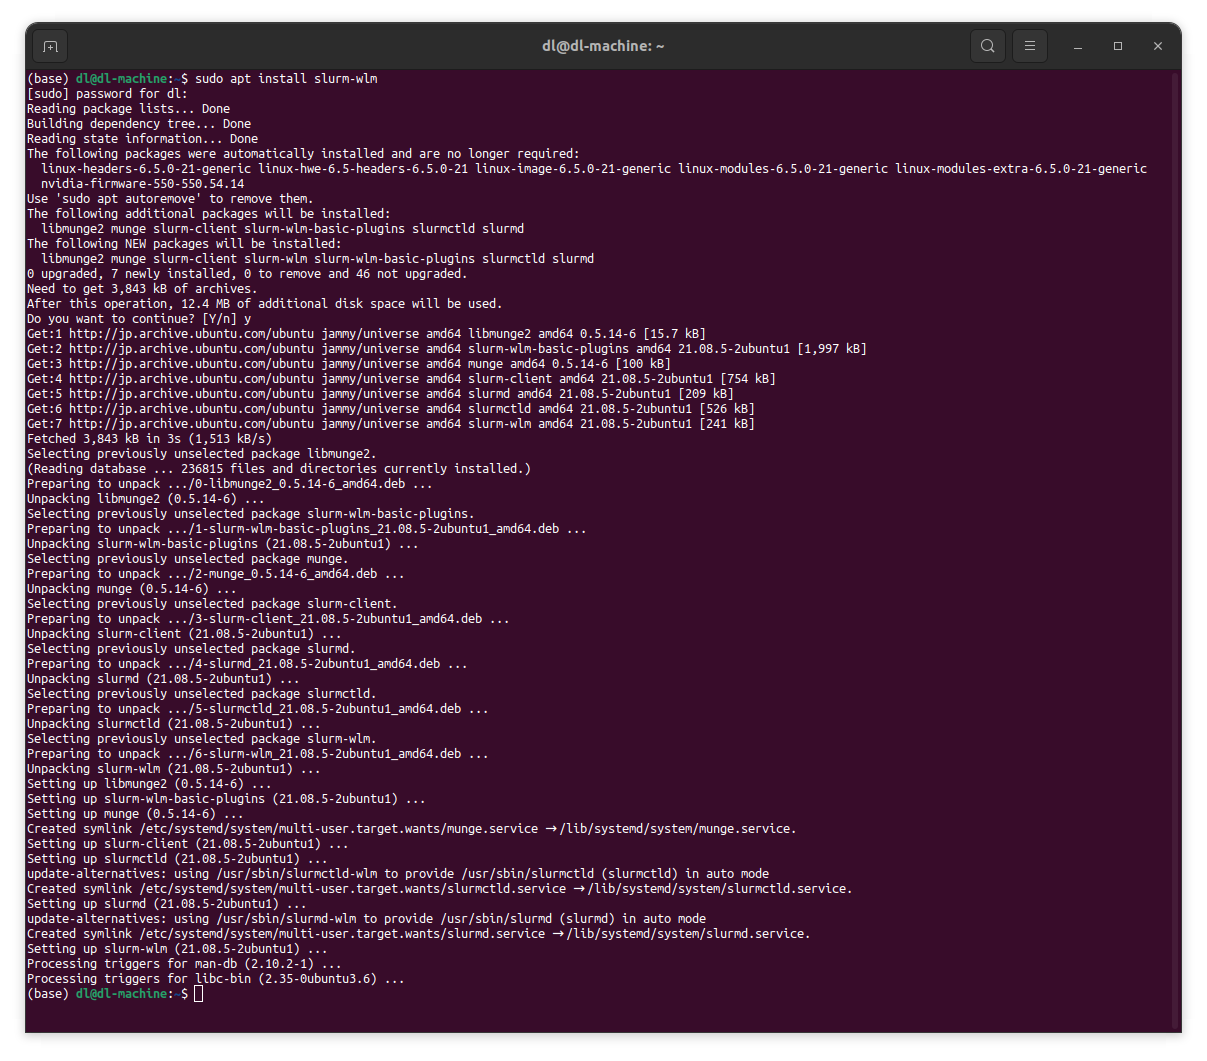
以前の記事ではGPUがない場合の、Slurmのインストールと設定と使用方法を解説しましたが、この記事では8GPUのサーバーにSlurmのインストールと設定を行います。設定ファイルの自動生成のスクリプトの紹介も行っていますので、これを使えばGPUサーバーでのSlurmの設定も簡単に行うことができます。その後、tf...
HPC・科学計算
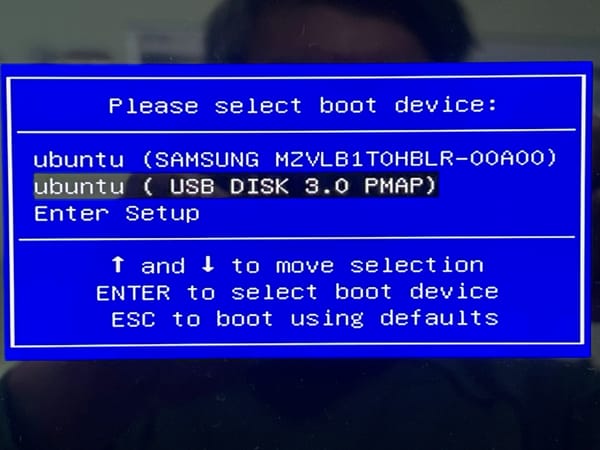
本Blogで連載の「HPC Cluster構築」の手順に従って作成した、Virtual HPC Cluster USBの使い方を説明します。 USBメモリをノートPC、デスクトップPC、ワークステーション、サーバーなどに差し込んで、Boot Deviceとして選択して立ち上げます。