ベンチマーク・検証
8GPU: A6000 の nvidia-smi と deviceQuery
HPCDIY-ERMGPU8R4S(こちら)に A6000 を 8 枚実装して、nvidia-smi と deviceQuery を実行してみました。
ベンチマーク・検証
HPCDIY-ERMGPU8R4S(こちら)に A6000 を 8 枚実装して、nvidia-smi と deviceQuery を実行してみました。
ベンチマーク・検証
A6000を1, 2, 4, 8 GPU 使い、batch size を64, 128, 256, 512, 1024 と変化させてtf_cnn_benchmarks での学習速度を計測しました。 modelは、resnet50, inception3, vgg16, nasnet, resnet152,...
ベンチマーク・検証
GeForce RTX 3090を1, 2, 4, 8 GPU 使い、batch size を64, 128, 256, 512と変化させてtf_cnn_benchmarks での学習速度を計測しました。 modelは、resnet50, inception3, vgg16, nasnet, resnet152,...
ベンチマーク・検証
GeForceでは最強のRTX 3090と、NVIDIA RTX A6000とは価格差はかなりありますが(2021年7月12日現在、¥329,220 vs ¥589,850,...
GPUサーバー・ハードウェア
同型機のラックマウントの経験がないと苦労する可能性がありますので、動画にしてみました。
ベンチマーク・検証
再計測(NGCのtensorflow:20.10-tf1-py3使用)GeForce RTX 3090 の Deep Learning 学習での性能評価のため、HPCDIY-ERM1GPU4TS に4枚実装して、tensorflow で...
ベンチマーク・検証
NVIDIA A100 PCIe 40GB の Deep Learning 学習での性能評価のため、HPCDIY-ERMGPU8R4S に2枚実装して、tensorflow で tf_cnn_benchmarks.py(ダウンロートはこちら)を実行してみました。 CPU: 2x AMD EPYC Rome 7302...

ベンチマーク・検証
HPCDIY-ERMGPU8R4S(こちら)にGeForce NVIDIA A100 PCIe 40GB を枚実装し、gpu_burn(こちら)を実行して、消費電力と温度が定常状態になるまでを nvidia-smi -l で監視してみました。
ベンチマーク・検証
HPCDIY-ERMGPU8R4S(こちら)に NVIDIA A100 を 2 枚実装して、nvidia-smi と deviceQuery を実行してみました。
ベンチマーク・検証
GeForce RTX 3090 の Deep Learning 学習での性能評価のため、HPCDIY-ERMGPU8R4S に8枚実装して、tensorflow で tf_cnn_benchmarks.py(ダウンロートはこちら)を実行してみました。 CPU: 2x AMD EPYC Rome 7302...
ベンチマーク・検証
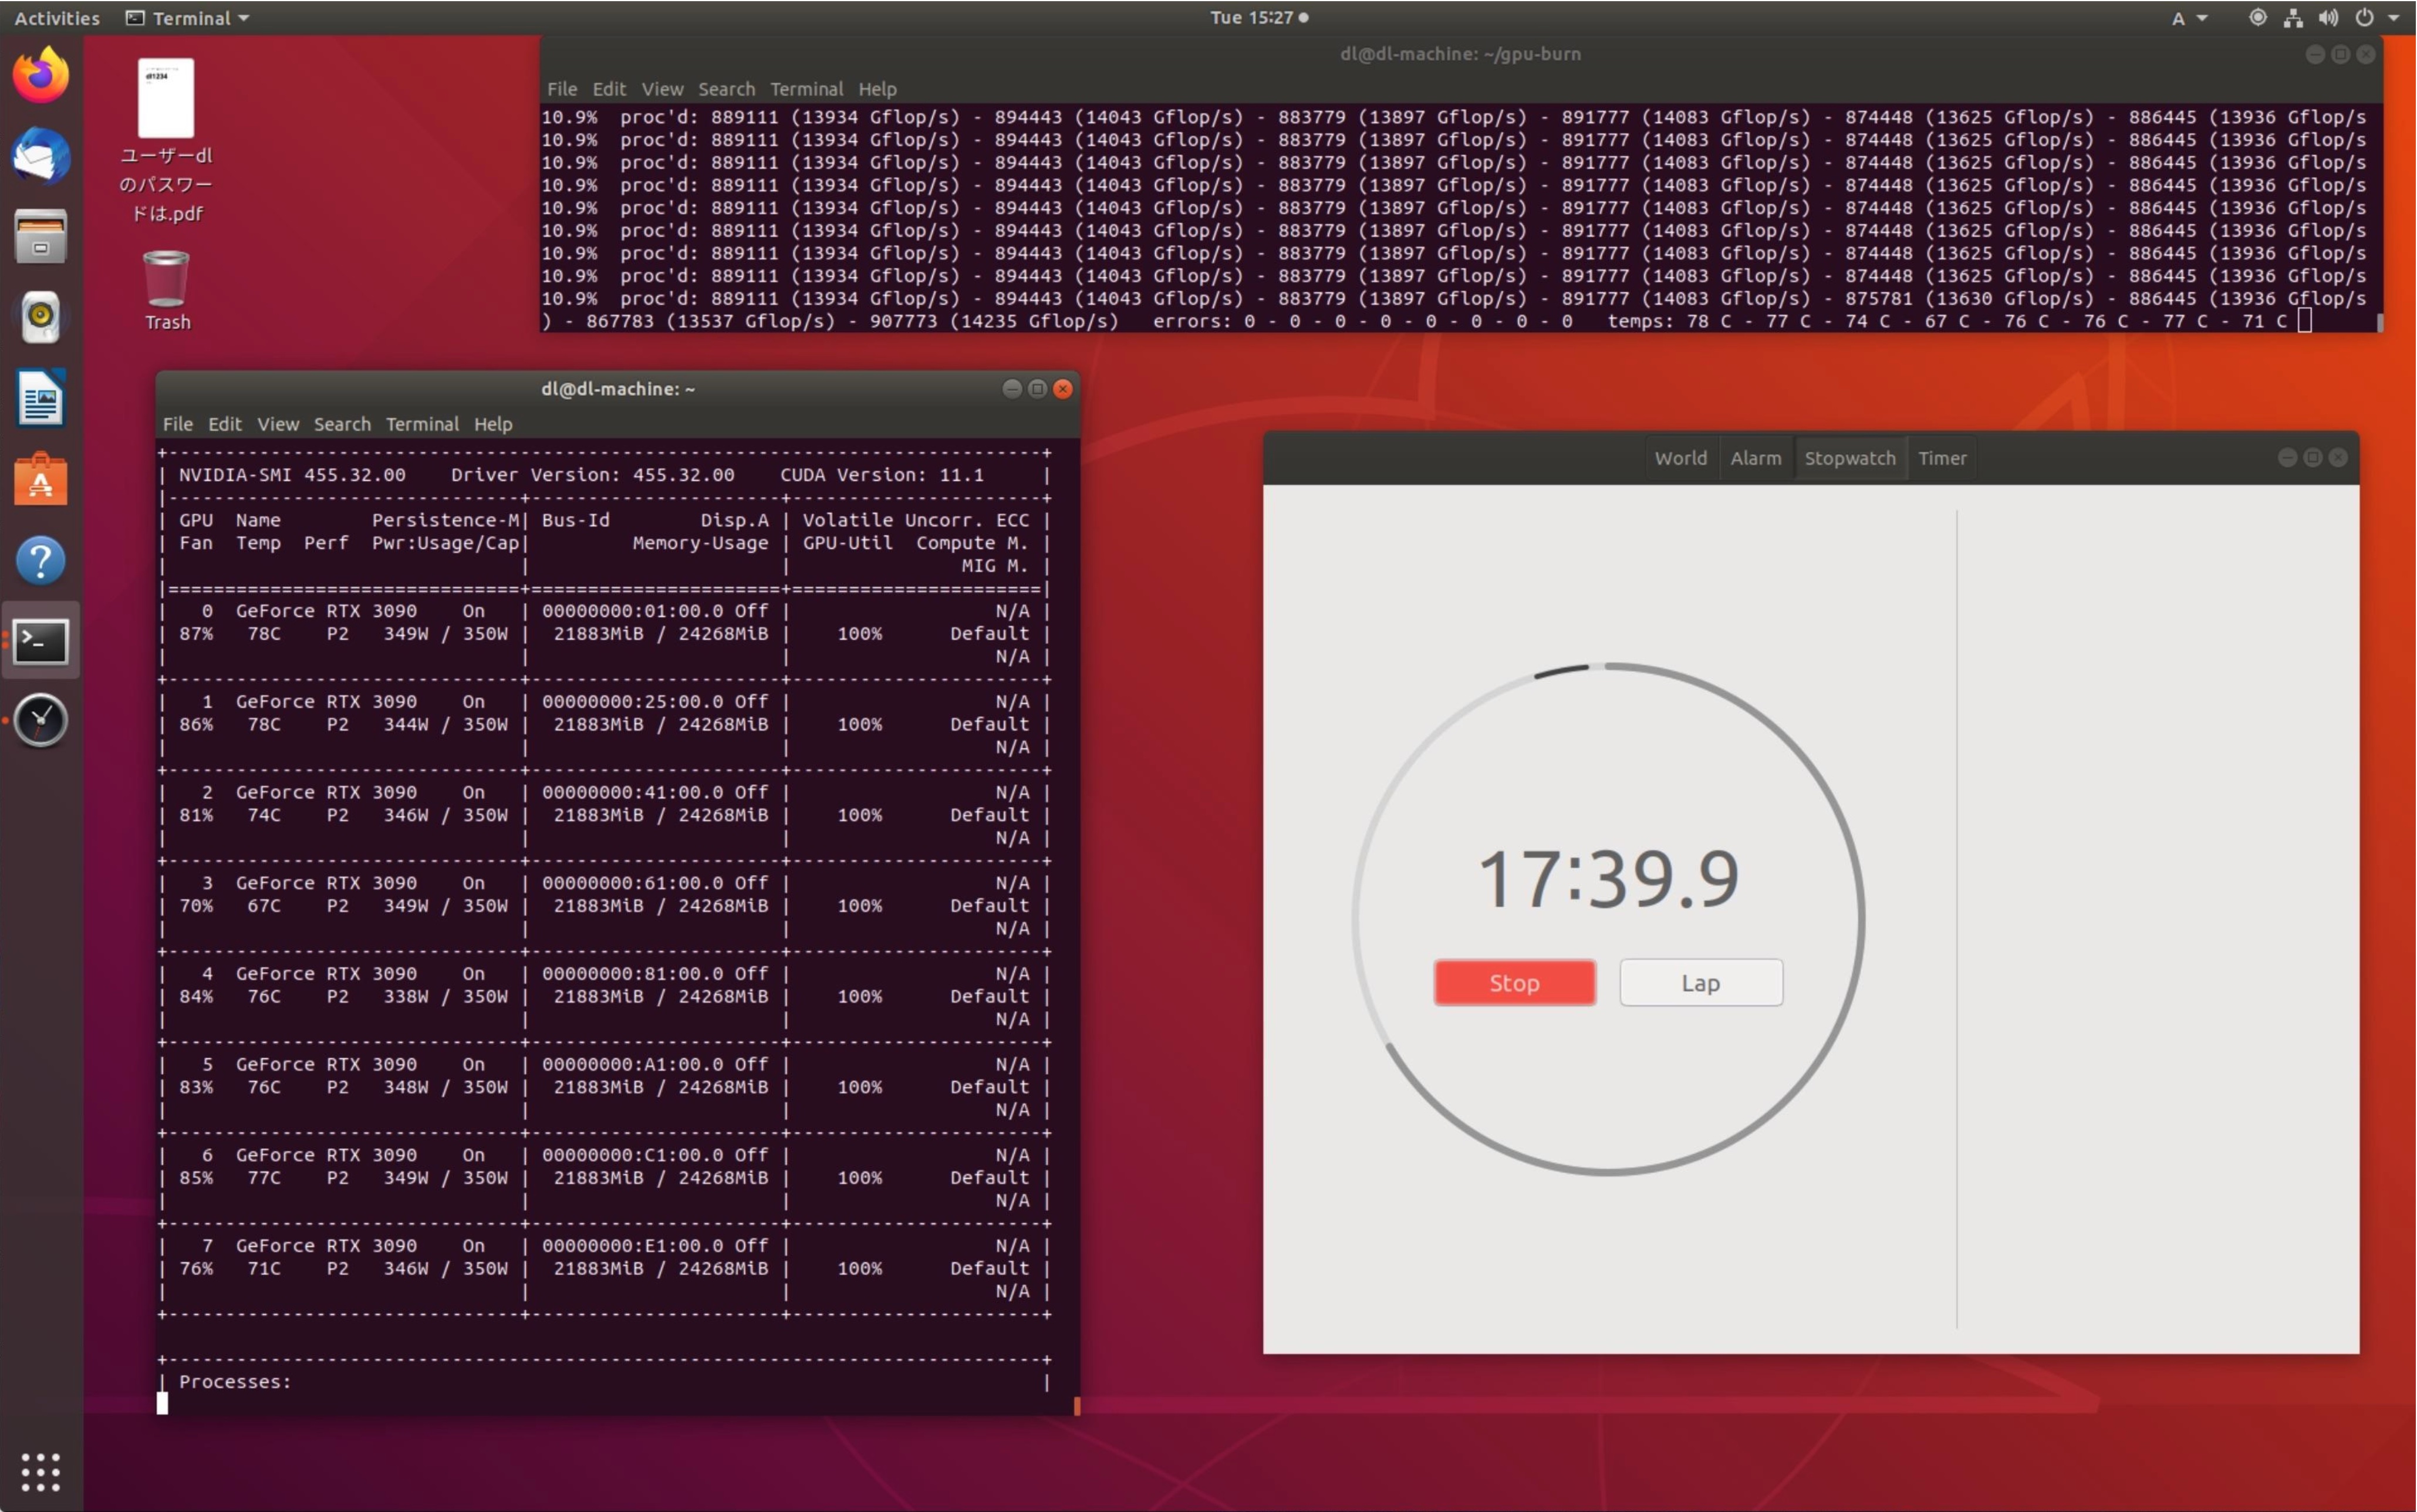
HPCDIY-ERMGPU8R4S(こちら)にGeForce RTX 3090 を8枚実装し、gpu_burn(こちら)を実行して、消費電力と温度が定常状態になるまでを nvidia-smi -l で監視してみました。
ベンチマーク・検証
HPCDIY-ERMGPU8R4S(こちら)に GeForce RTX 3090 を 8 枚実装して、nvidia-smi と deviceQuery を実行してみました。