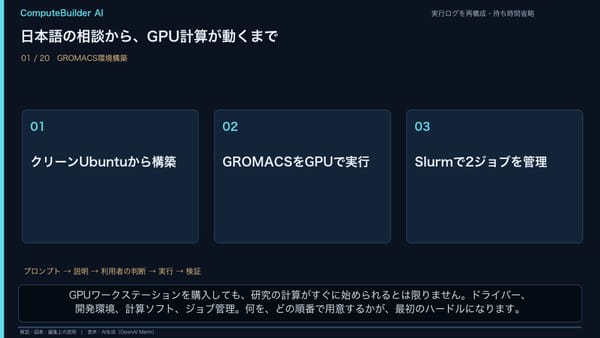
クリーンUbuntuからGROMACSのGPU計算へ:ComputeBuilder AIで構築からSlurmまで
DGX Spark上のComputeBuilder AIに日本語で相談し、RTX PRO 6000 Blackwellのドライバー、CUDA、GROMACS、Slurmを構築。10個のプロンプト、実測結果、AIと内蔵手順の役割を動画とともに紹介します。
DGX Spark上のComputeBuilder AIに日本語で相談し、RTX PRO 6000 Blackwellのドライバー、CUDA、GROMACS、Slurmを構築。10個のプロンプト、実測結果、AIと内蔵手順の役割を動画とともに紹介します。
DGX Spark上のComputeBuilder AIに日本語で相談し、クリーンなUbuntuからH100×2のドライバー、HPC SDK、Quantum ESPRESSO、Slurmを構築。全8プロンプト、途中の失敗と修正、2GPU同時実行の根拠を動画とともに紹介します。
DeepSeek V4.1 Flashへ3本の公開Fortranコードを各32分23秒、完全ブラインドで高速化させた。最大39.653倍、3本総合22.029倍で7モデル中3位。推定API費用は3本合計約0.42ドルだった。
GPT-6 Astraへ3本の公開Fortranコードを各32分23秒、完全ブラインドで高速化させた。単体最高は49.72倍。しかし3本総合ではKimi K3が首位を守った。勝敗以上に、モデルごとの得意構造が見えた。
同じ3本の公開Fortran、同じ1,943秒、同じ40コア、完全一致。最大級3モデルに加えてQwen 27BとDS4 Q4を同条件で評価すると、小型モデルにも本格的な高速化はできたが、総合到達点には大きな差が出た。
同じ公開Fortran、同じ1,943秒、同じ40コア、完全一致。勝者はGPT-5.6 Solだった。しかし公開重みのKimi K3との差は、わずか1.247%だった。
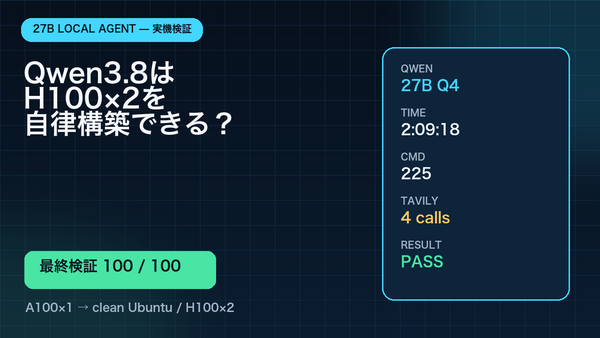
A100 80GB 1枚でQwen3.8-27B Q4_K_Mを動かし、Codex CLIとTavilyを使ってクリーンなH100×2サーバーをSlurm経由Quantum ESPRESSOまで自律構築。DS4 Q2との実機比較も含む検証記録。
DGX Spark上のDS4 2026-07-31 Q2に、クリーンなH100×2サーバーへのNVIDIAドライバー、HPC SDK、Quantum ESPRESSO、Slurm導入を1つの長いプロンプトで任せた。3時間20分の実機評価と失敗からの回復、安全監査、A100×4との比較を公開する。
新旧DS4 Q4/Q2でH100×2のクリーン構築を比較した 今回検証したのは、チャットの受け答えや単発のコード生成ではありません。クリーンなUbuntu 24.04に、NVIDIAドライバー、NVIDIA HPC SDK、GPU対応Quantum ESPRESSO、MUNGE、Slurmを順に導入し、最後にSlurmからGPU計算を完走させる、実運用に近い長時間タスクです。 構成を正確に書くと、次のとおりです。 A100×4上で動作するDS4が、クリーンなUbuntu 24.04を搭載したH100×2サーバーをSSH経由で構築・検証した。 DS4そのものをH100×2で動かしたわけではありません。推論側は全モデルともA100 80GBを4枚、構築対象だけがH100 PCIeを2枚搭載したサーバーです。 比較した4モデル * 2026-07-31以前のDS4 Q4 * 2026-07-31以前のDS4 Q2 * 2026-07-31版DS4 Q4 * 2026-07-31版DS4
H100 80GB PCIeは本当に販売終了したのか。国内流通とソフトウェアサポートの違い、現在の価格・在庫、アウトレット購入時の診断・保証・互換性を整理します。
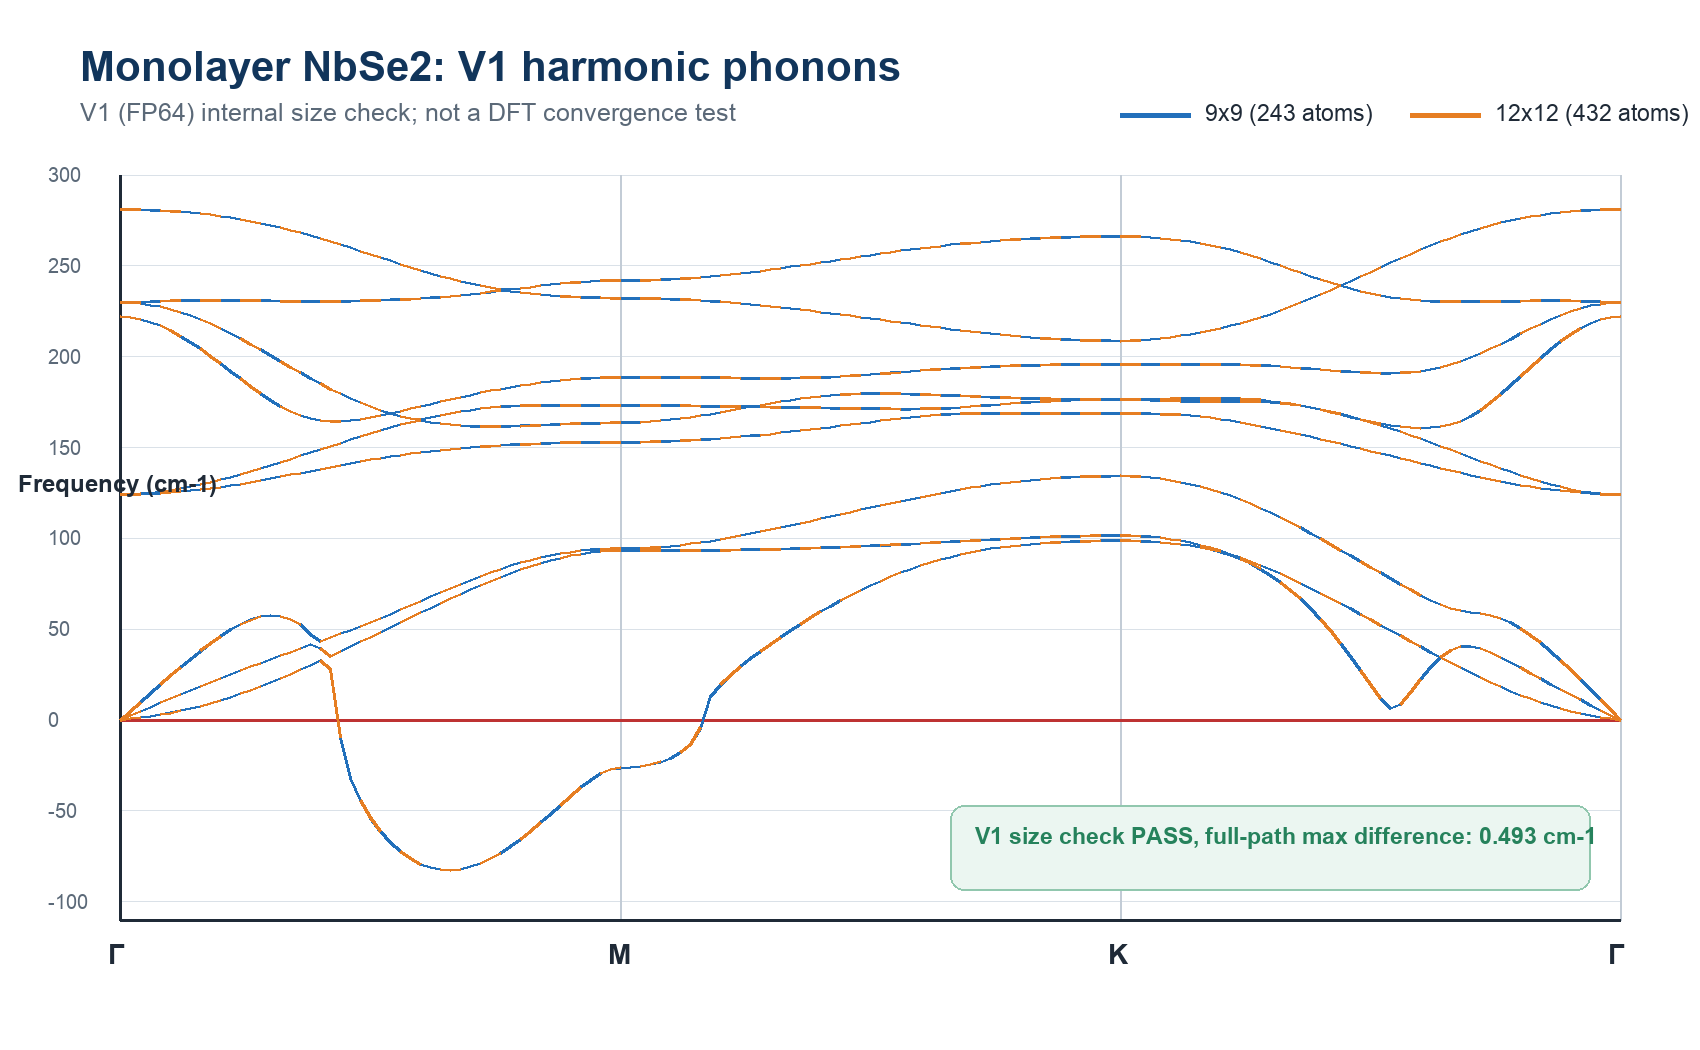
NbSe2の原子をどの方向へずらすとエネルギーが下がるのか。H100上の公開AIモデルV1で388条件を下見し、別枠の27原子DFT 5点で独立確認しました。二段階の意味を山の測量にたとえて解説します。
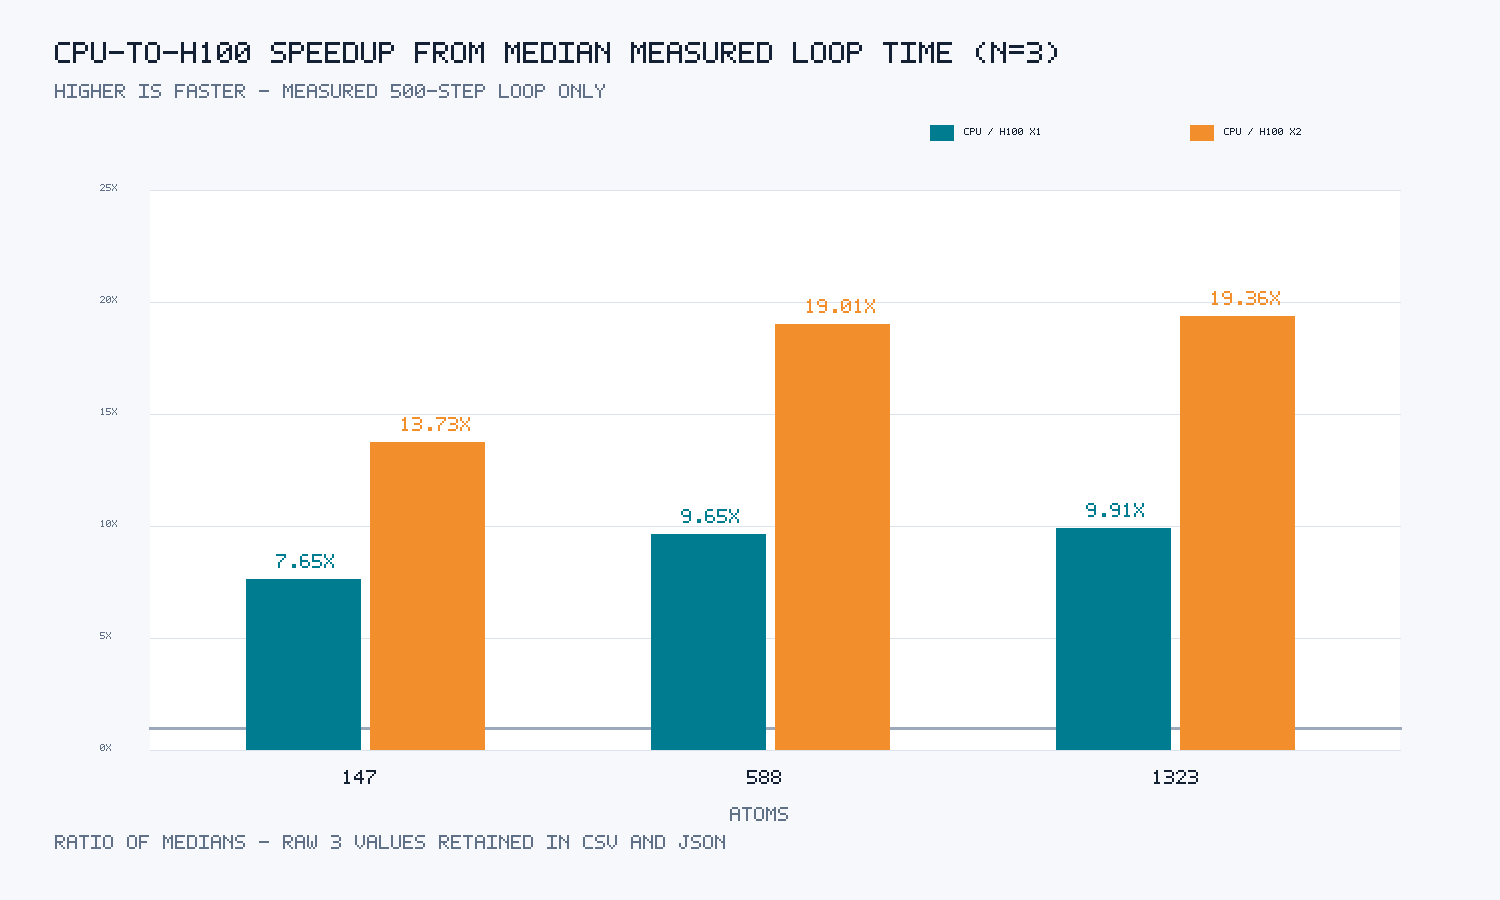
超伝導と電荷密度波が共存するNbSe₂で、なぜ原子の時間変化を追うのか。公開AllegroモデルによるCPU 64コアとH100×2の実測から、計算速度が研究の問いをどう広げるかを解説します。
HPC・科学計算
近畿大学の研究用Fortranコードを、Intel oneAPI MKL、OpenMP、計算条件間の依存関係を保った並列分割、CPUコアとメモリの配置、出力統合の改善により、同一40コア環境で399.60秒から20.73秒へ、約19.3倍高速化した事例です。
AI・ローカルLLM
A100 80GB x4のGPUサーバで複数のローカルLLMを動かし、導入説明、障害メモ、要約、ブログ構成という実務寄りの質問で回答の違いを比較しました。
AI・ローカルLLM
GPUマキシマイザー開発の一環として、巨大なローカルLLMをA100 GPUサーバー上で動かし、GPU運用assistant、agent loop、実Fortran/CUDA高速化支援までを検証しました。
AI・ローカルLLM
A100 80GB×4でGLM-5.2 2bit GGUFをロード・生成・OpenAI互換API応答まで確認。さらにDS4/Qwen3-14Bと、Slurm導入前判断、NVIDIA driver再インストール要求、vLLM OOMなど6つのGPUサーバー運用タスクで比較しました。
AI・ローカルLLM
DS4 q2-imatrix / ctx131K の短時間smokeと8K benchmarkが、A100 80GB×2 NVLink接続ペアで完走しました。今回の結果は q2・短時間検証・NVLink接続ペアという条件付きですが、少なくとも入口構成としてはA100×4必須ではない可能性を確認できました。
AI・ローカルLLM
Local LLM controller、Web検索、安全なCLI操作を組み合わせ、LLZOのLiイオン拡散評価に向けたQuantum ESPRESSO環境構築とbounded sanity runまでを実践しました。
AI・ローカルLLM
RTX PRO 6000 Blackwell 2GPU評価機で、Qwen2.5-72B BF16/FP8/NVFP4、Nemotron3 120B FP8、Qwen3 235B NVFP4をQE/LAMMPS入力生成タスクで比較しました。
AI・ローカルLLM
ローカルLLMはAllegro/NeQUIPの学習設定YAMLを作れるのか:Nemotronでmetadata-only preflightを検証 これは性能ベンチマークではありません。A100x4上のローカルLLMで、Allegro / NeQUIPの学習設定YAMLをどこまで安全に作り、実行前に確認できるかを調べた機能検証です。 結論から言うと、NemotronはAllegro / NeQUIPのtraining YAML候補を生成できました。既存SIF内で torch / nequip / allegro のimport、A100x4のCUDA可視
AI・ローカルLLM
ローカルLLMはHPC入力ファイルを作り、エラーを直せるのか:NemotronでQuantum ESPRESSOとLAMMPSを検証 この記事の位置づけ これは性能ベンチマークではなく、 ローカルLLMがHPC入力ファイルの生成、実行ログを使った修正、再実行まで支援できるか を確認した機能検証です。 H200 NVLやRTX PRO 6000 Blackwellへの一般化はせず、次回以降の別フェーズとして扱います。 結論 A100 80GB x4上で NVIDIA-Nemotron-3-Nano-30B-A3B-BF16 をローカル配信し、Quantum
構築・運用
Server Gear Blog では、GPUサーバー、HPC、RescueReady OS、GPU Start Console、ローカルLLM、ベンチマーク検証などについて発信していきます。 手順書、証跡、runbook は notes.server-gear.com に集約し、このブログでは開発背景、考え方、検証記録、導入事例を中心に扱います。
ベンチマーク・検証
FP64 synthetic だけでは見えない GPU 比較: QE と LAMMPS の確認結果 結論 A100 が最速 でした。今回の比較では、QE long-run と LAMMPS selected stable case の両方で最上位です。 Ada は実用域 でした。QE long-run と custom LLZO LAMMPS の selected stable case の両方で、A100に次ぐ現実的な選択肢です。 Blackwell は今回の条件と現行スタックでは Ada より遅い 結果でした。差の主因は収束回数増ではなく、 elec
AI・ローカルLLM
DoMINOで“外部空力(CFD)”を秒オーダーで試す(初心者向け) 結論(1分) DoMINO(DoMINO-Automotive-Aero NIM)は、車体形状(STL)から 抗力/揚力 と 表面圧力分布 を返す「CFDサロゲート(代理モデル)」です。 4GPUマシンでは、 同時リクエスト(並列) を増やすことでスループットがほぼ比例して伸びます。 実測では、H100 NVL 4GPUで conc=1→9.16 req/min、conc=4→36.92 req/min(約4倍)、conc=8→55.49 req/min でした。 --- 1) DoM