AIエージェント
GPT-6 Astraは公開重みLLMに勝てるか――3本のFortranコードCPU高速化を完全ブラインド評価
GPT-6 Astraへ3本の公開Fortranコードを各32分23秒、完全ブラインドで高速化させた。単体最高は49.72倍。しかし3本総合ではKimi K3が首位を守った。勝敗以上に、モデルごとの得意構造が見えた。
AIエージェント
GPT-6 Astraへ3本の公開Fortranコードを各32分23秒、完全ブラインドで高速化させた。単体最高は49.72倍。しかし3本総合ではKimi K3が首位を守った。勝敗以上に、モデルごとの得意構造が見えた。
LLM
同じ3本の公開Fortran、同じ1,943秒、同じ40コア、完全一致。最大級3モデルに加えてQwen 27BとDS4 Q4を同条件で評価すると、小型モデルにも本格的な高速化はできたが、総合到達点には大きな差が出た。
LLM
同じ公開Fortran、同じ1,943秒、同じ40コア、完全一致。勝者はGPT-5.6 Solだった。しかし公開重みのKimi K3との差は、わずか1.247%だった。
AI・ローカルLLM
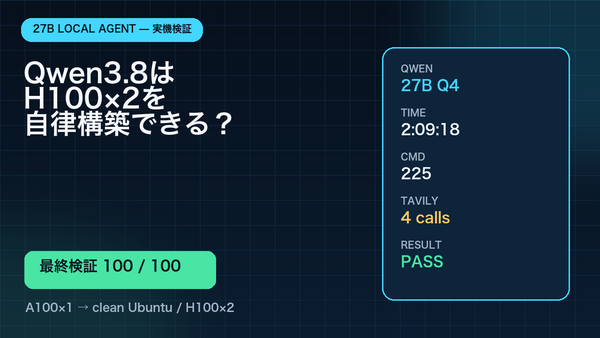
A100 80GB 1枚でQwen3.8-27B Q4_K_Mを動かし、Codex CLIとTavilyを使ってクリーンなH100×2サーバーをSlurm経由Quantum ESPRESSOまで自律構築。DS4 Q2との実機比較も含む検証記録。
AI・ローカルLLM
GPUマキシマイザー開発の一環として、巨大なローカルLLMをA100 GPUサーバー上で動かし、GPU運用assistant、agent loop、実Fortran/CUDA高速化支援までを検証しました。