27BのローカルAIは、H100×2サーバーを自力で構築できるのか——Qwen3.8をA100 1枚で2時間走らせた
A100 80GB 1枚でQwen3.8-27B Q4_K_Mを動かし、Codex CLIとTavilyを使ってクリーンなH100×2サーバーをSlurm経由Quantum ESPRESSOまで自律構築。DS4 Q2との実機比較も含む検証記録。
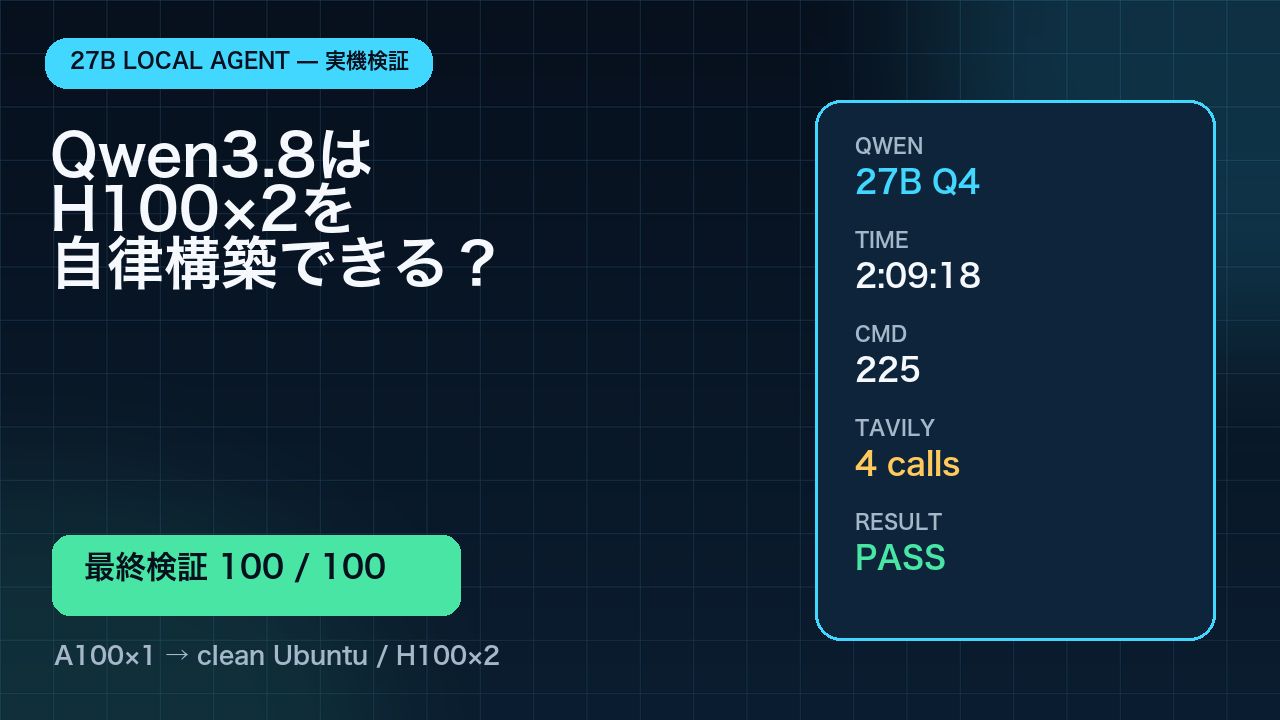
先に結論
できました。
A100 80GB 1枚で動かしたQwen3.8-27B Q4_K_MをCodex CLIにつなぎ、クリーンなUbuntu 24.04のH100×2サーバーをSSHで操作させました。NVIDIAドライバー、HPC SDK 26.5、OpenACC、Quantum ESPRESSO 7.6、MUNGE、Slurm、1GPU隔離、Slurm経由のGPU計算まで、最後は外部検証で100/100です。
人間が解決方法を教えた回数は0回。所要時間は2時間09分18秒。225コマンドを実行し、17回の非0終了を踏みながら全項目へ到達しました。
ただし、これは「27Bが巨大なDS4と同じ知能だ」という記事ではありません。DS4 Q2は同じ課題を1時間16分04秒、143コマンドで完了しています。さらにQwenはA100 1枚、DS4はA100 4枚で、推論条件も同一ではありません。
今回わかったのは、もっと実務的なことです。
19GB弱のGGUFをA100 1枚で動かす27Bモデルでも、検索、長いコンテキスト、Codex CLI、厳格な検証器を正しく組み合わせれば、難しいGPUインフラ作業を最後まで続けられる。
元になった着想は、Qwenをローカルのパーソナルエージェントとして常用するというこちらの記事でした。チャットの印象ではなく、失敗しやすい実機構築を任せたらどうなるのか。それを試しました。
何をさせたのか
構成を誤解しやすいので、最初にはっきりさせます。
A100 80GB×1
  Qwen3.8-27B Q4_K_M
  llama.cpp + Codex CLI
           │ SSH
           ▼
clean Ubuntu 24.04
  H100 PCIe 80GB×2
QwenをH100上で動かしたわけではありません。A100側のQwenが計画し、コマンドを作り、H100側のクリーンOSへSSHで入り、次を構築しました。
- NVIDIA open kernel driver
- NVIDIA HPC SDK 26.5 / CUDA 13.2
- OpenACCとCUDAの実GPUスモークテスト
- QEF公式Quantum ESPRESSO 7.6
- H100向けGPUビルド
- Si SCF計算と
JOB DONE - MUNGEとSlurm
- GRES
gpu:2 - 1GPUジョブの隔離
- Slurm経由のQE GPU計算
開始時にはnvidia-smiすらなく、CUDA、HPC SDK、QE、Slurmも未導入です。他モデルの成果は流用せず、同じゴールデンOSへ戻しました。
初回は65点で止まった
最初はWeb検索なしで走らせました。Qwenは意外に進みます。ドライバー、HPC SDK、OpenACC、QE正式ソース、Slurmサービスまでは到達しました。
しかしQEのGPUバイナリ、SCF、Slurmの厳密な1GPU隔離、Slurm経由QEには届かず、検証スコアは65/100。1時間44分35秒でCodexはexit 1になりました。
大きな原因は、Web検索がないことだけではありませんでした。1M contextを設定したつもりが、Qwenのネイティブ262,144トークンをllama.cpp側で正しく拡張できていなかったのです。262,143付近でツールJSONが壊れ、サーバー500応答。表示上のmodel_context_windowだけを1Mにしても、本当の1Mにはなりません。
YaRNで1Mを通す
Qwen3.8-27Bの公式モデルカードは、ネイティブcontextを262,144、RoPE scalingで最大1,000,000へ拡張可能としています。Qwen3.8-27B model card
そこでllama.cpp側へYaRNを設定し、Codexのconfig、カスタムモデルカタログ、モデルAPI、タスク開始イベントをすべて1,010,000へ一致させました。自動圧縮しきい値は960,000、出力上限は65,536です。
本番前の合成試験では270,010入力トークンを通過。最終ランの最後は273,366トークンでtruncated=0、自動compactionは0回でした。
1Mを使い切ったわけではありません。しかし初回が壊れた262K境界を越えて、ツール利用を継続できたことは確認できました。
Tavilyを秘密のまま接続する
GPUソフトウェアの情報は変化が速く、モデルの記憶だけでは危険です。2026年のCUDA 13.2、HPC SDK 26.5、Ubuntuのドライバーパッケージを扱うなら、Web検索はほぼ必要だと考えました。
Tavily MCPをCodex CLIへつなぎました。ただし、APIキーはQwenへ渡していません。
tavily.env (mode 600)
  ↓ 管理側MCPだけが読む
local HTTP gateway
  ↓ namespace互換proxy
Codex CLI / Qwen
Qwenが見えるのは検索ツールだけです。キーはprompt、Codex config、環境変数、JSONL、記事素材へ出しません。Tavily公式MCPは検索・抽出ツールを提供しており、CodexもMCPサーバーを設定できます。Tavily MCP docs / Codex MCP docs
最終ランでQwenがTavilyを使ったのは4回だけ。CUDA 13.2の最低ドライバー、HPC SDK 26.5のリリース、ダウンロード、チェックサムを、NVIDIA公式ページで確認しました。
検索エージェントは「検索回数が多いほど賢い」のではありません。必要なところだけ調べ、一次情報へ絞り、最後はローカル実機で検証する。今回の4回はかなり良い使い方でした。
最終ランは100/100
YaRNとTavilyを有効にしたクリーン再実行は、2時間09分18秒でexit 0。外部verifierの12項目すべてに合格しました。
| 指標 | 結果 |
|---|---|
| 厳格スコア | 100/100 |
| 実行時間 | 2:09:18 |
| コマンド | 225 |
| 非0終了 | 17 |
| Tavily MCP | 4回 |
| 人間の解決ヒント | 0 |
| compaction | 0 |
| 最終context | 273,366 / truncated=0 |
実機ログでは、H100×2、driver 595.84、HPC SDK 26.5、CUDA 13.2、OpenACC使用率最大97%、QEのGPU acceleration is ACTIVE、Si SCFのJOB DONEを確認しました。
SlurmではGres=gpu:2。1GPUジョブ内はCUDA_VISIBLE_DEVICES=0で、CUDA runtimeから見えるGPUは1枚だけ。さらに同じ隔離状態でQEを実行し、PW_X_RC=0、JOB DONEまで通しました。Slurm公式文書が説明するGPUジョブ内の可視デバイス制御とも一致します。Slurm GRES
一番面白かった回復
Qwenは最初から正解したわけではありません。むしろ、かなり転びます。
OpenACC Fortranでは文法を何度も間違えました。QEでは古いCMakeオプションを試しました。system FFTWがGNUのlibgompを引き込み、NVHPCのOpenMP runtimeと衝突してpw.xがabort。Slurmでは無効な設定キー、MUNGE鍵の所有者、spool権限、SlurmUser不一致、stale stateを順番に踏みました。
Ubuntu 24.04のSlurm 23.11.4パッケージには、ドキュメント上使えるはずのgpu_nvml.soがありませんでした。Qwenは最終的にSchedMDの同版公式ソースからNVMLプラグインだけをビルドし、H100×2の自動検出を成立させました。
QEのOpenMP衝突では、NVHPCのnvc/nvfortranでFFTW 3.3.10を別ビルドし、serial OpenBLASと組み合わせてlibgompを排除しました。
このモデルの価値は「失敗しないこと」ではありません。ログから原因を絞り、同じ失敗コマンドを無限に繰り返さず、別経路へ切り替えられることです。
DS4 Q2と比べる
同じ課題を完走したDS4 2026-07-31 Q2との比較です。
| 指標 | Qwen3.8 27B Q4 | DS4 Q2 |
|---|---|---|
| 最終結果 | 成功 | 成功 |
| 時間 | 2:09:18 | 1:16:04 |
| コマンド | 225 | 143 |
| 非0終了 | 17 | 11 |
| context | 1,010,000 | 1,048,576 |
| compaction | 0 | 0 |
| 出力上限 | 65,536 | 65,536 |
| 推論GPU | A100 80GB×1 | A100 80GB×4 |
| GGUF | 18.97 GB | 86.72 GB |
Qwenは約1.70倍の時間、約57%多いコマンドを使いました。DS4の方が効率よく、短時間で完了しています。
ただし推論GPUが1枚対4枚なので、時間差をモデルだけの差とは言えません。一方、QwenのGGUFはDS4 Q2の約21.9%。19GB弱のモデルがA100 1枚で同じ最終地点へ到達した事実は、かなり魅力的です。
私の判断はこうです。
- 安価な1GPUを長く回し、監査しながら使うならQwen3.8-27Bは有力。
- 時間、安定性、少ない試行錯誤を優先するならDS4が上。
- どちらも無監督root運用ではなく、評価OS、秘密分離、許可リスト、外部verifierが必要。
「Web検索がないのが問題では?」への答え
問題です。特にドライバー、CUDA、HPC SDK、パッケージ構成のように変わり続ける領域では、検索なしはハンディキャップになります。
ただし、検索を与えれば自動的に正しくなるわけではありません。
- 一次ドメインに限定する。
- APIキーはエージェントから隔離する。
- 取得した情報とローカル環境を照合する。
- 最終成功はモデルの文章ではなく実行ログで判定する。
この4つが必要です。
また、今回はTavily追加とYaRN修正を同時に行いました。65点から100点への改善が、Tavilyだけの効果だとは言えません。厳密には、次回YaRNを固定し、Tavily ON/OFFを各3〜5回ずつ走らせる必要があります。
もっと大きいQwen3.8はあるか
あります。2026年8月時点で公式リポジトリにはQwen3.8-2.4T-A95Bがあります。総2.4兆パラメータ、1トークン当たり約95Bを活性化するMoEです。Qwen3.8 official repository
ただし、これはA100 80GB 1枚で気軽にローカル運用するモデルではありません。GPUマキシマイザーの次の試験としては、27Bを3〜5回反復し、検索効果と成功率を測る方が現実的です。
最終判断
Qwen3.8-27Bは「そこそこ使える」より上です。今回の課題では、実務的に使えました。
ただし、手放しの完全自動化ではありません。転びながら進むモデルに、正しい道具と境界を与え、機械的に採点する。そこまで含めてGPUマキシマイザーです。
27BがA100 1枚で2時間以上考え続け、別のH100×2サーバーをクリーンOSからSlurm経由QEまで仕上げた。この結果だけでも、追加検証を続ける価値は十分にあります。
再現性に関する注記
各条件1回。統計的な成功率ではありません。公開素材ではIP、GPU UUID、秘密情報を除外しています。Si SCFはGPU対応QEの機能確認用で、科学的な収束計算ではありません。
動画
YouTubeで検証動画を見る: https://www.youtube.com/watch?v=DWIZNP0ysVo
この記事への質問・感想をお寄せください
「手持ちのGPUでも試せる?」「自社の環境ではどんな構成が必要?」など、一言から歓迎します。
会員登録は不要です。記事名とURLが入ったメール作成画面が開きます。
メールアプリが開かない場合は、ken@server-gear.com 宛に記事名を添えてお送りください。お送りいただいた内容は、公開コメントには掲載されません。