A100・H100・B200で科学計算を108回測定:GPUを増やすと、どこまで速くなるか
A100・H100・HGX B200でLAMMPS、GROMACS、Quantum ESPRESSOを36条件×3回。計算時間と起動終了時間、GPU増設で速くなった条件・遅くなった条件を、全108回の数値と再現情報で紹介。
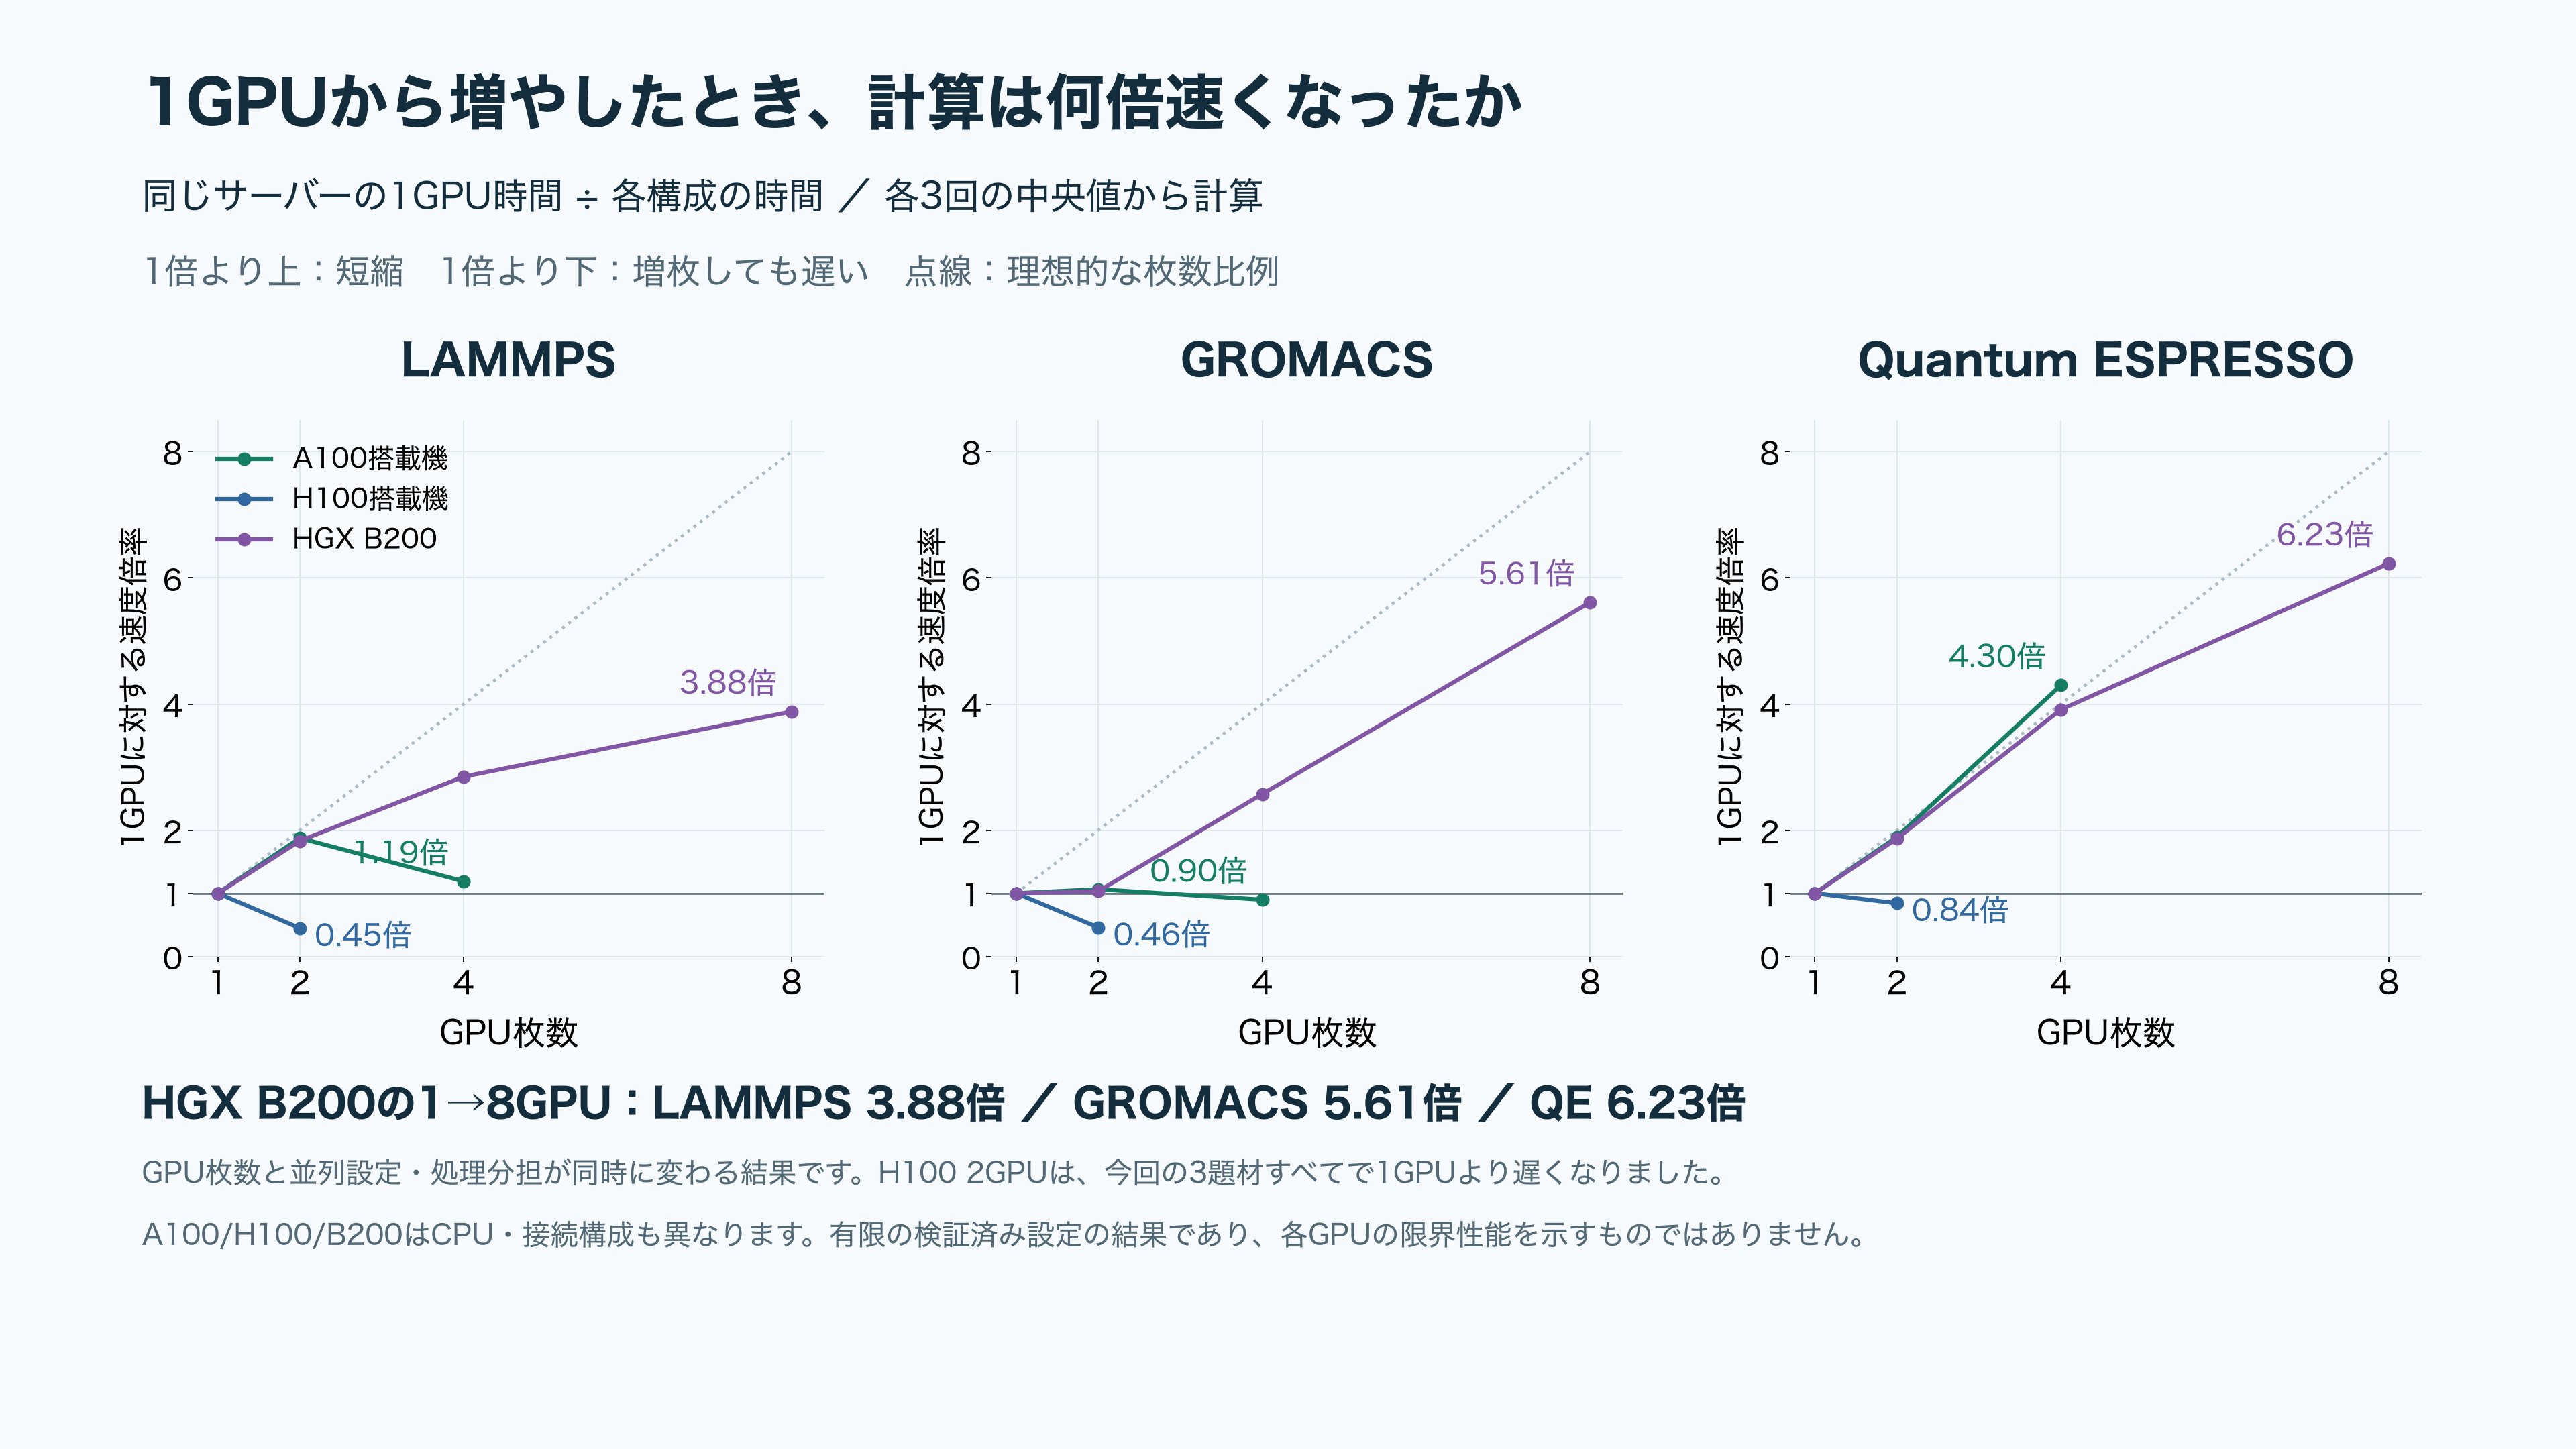
GPUを増やせば、科学計算は必ず速くなるのでしょうか。A100搭載機、H100搭載機、HGX B200で、LAMMPS・GROMACS・Quantum ESPRESSOを計108回測定しました。B200では1GPUから8GPUへの増設で、三つの題材の計算速度が約3.88〜6.23倍になりました。一方、今回採用したH100の2GPU条件は、三つとも1GPUより遅くなりました。
以下は、入力と事前の品質基準を揃えて選んだ実行条件の比較です。CPU、通信構成、ビルド、並列化設定も異なるため、GPUチップだけの優劣や、増設だけの因果効果を切り分けた結果ではありません。
YouTubeで見る(Marin日本語合成音声・4K・字幕)
何を、どの条件で測ったか
| サーバー | 搭載GPU | CPU | CPUのみで使用した物理コア |
|---|---|---|---|
| A100搭載機 | A100 80GB PCIe ×4 | Intel Xeon Gold 6430 ×2 | 64 |
| H100搭載機 | H100 80GB PCIe ×2 | AMD EPYC 9354P ×1 | 32 |
| HGX B200 | B200 ×8、GPU間NVLink | AMD EPYC 9575F ×2 | 128 |
GPU 1枚、2枚、4枚、8枚のうち、各サーバーに搭載された枚数までを測定しました。CPUのみを含めて1アプリ12条件、3アプリ36条件を各3回、合計108回です。掲載版はLAMMPS 30 Sep 2026、GROMACS 2026.4、Quantum ESPRESSO 7.6で固定しました。
| アプリケーション | 入力と規模 | 主に比べる計時区間 |
|---|---|---|
| LAMMPS | Cu EAM、2,048,000原子、FP64 | 準備1,000ステップ後の30,000ステップ。刻み0.005 ps、近接リスト every 1 / delay 0 / check yes |
| GROMACS | benchPEP-h、12,495,503原子 | 総11,000ステップ、1,000で計時リセット。名目10,000ステップ・20 ps |
| Quantum ESPRESSO | PSIWAT、586原子、2,040バンド、4 k点、FP64 | 初期化、収束までの全SCF反復、力計算を含むPWSCF時間。毎回初期状態から実行 |
GROMACSはCPUが倍精度、GPUが混合精度です。事前のエネルギー・力の基準を通過した条件を比較しており、CPUからの速度差には精度設定の違いも含みます。GPU使用時もCPUが処理の一部を担います。
代表値は3回の中央値、括弧は最小〜最大です。最速の1回だけを選んでいません。図と表の「計算区間」はアプリケーションが出力した実時間です。準備運転やMPIの起動・終了を含む「起動から終了」も別列で示します。異なるアプリケーションの時間を合算した総合スコアは作っていません。
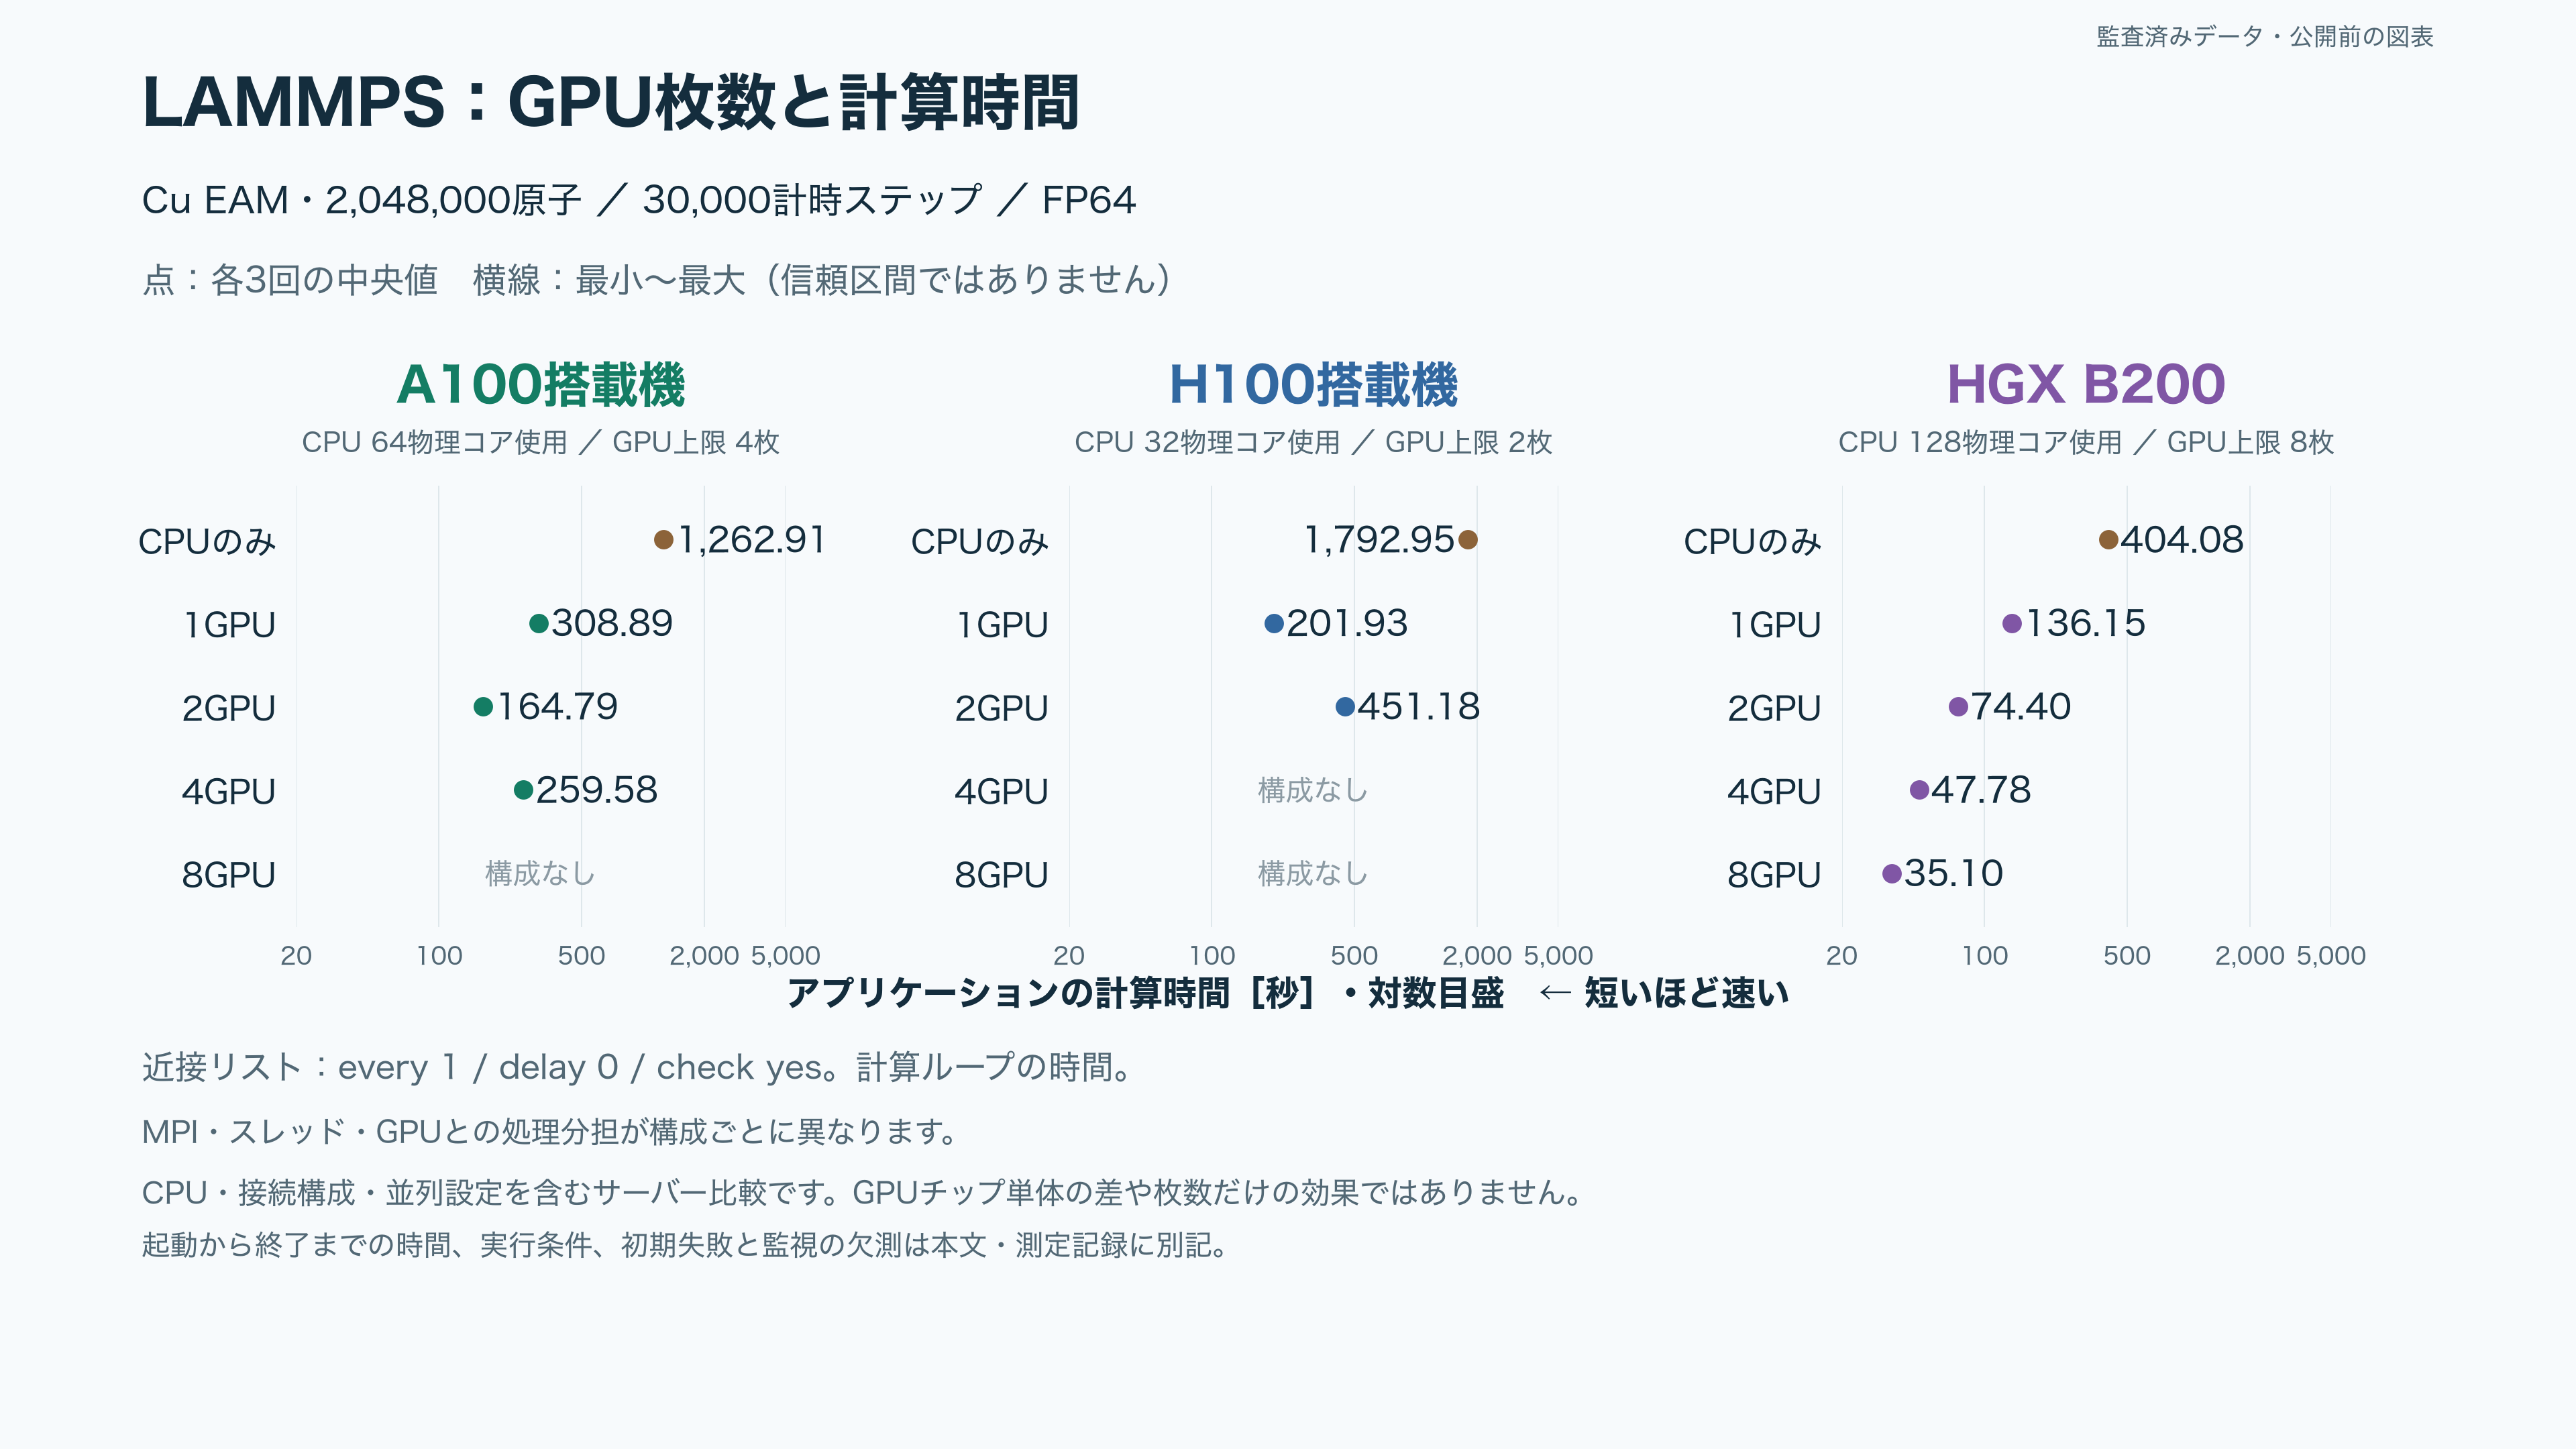
LAMMPS:B200は8GPUまで短縮、A100は2GPUが最短
| 構成 | 計算区間:中央値(最小〜最大)秒 | 起動から終了:中央値(最小〜最大)秒 |
|---|---|---|
| A100搭載機・CPUのみ | 1,262.91(1,262.23〜1,264.31) | 1,318.68(1,318.38〜1,320.12) |
| A100搭載機・1GPU | 308.89(308.75〜310.73) | 323.41(323.20〜325.36) |
| A100搭載機・2GPU | 164.79(163.50〜165.75) | 173.46(172.13〜174.48) |
| A100搭載機・4GPU | 259.58(258.72〜260.01) | 276.29(275.49〜276.75) |
| H100搭載機・CPUのみ | 1,792.95(1,792.31〜1,793.72) | 1,854.49(1,853.96〜1,855.33) |
| H100搭載機・1GPU | 201.93(201.59〜202.19) | 212.67(212.31〜213.02) |
| H100搭載機・2GPU | 451.18(450.98〜451.63) | 469.43(469.15〜469.86) |
| HGX B200・CPUのみ | 404.08(403.91〜404.18) | 490.82(487.73〜491.48) |
| HGX B200・1GPU | 136.15(136.12〜136.18) | 143.99(143.99〜143.99) |
| HGX B200・2GPU | 74.40(74.39〜74.40) | 81.09(80.94〜81.14) |
| HGX B200・4GPU | 47.78(47.70〜48.21) | 56.35(56.25〜56.85) |
| HGX B200・8GPU | 35.10(35.06〜35.14) | 51.03(50.68〜51.09) |
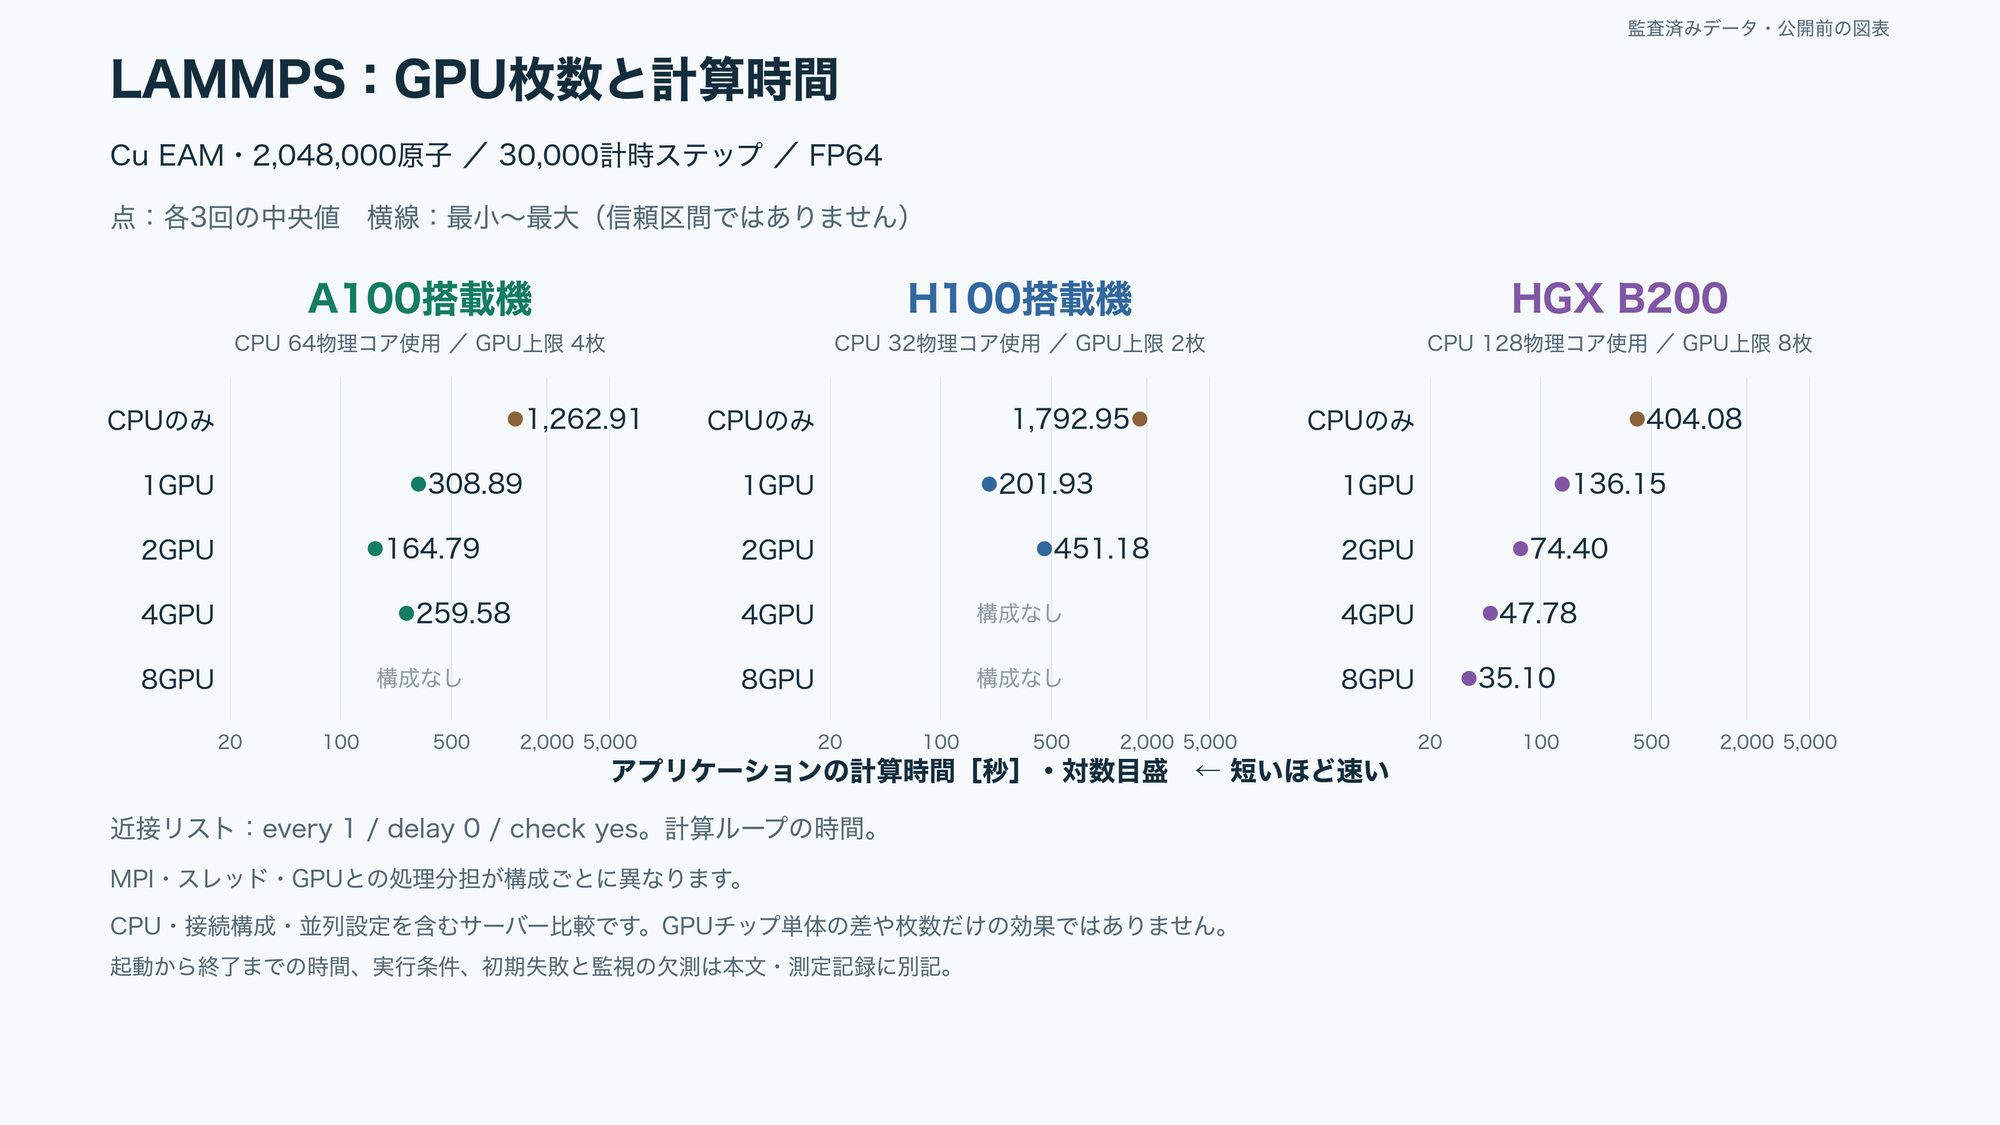
A100では1GPUの308.89秒から2GPUの164.79秒へ短縮しましたが、4GPUは259.58秒でした。H100では1GPUの201.93秒に対し2GPUは451.18秒です。B200では1GPUの136.15秒から8GPUの35.10秒へ短縮し、約3.88倍の速度になりました。
A100の4GPUはGPUパッケージ、ほかのA100 GPU条件はKokkosです。H100の1GPUと2GPUにも実装・通信設定の違いがあります。今回の候補から品質条件を満たした設定を選んだ比較であり、GPU枚数だけで遅くなった原因を説明することはできません。
初期のdelay 5条件では近接リスト更新の警告を検出しました。その記録を残し、全ホストでdelay 0の条件に揃えて、品質確認と本測定を実施しました。最終36回では該当警告は0です。長時間のエネルギー・温度も診断値として確認しましたが、後半の原子位置の完全一致や、測定後に追加した閾値での合否判定は行っていません。
H100の旧CPU条件は2回成功後、3回目が時間切れになりました。短時間の品質試験を通過したUCC無効化設定で新たに3回測定し、旧条件の成功2回と混ぜず集計しました。原因がUCCだったと確定したものではありません。新CPU測定はGPU測定後の連続ブロックで、実行順序を無作為化していません。
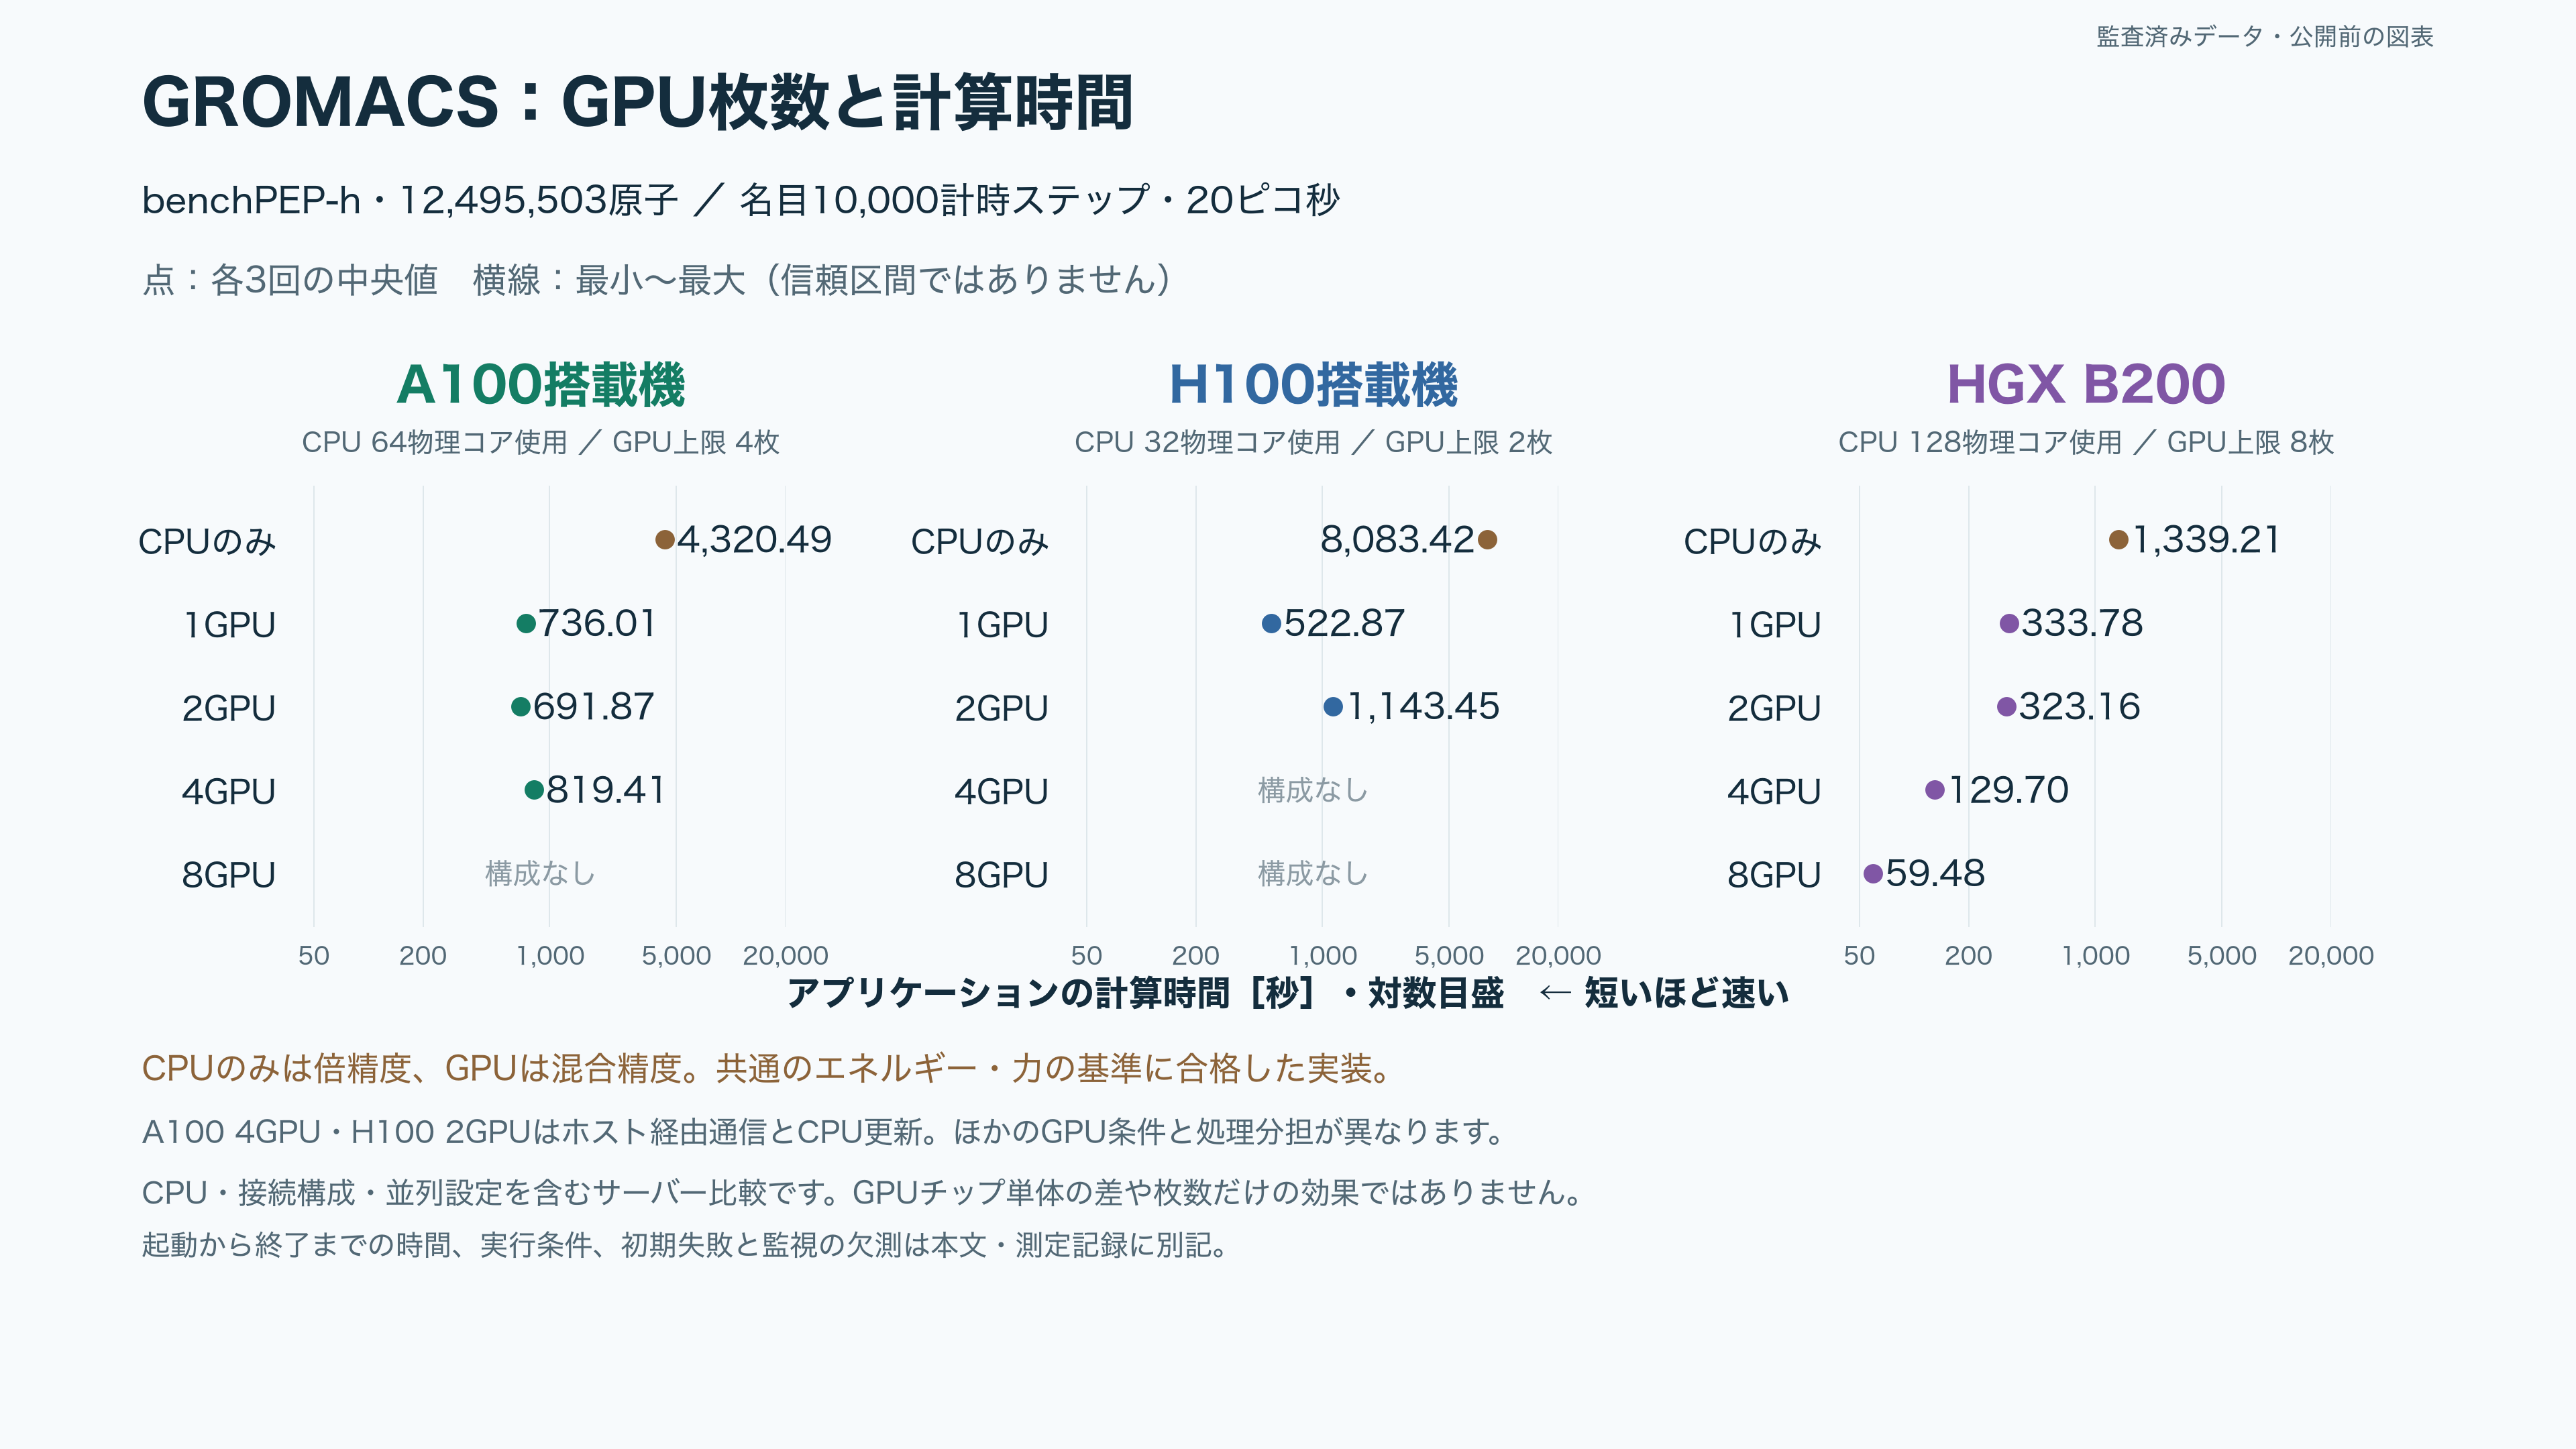
GROMACS:B200でも1GPUから2GPUの効果は小さい
| 構成 | 計算区間:中央値(最小〜最大)秒 | 起動から終了:中央値(最小〜最大)秒 |
|---|---|---|
| A100搭載機・CPUのみ | 4,320.49(4,317.45〜4,340.32) | 4,771.81(4,770.12〜4,793.67) |
| A100搭載機・1GPU | 736.01(735.60〜736.24) | 820.62(820.26〜821.42) |
| A100搭載機・2GPU | 691.87(688.64〜693.11) | 776.66(773.28〜777.61) |
| A100搭載機・4GPU | 819.41(817.65〜820.74) | 916.34(914.37〜917.74) |
| H100搭載機・CPUのみ | 8,083.42(8,080.79〜8,085.65) | 8,909.32(8,906.50〜8,912.13) |
| H100搭載機・1GPU | 522.87(522.72〜523.39) | 586.39(586.31〜586.94) |
| H100搭載機・2GPU | 1,143.45(1,141.72〜1,145.66) | 1,272.82(1,270.96〜1,275.18) |
| HGX B200・CPUのみ | 1,339.21(1,338.16〜1,339.56) | 1,554.36(1,552.54〜1,554.66) |
| HGX B200・1GPU | 333.78(333.77〜333.83) | 375.30(375.25〜375.39) |
| HGX B200・2GPU | 323.16(323.07〜323.19) | 367.54(367.53〜367.54) |
| HGX B200・4GPU | 129.70(129.61〜129.74) | 157.75(157.70〜157.95) |
| HGX B200・8GPU | 59.48(59.40〜59.55) | 88.78(88.57〜88.98) |
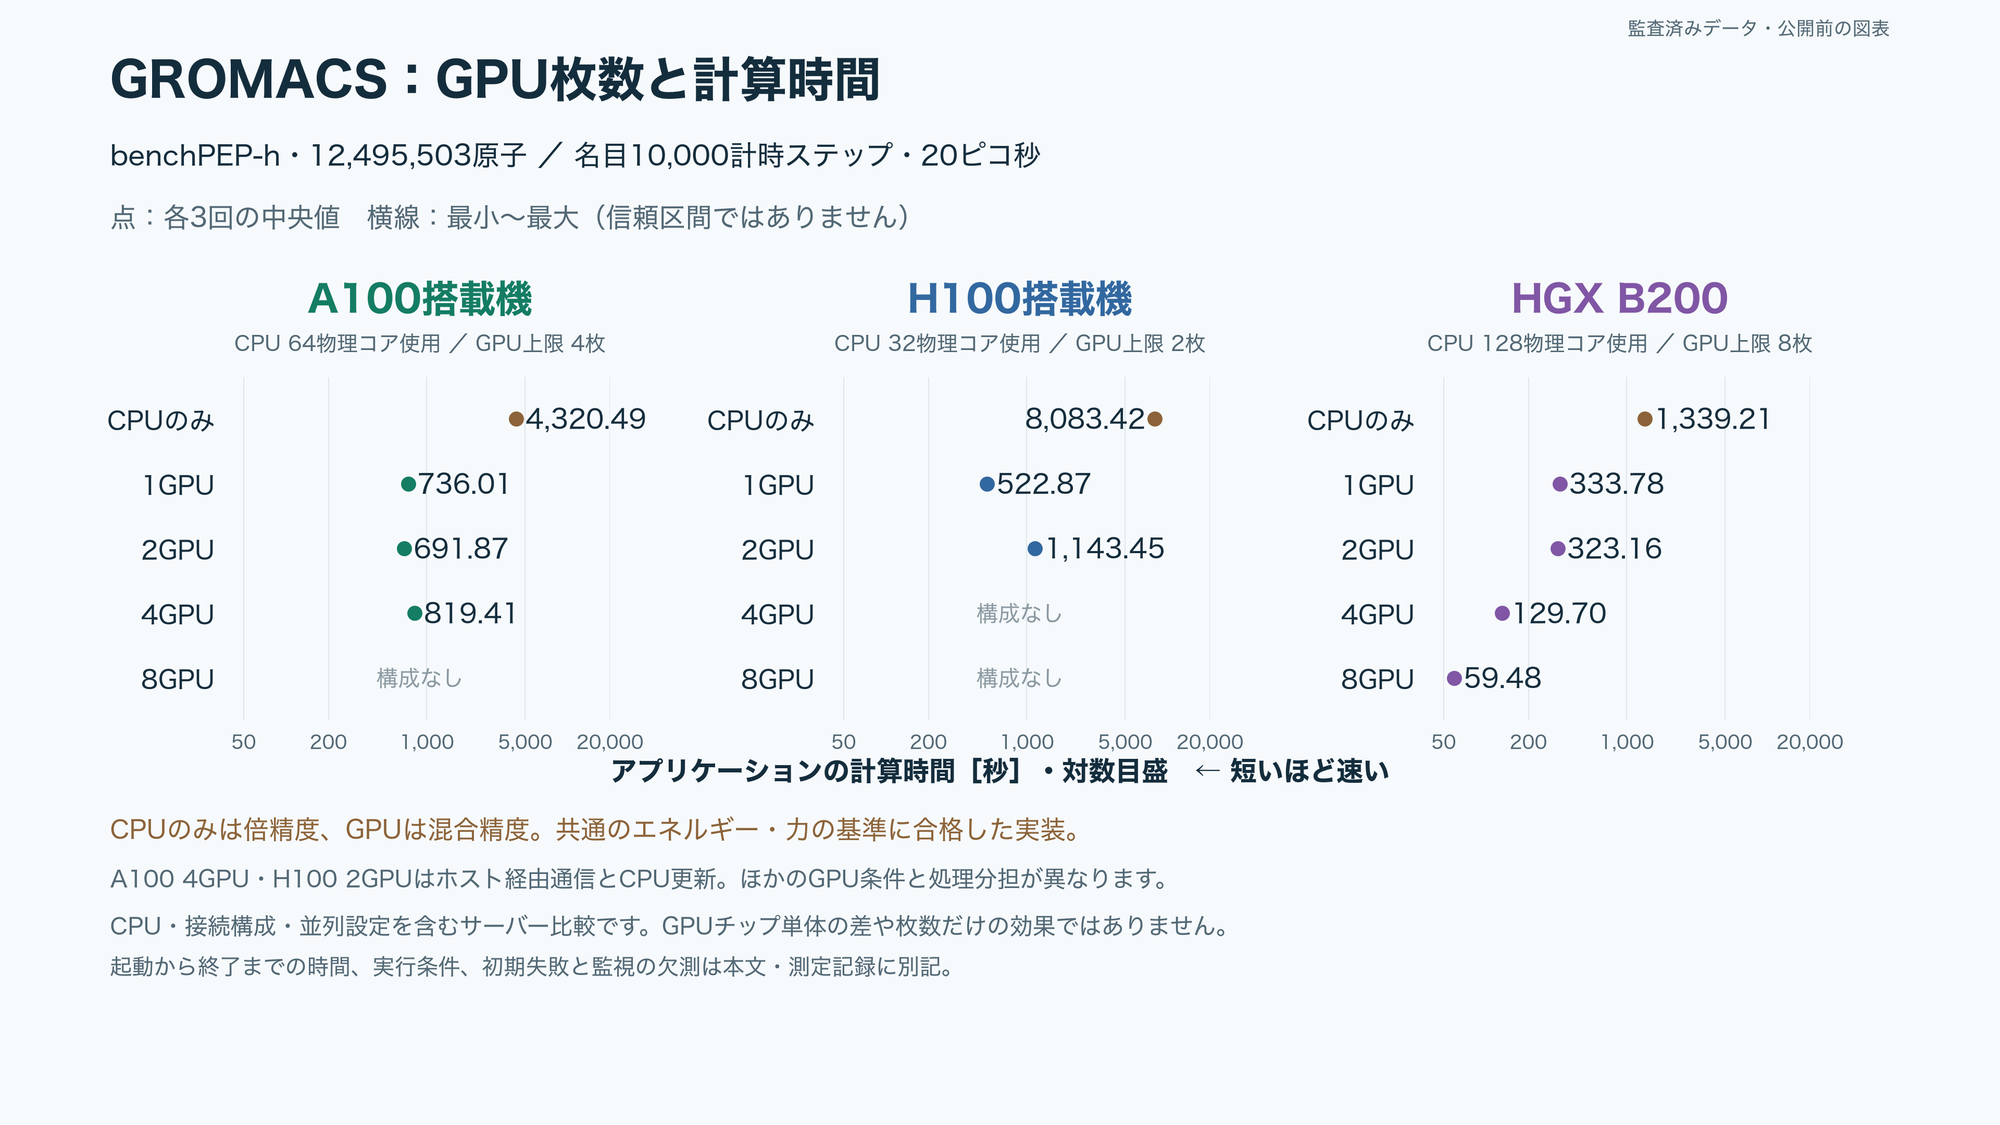
A100では2GPUが691.87秒で、1GPUの736.01秒に対して約1.06倍の速度でした。4GPUは819.41秒で、1GPUより遅くなりました。H100の2GPUも1GPUより長く、所要時間は約2.19倍です。
B200では1GPUの333.78秒から2GPUの323.16秒への変化は小さい一方、4GPUでは129.70秒、8GPUでは59.48秒となりました。1GPUから8GPUへの倍率は約5.61倍です。枚数に比例した伸び方ではありません。
A100の4GPUとH100の2GPUはGPU間通信をホストメモリ経由にし、MD更新をCPUで実行しました。他のGPU条件はGPUでMD更新を行っています。PMEの分担やMPI・スレッド数も変わるため、通信方式一つを原因と断定しません。
固定座標での事前基準は、エネルギー相対差10⁻⁴以下、力の正規化RMS差10⁻³以下です。本測定では、印字された開始・終了時の温度、エネルギー、拘束誤差が有限で、正常終了したことも照合しました。丸められた診断値によって、完全な軌跡の一致や長時間の物理的妥当性を証明したという意味ではありません。CPUの初期の混合精度試験には不合格があり、その証拠も保持しています。
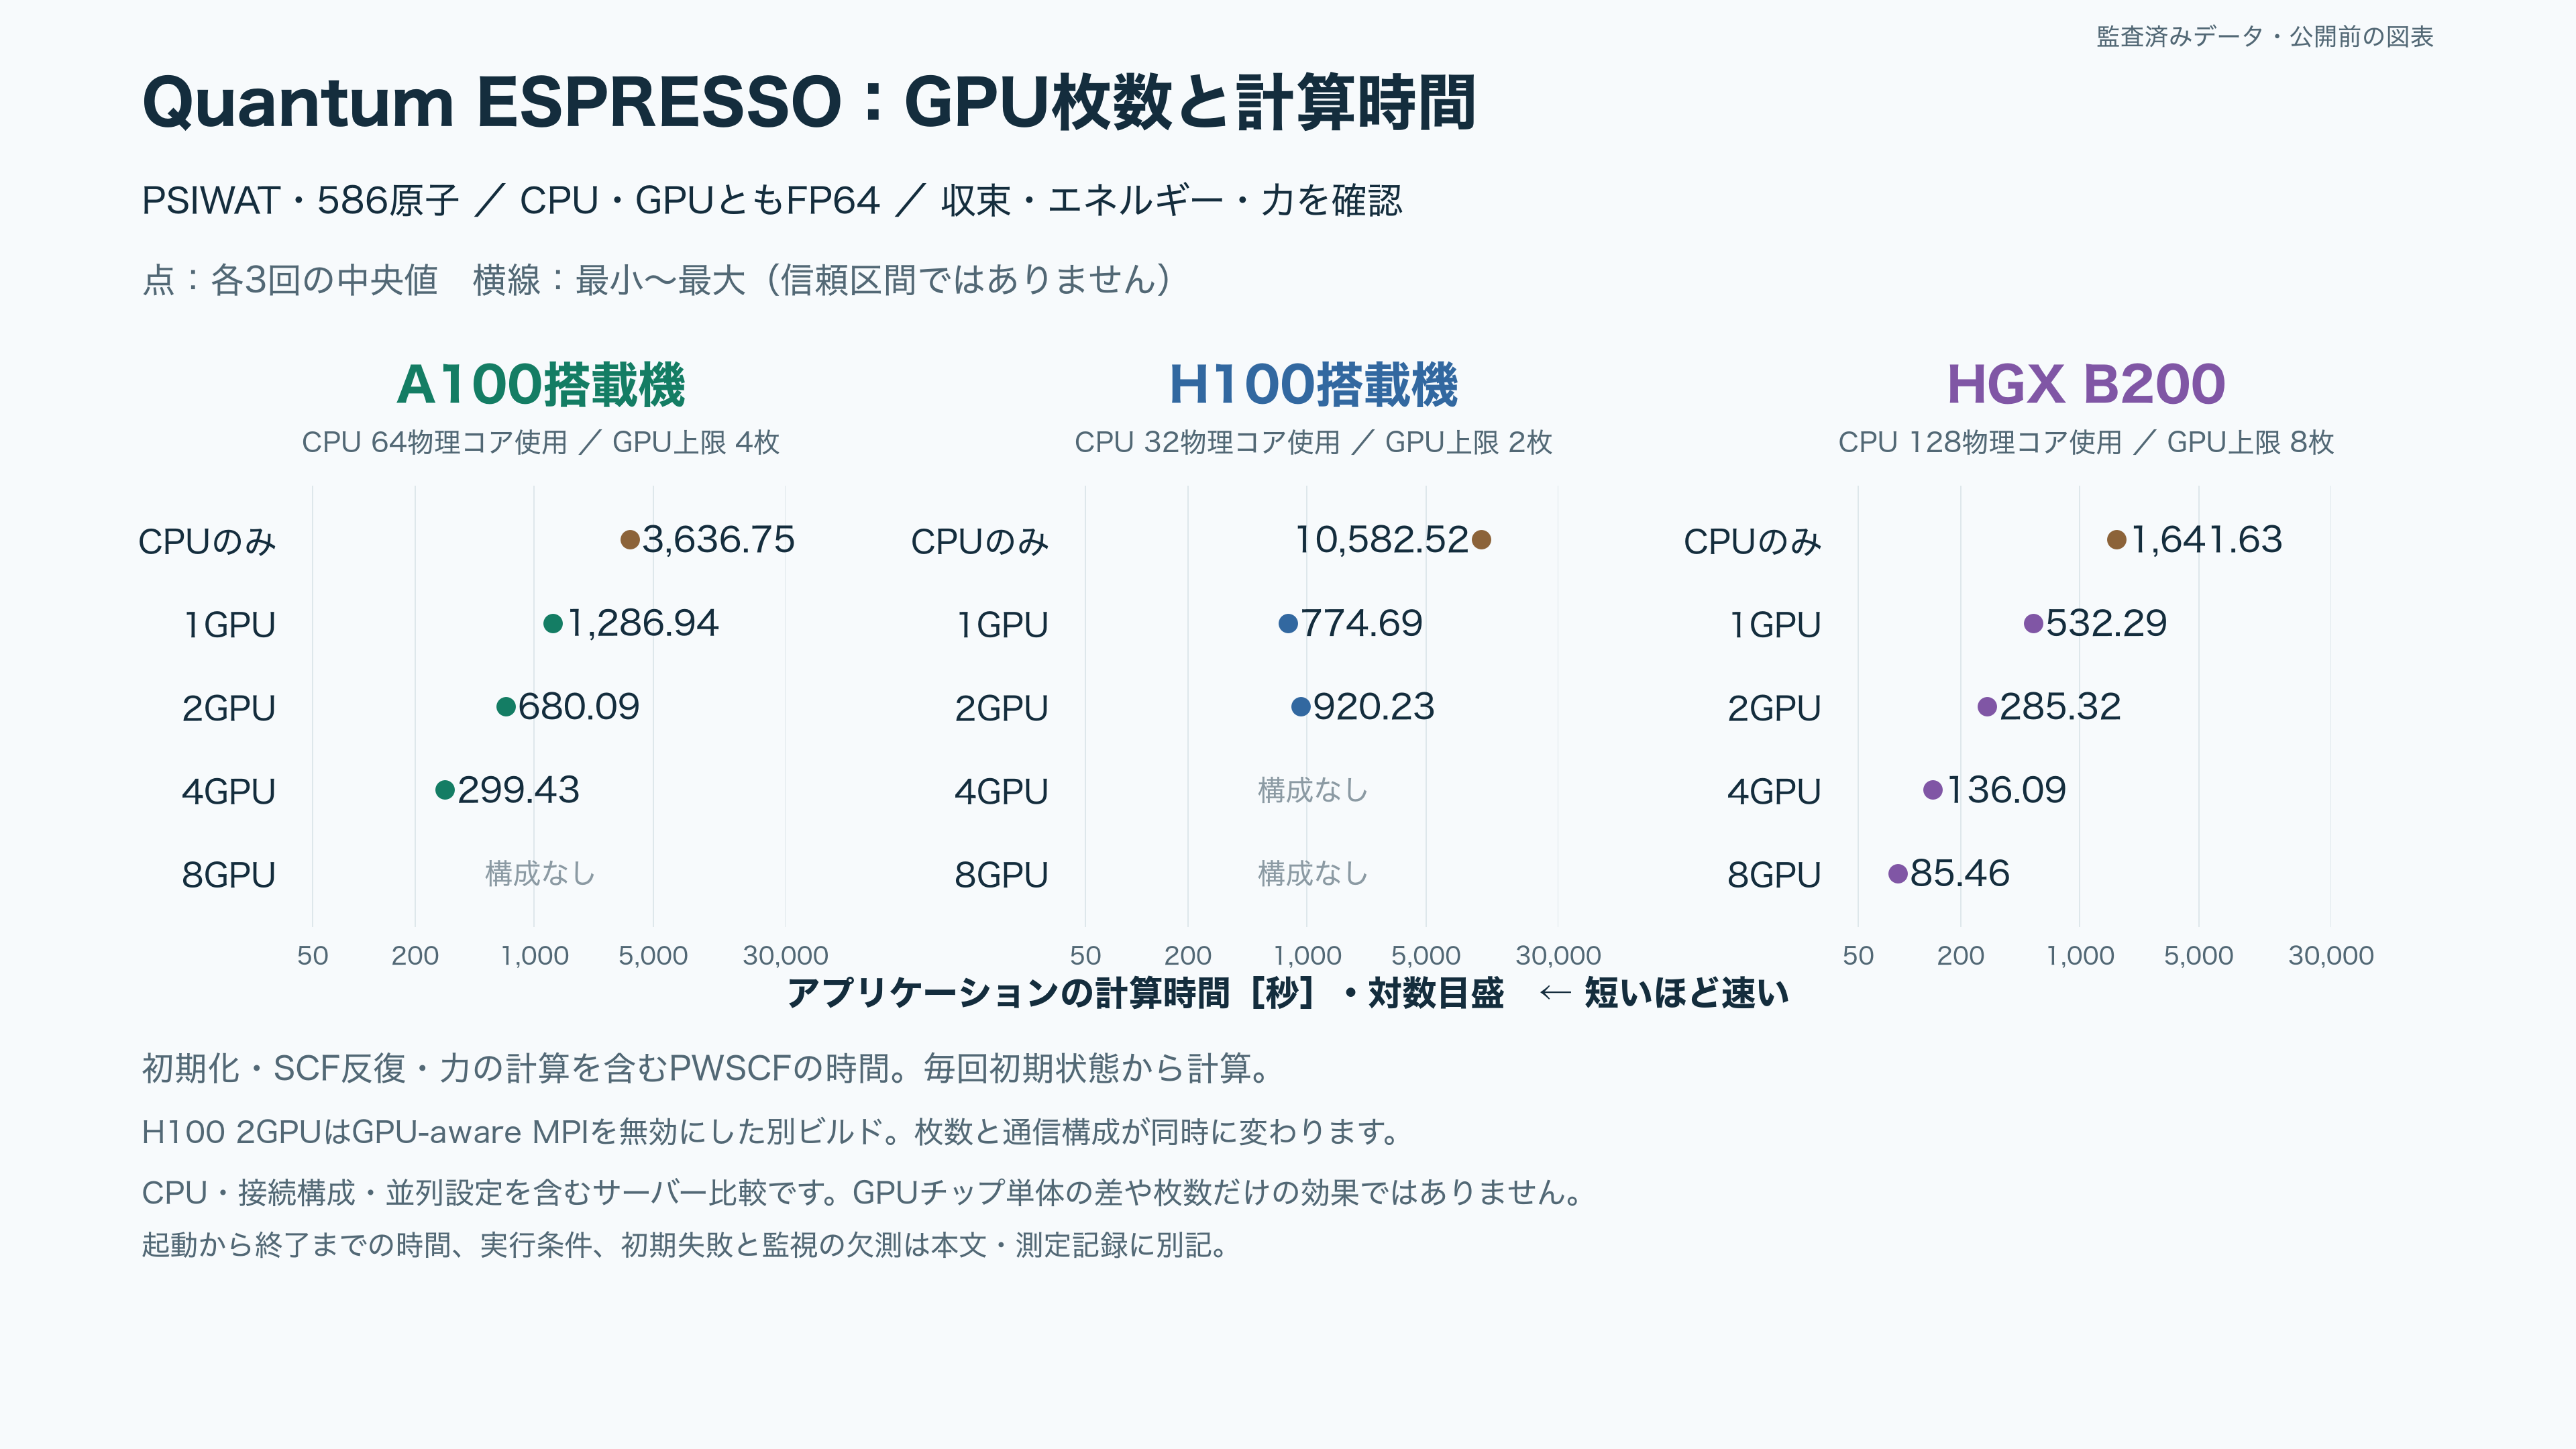
Quantum ESPRESSO:A100の4GPUは約299秒、B200の8GPUは約85秒
| 構成 | 計算区間:中央値(最小〜最大)秒 | 起動から終了:中央値(最小〜最大)秒 |
|---|---|---|
| A100搭載機・CPUのみ | 3,636.75(3,634.07〜3,642.97) | 3,650.20(3,647.51〜3,656.48) |
| A100搭載機・1GPU | 1,286.94(1,283.26〜1,288.88) | 1,289.09(1,285.35〜1,290.96) |
| A100搭載機・2GPU | 680.09(679.94〜680.52) | 682.57(682.39〜683.01) |
| A100搭載機・4GPU | 299.43(299.43〜299.69) | 302.65(302.55〜302.86) |
| H100搭載機・CPUのみ | 10,582.52(10,538.18〜10,586.08) | 10,586.60(10,542.21〜10,590.14) |
| H100搭載機・1GPU | 774.69(772.60〜775.04) | 776.90(774.72〜777.17) |
| H100搭載機・2GPU | 920.23(898.16〜920.63) | 922.89(900.83〜923.28) |
| HGX B200・CPUのみ | 1,641.63(1,637.86〜1,649.48) | 1,715.76(1,711.62〜1,720.91) |
| HGX B200・1GPU | 532.29(530.75〜532.82) | 534.50(532.99〜535.05) |
| HGX B200・2GPU | 285.32(284.28〜285.99) | 289.05(287.95〜289.76) |
| HGX B200・4GPU | 136.09(135.89〜138.91) | 142.92(142.52〜145.68) |
| HGX B200・8GPU | 85.46(85.08〜85.80) | 99.90(99.29〜99.92) |
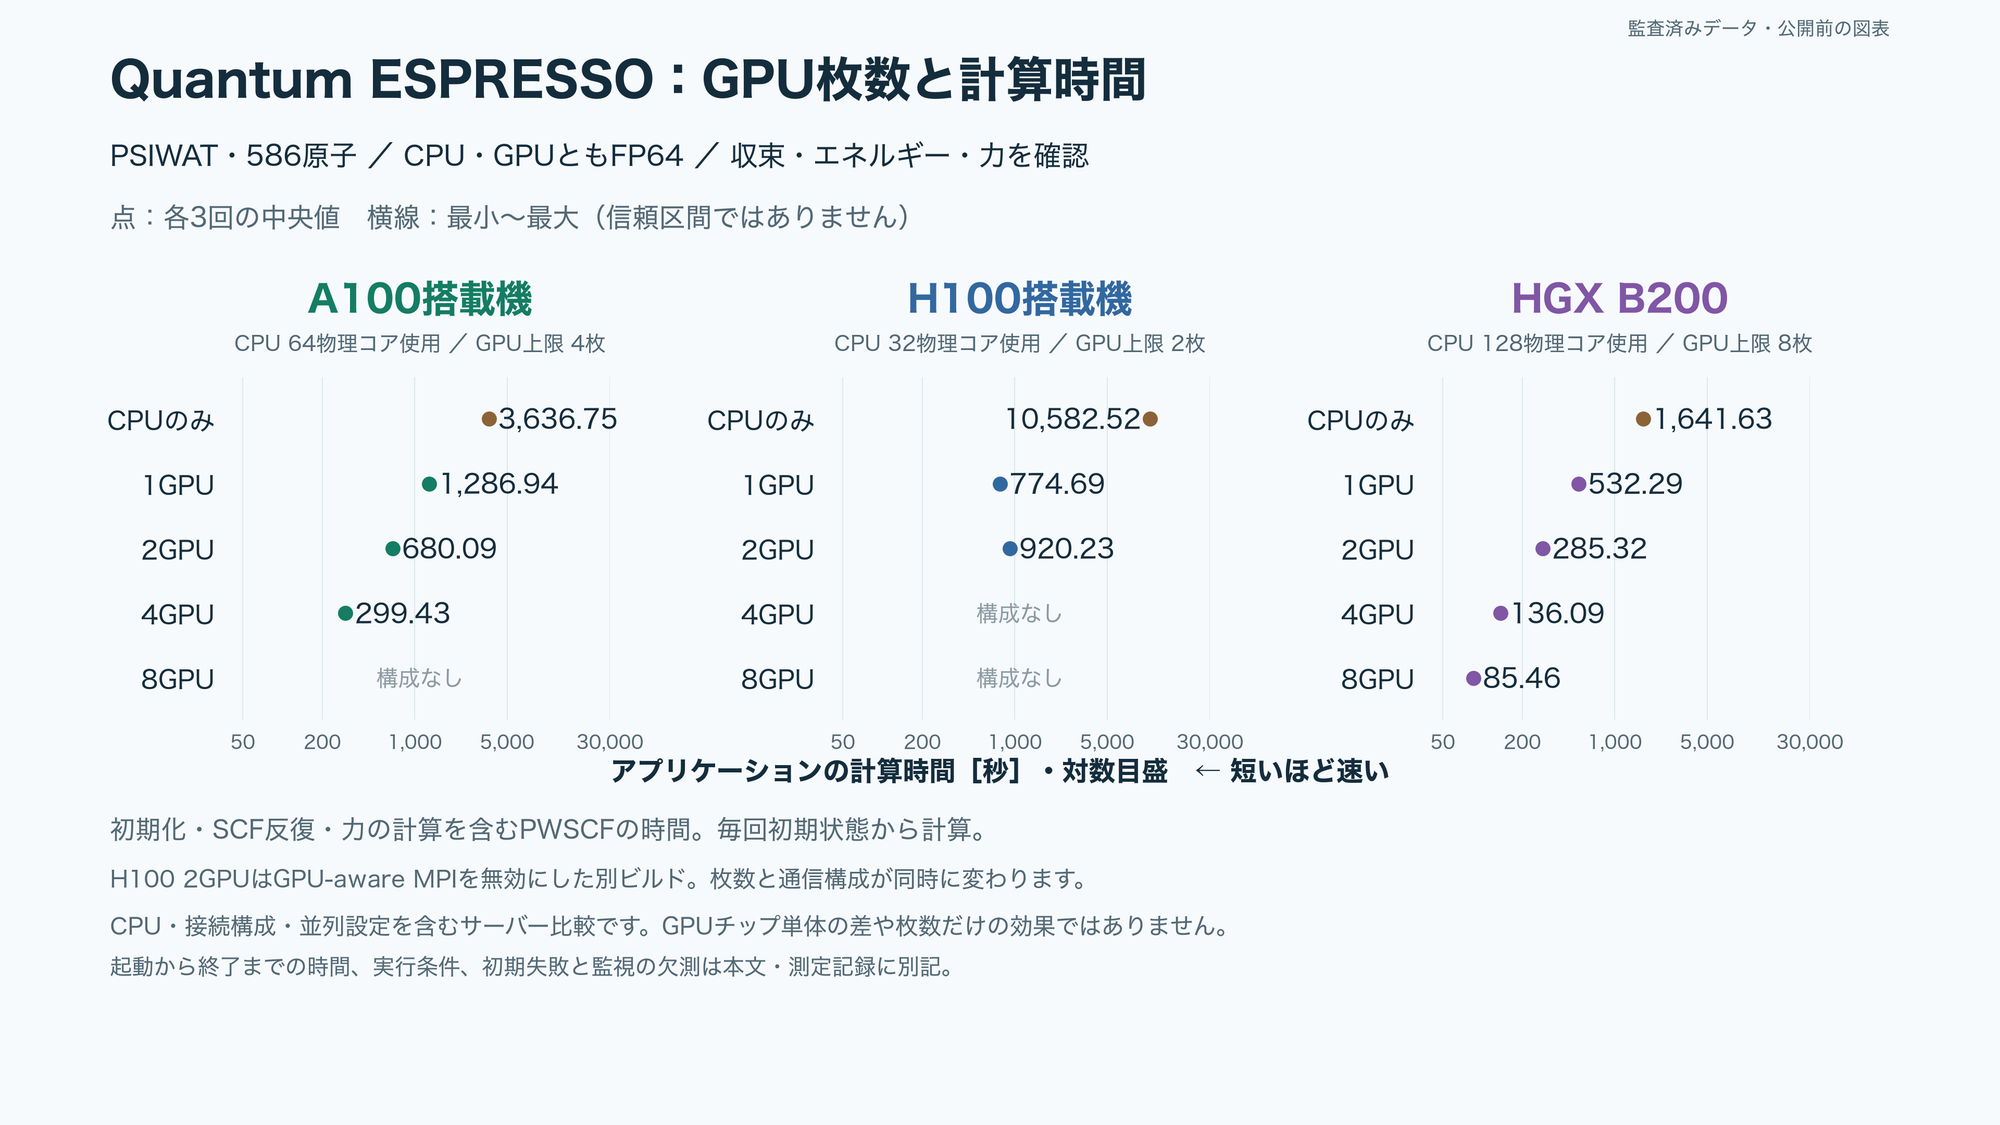
全36回が41回のSCF反復で収束しました。A100は1GPUの1,286.94秒から4GPUの299.43秒へ短縮し、約4.30倍の速度です。GPU枚数を上回る倍率ですが、MPI数やk点プール数なども同時に変わるため、GPUだけの理想的な比例性能を意味しません。B200は1GPUの532.29秒から8GPUの85.46秒へ短縮し、約6.23倍になりました。
H100の1GPUは774.69秒、2GPUは920.23秒でした。2GPUの3回は920.23、898.16、920.63秒で、中央値では1GPUより約18.8%長くかかっています。2GPUではGPU-aware MPIを無効にした隔離ビルドを使い、2 MPI・各1スレッド・1プール、UCC無効の設定です。1GPUとビルド・MPI構成が異なり、性能差をGPU増設だけの効果と扱うことはできません。
2GPU本測定の前に、5SCFの実行費用確認と、収束・エネルギー・力の検証を別々に実施しました。5SCF完走を収束とみなしたり、その時間を41SCFへ比例外挿したりしていません。最終H100 2GPUの最大差はエネルギー約6.83×10⁻¹¹ Ry/atom、力の成分約4.0×10⁻⁸ Ry/bohrで、事前基準の10⁻⁷、10⁻⁶を満たしました。
初期の未収束・実行失敗や、途中の固有値、IEEE浮動小数点、UCX、MPIバインドに関する警告も残しています。H100のCPU測定にはMPIバインド警告があり、CPUの性能差の解釈にも留保が必要です。途中の警告と、最終SCF収束・エネルギー・力の判定を分けています。
GPU増設の効果は、アプリケーションごとに見る
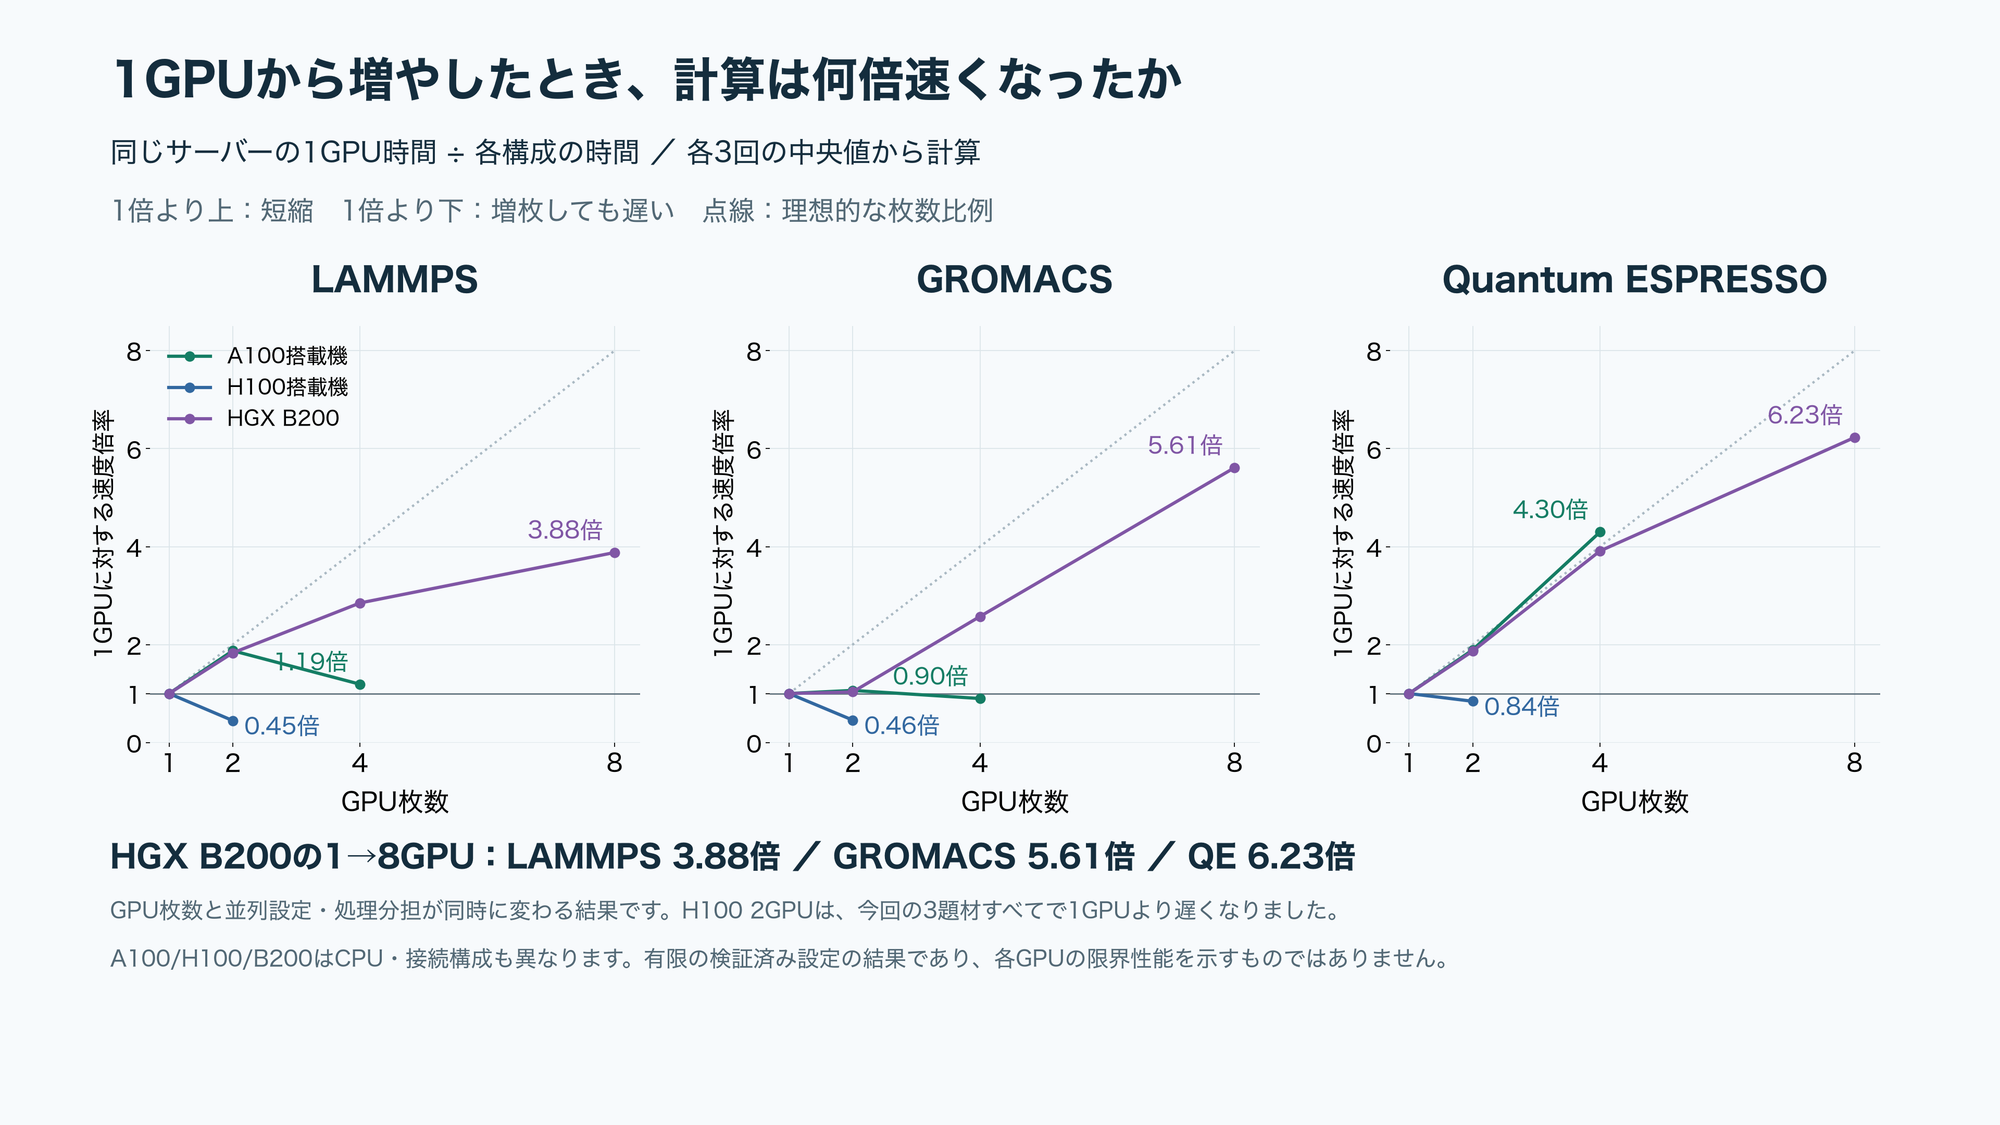
この図の基準は、各サーバー自身の1GPUです。B200の1GPUから8GPUは、LAMMPS約3.88倍、GROMACS約5.61倍、Quantum ESPRESSO約6.23倍でした。起動から終了の時間で比べると倍率は小さくなります。例えばB200のLAMMPSは143.99秒から51.03秒で約2.82倍です。
今回のA100ではLAMMPS・GROMACSは2GPU、Quantum ESPRESSOは4GPUが最短でした。H100は三つとも1GPUが最短でした。構成相談では、使用ソフト、実際の入力規模、並列設定を揃えた試験が役立ちます。複数の独立ジョブを同時実行する処理能力は、この単一計算の増設試験では測定していません。
入力の出典と実行環境
ソフトウェアは測定時に固定した LAMMPS 30Sep2026、GROMACS 2026.4、Quantum ESPRESSO 7.6 です。後日更新される「最新版」と混同しないよう、ソースの版・ハッシュ・実入力のSHA256を公開用再現条件データに掲載しました。MPI数・スレッド数・更新方式など、全36条件の設定も含みます。
| 入力 | 出典・ライセンスの区別 |
|---|---|
| LAMMPS Cu EAM | LAMMPS配布物のCu_u3.eamと、生成した銅モデル。ソフト本体はGPL v2。入力とポテンシャルのSHA256を掲載。 |
| GROMACS benchPEP-h | Max Planck研究所の公開ベンチマーク。ソフト本体はLGPL 2.1以降。入力にはソフト本体のライセンスを自動適用せず、提供元から取得する形式とし、記事ではバイナリを再配布しません。 |
| QE PSIWAT | QEF benchmarksの固定コミット。同リポジトリの表示はMIT、QE本体はGPL v2。収束まで測るためelectron_maxstepを200とした実入力のSHA256を掲載。 |
| 記録した条件 | A100搭載機 | H100搭載機 | HGX B200 |
|---|---|---|---|
| ドライバー | 595.99.02 | 595.91.07 | 595.91.07 |
| 各GPUの電力上限(事前観測) | 300 W | 350 W | 1,000 W |
| GPU接続(nvidia-smi topoの表示) | 0–1と2–3はNV12、ペア間はSYS | 0–1はPHB | 全ペアNV18 |
| GROMACS C/C++コンパイラ | GNU 13.3.0 | GNU 13.3.0 | GNU 14.2.0 |
| GROMACS CUDAコンパイラ | 13.2.78 | 13.2.78 | 13.1.80 |
| GROMACS SIMD | AVX-512 | AVX2-256 | AVX-512 |
| NVIDIA HPC SDK / HPC-X | 26.5 / 2.50 | 26.5 / 2.50 | 26.1 / 2.25.1 |
| QE C/Fortran | nvc/nvfortran(SDK 26.5) | nvc/nvfortran(SDK 26.5) | nvc/nvfortran(SDK 26.1) |
| QE BLAS/ScaLAPACK | oneMKL 2026.0 | OpenBLAS 0.3.34 / ScaLAPACK 2.2.3 | OpenBLAS 0.3.34 / ScaLAPACK 2.2.3 |
GROMACS本体が出力したMPI版はOpen MPI 4.1.9a1で、配布物はHPC-Xに同梱の開発版と表示されています。A100/H100とB200ではリビジョンも異なります。表の電力上限は平均消費電力ではなく、今回の記事で電力効率を順位付けする材料には使いません。NV12/NV18はNVLink接続、PHBはPCIeホストブリッジ経由、SYSはNUMA間を含む接続の表示です。物理接続の表示だけで、各アプリケーションが常に直接GPU通信を使ったと判断することもできません。
再現情報と確認範囲
36条件・全108回の計算時間と起動終了時間、並列設定のデータを用意しました。図・表・動画の数値は、同じ監査済み共通データから作成しています。入力ハッシュと全試行を含み、初期エラーや未採用条件の元証拠は別に保持しています。公開用データには接続情報やprivate inspectは含めません。
GPU監視は連続した完全記録ではありません。GROMACSではB200の問い合わせ失敗6件と終了直前のプロセス名不明区間、A100にも終了直前の不明区間がありました。他のアプリにも監視欠測を保持しています。全時間の独占利用を証明したとは扱いません。
今回試した有限の候補から選んだ結果であり、全設定を探索した最高性能や、別問題での同じ倍率を保証するものではありません。入力・ビルド・電力上限・接続構成の差を含む、今回の測定条件に限った結果です。
動画とGPUサーバーのご相談
動画では、同じ4枚の図から、CPUのみの時間、1GPUの時間、増設後の時間を順に説明します。全108回の数値・実行条件をこの記事に、概要と図表の読み方をYouTube動画に掲載しています。
使用するアプリケーションと版、計算規模、現在の所要時間、希望する完了時間、同時に実行したいジョブ数をお知らせください。GPUサーバーの構成相談・お見積もりを受け付けています。
関連するLLMの実測:GLM-5.3-Flashのエンジン・MTP比較
4K図表のダウンロード
記事中の表示画像は配信時に縮小されるため、元の3840×2160画像も保存しています。