A100 80GB 1枚でDeepSeek V4.1 Flash 1017 Q2を実測|DwarfStarの回答品質と待ち時間
科学的推論20問が完了し、数値照合は12/12。一方、回答完了は中央値73秒。短問の5並列は中央値269秒、10セッションは起動時に停止しました。B200との比較条件と全回答を公開します。
2026年11月1日実測。各条件の最初の結果を保存して比較しています。
DeepSeek V4.1 Flash 1017を、小さいGPU構成でどこまで使えるのか。DwarfStarとQ2版を使い、A100 80GBを1枚だけ使用して、以前HGX B200 8GPUで解いた科学的推論20問を実行しました。20問すべてが完了し、数値の自動照合は12問中12問が合格しました。一方、回答完了は中央値73.0秒、最長452.2秒。回答の中身だけでなく、待ち時間まで含めて用途を考える必要があります。
日本語ナレーション付き動画を見る(日本語字幕はCCで表示できます)
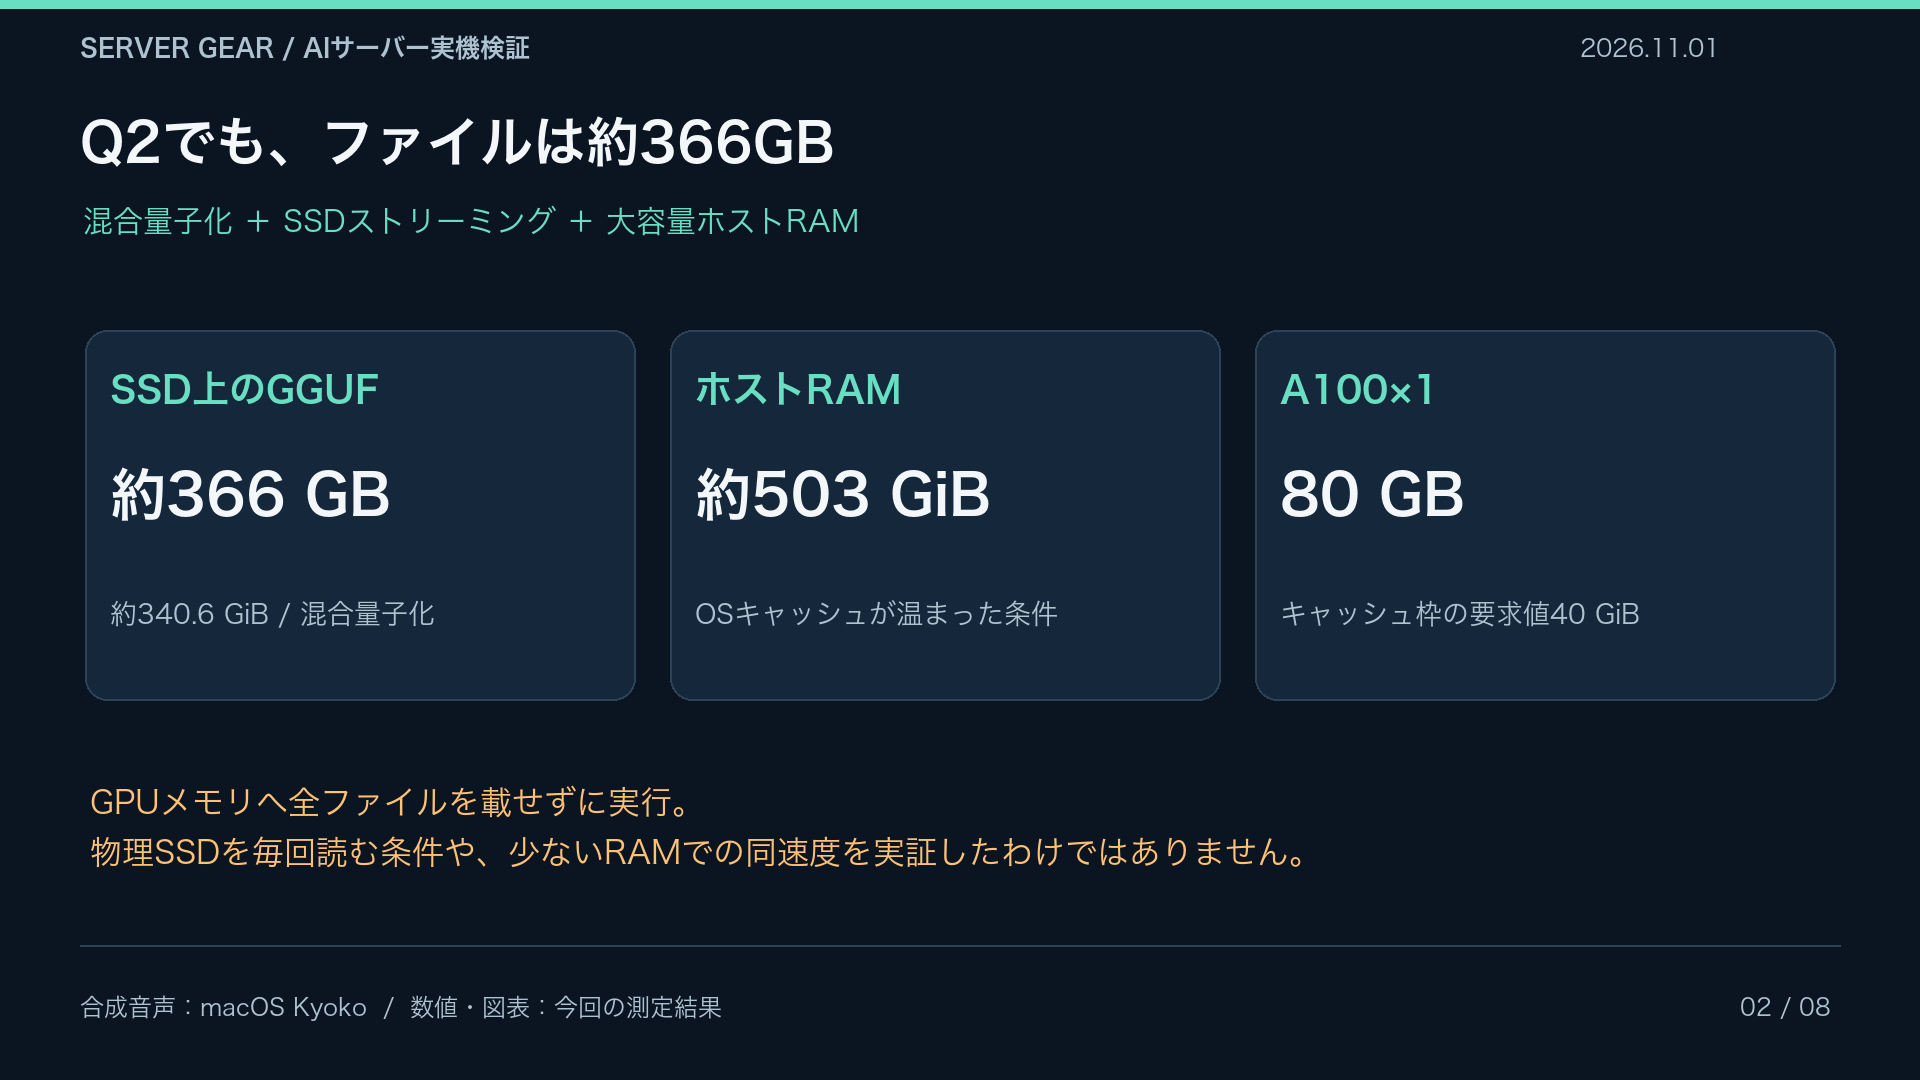
Q2でも約366GBある理由
使用ファイルは DeepSeek-V4.1-Flash-1017-IQ2_XXS-Q2_K-imatrix.gguf、365,713,686,528バイト、約340.6GiBです。Q2は全パラメータを均一に2ビットへ変換した形式ではありません。ファイル内のメタデータでは、エキスパートのgate/upがIQ2_XXS、downがQ2_K、attention・shared・headはQ8_0です。Engramテーブルなども含むため、ファイル全体は大きいままです。
DwarfStarのSSDストリーミングを利用し、一部の重みをGPUへ保持して必要なデータを読み込みます。今回はSSDストリーミング用キャッシュ枠の要求値を40GiBに設定しました。起動ログ上、その内訳はプリフィル用予約7.12GiBと動的エキスパートキャッシュ32.88GiBです。ホストのRAMは約503GiBあり、ファイルの整合性検査後にOSキャッシュが温まった条件です。「SSDストリーミング」という設定名から、全読み出しが毎回物理SSDへ到達しているとは言えません。
配布ページの説明には旧版の記述も残っています。そのため今回のファイルでは、GGUF内のsource URLとrevisionが1017、1bae0e10…を指すこと、ダウンロードしたファイルのSHA256が配布情報と一致することを確認しました。DwarfStarの開発元、使用した配布リビジョン。
比較条件
| 項目 | 今回 | 以前の比較対象 |
|---|---|---|
| GPU | A100 80GB PCIe×1 | HGX B200×8 |
| 推論ソフト | DwarfStar / CUDA | vLLM 0.31.0 |
| 重み | 1017由来のQ2混合量子化GGUF | 公式1017のFP4+FP8混在 |
| コンテキスト設定上限 | 1,048,576トークン(長文入力を実際に投入したという意味ではありません) | |
| 生成上限 / 推論量 | 262,144トークン / 100 | |
| temperature / top_p | 1.0 / 0.95 | |
| 同時要求数 | 1 | 5 |
同じ問題文と固定済みの採点基準を使い、各問を一回ずつ実行しました。成功するまで再試行して回答を選んでいません。GPU・推論ソフト・並列数・量子化・プロンプトの処理が異なるため、これは構成全体の比較です。差を量子化だけの影響やGPU枚数の効果へ帰属することはできません。比較元のB200検証。
数値問題12問はすべて照合に合格
| 項目 | A100×1 / Q2 | B200×8 / 公式1017 |
|---|---|---|
| 回答完了 | 20/20 | 20/20 |
| 数値の自動照合 | 12/12 | 11/12 |
| 通信失敗・時間切れ・生成上限打ち切り | 0件 | 0件 |
12/12対11/12を、そのままQ2の能力が高いと解釈してはいけません。差が出た密度の不確かさでは、両方の説明に正しい計算値約0.0358がありました。B200の数値欄0.036は固定許容0.2%を外れ、Q2の0.0358は収まりました。これは丸め方による採点差です。
文章は読める。ただし補足まで点検する
数値12問の計算式と、記述8問の最終回答をCodexで補助レビューしました。材料と温度の交絡、情報不足、p値の誤解、条件構成による成功率の差、データリーク、パラメータの識別性といった主な結論は妥当でした。独立した専門家による採点は未実施です。
| 例 | 確認した内容と注意点 |
|---|---|
| 温度差から反応熱を計算 | 必要情報が足りないと正しく回答。ただしQ2は反応熱の符号規約を式の中で明確にしておらず、補足が必要。 |
| 逆分散の重み付き平均 | 10.8という計算は正しい。一方でQ2の限界説明は、問題文に明記した独立性などを「情報不足」と扱う箇所がある。 |
| 触媒と撹拌の切り分け | 対照・温度測定・無作為化・反復を提案。両モデルとも、撹拌の頭打ちだけから速度論支配を断定する説明は強すぎる。 |
| 積abだけが観測できるモデル | 両方ともab=6のみ推定可能と回答。追加制約や事前分布を置くことと、観測から個別パラメータが識別できることは区別する必要がある。 |
正常な文章が出ることと、説明の全項目が正しいことは別です。良い例だけでなく注意点も含め、全20問の問題と最終回答を併記します。
回答品質より大きかったのは待ち時間
| 20問の応答時間 | A100×1 / Q2 | B200×8 / 公式1017 |
|---|---|---|
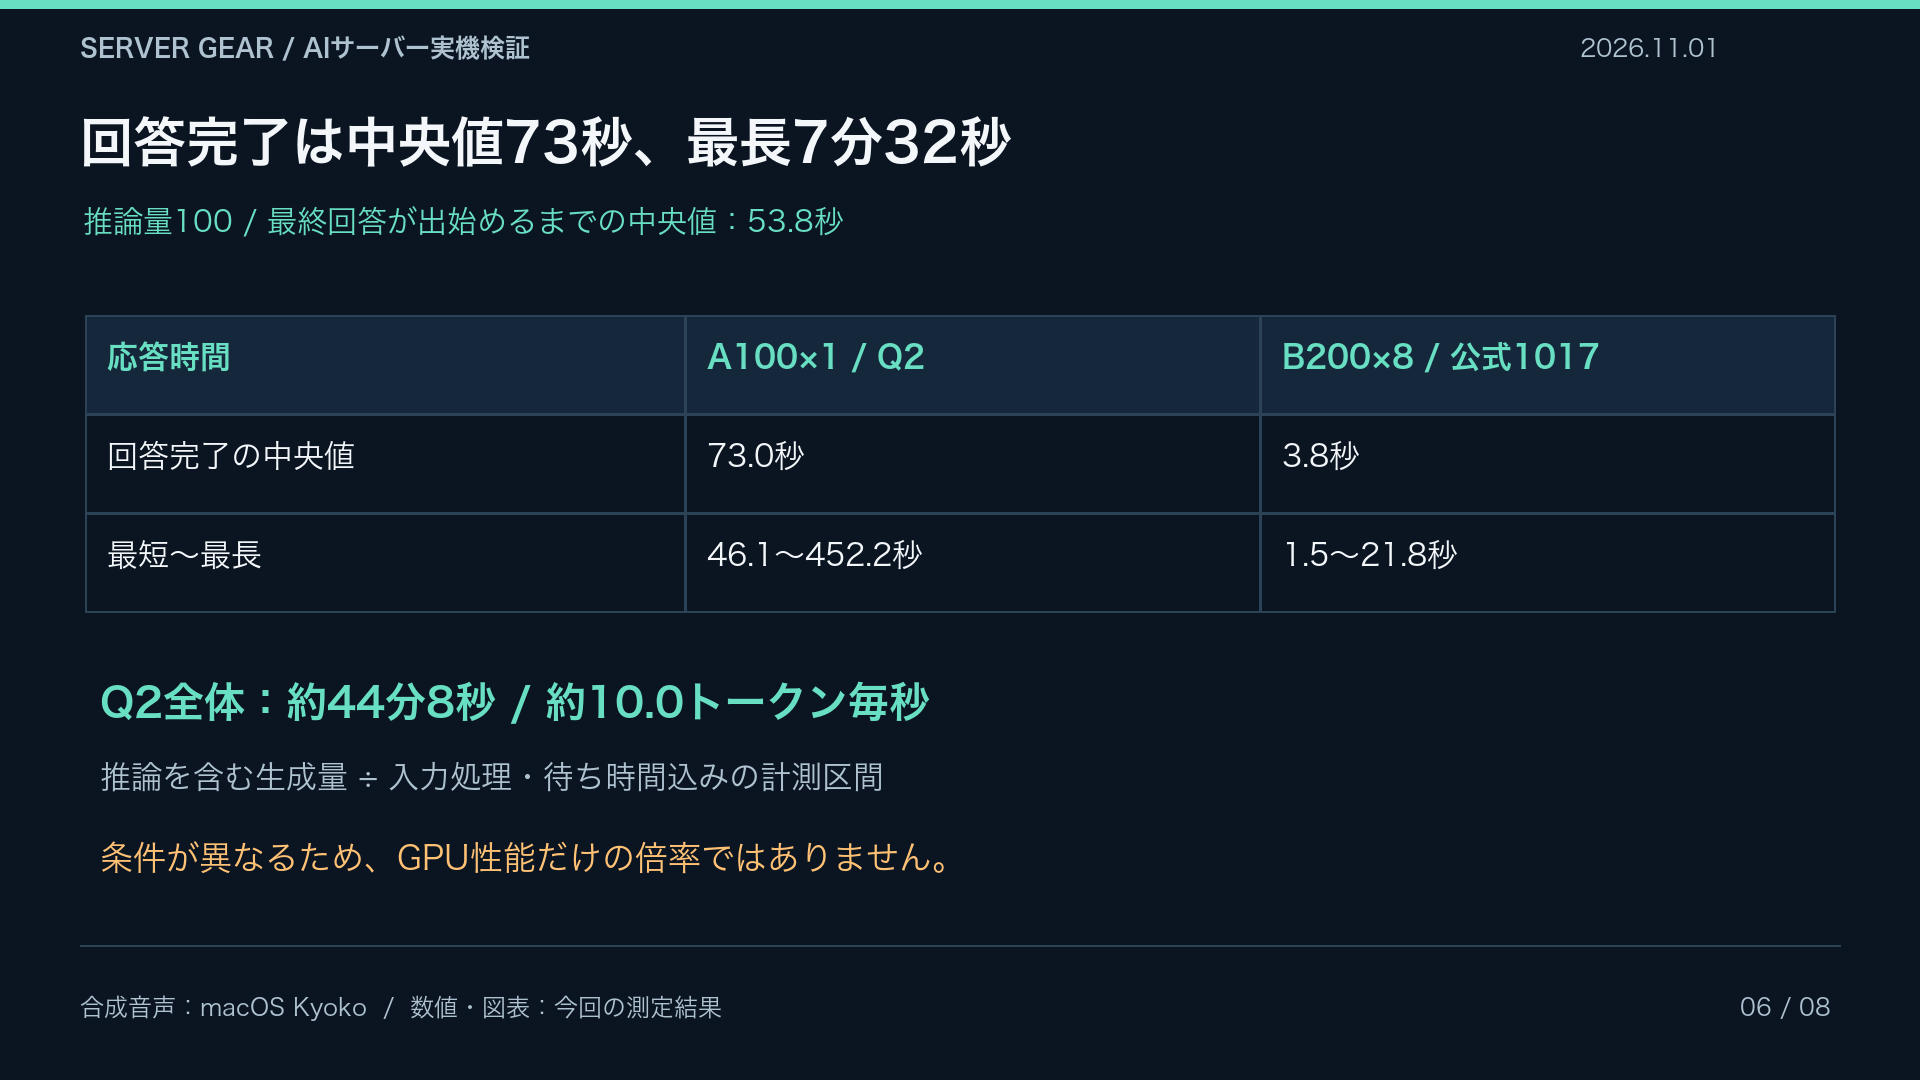
| 回答完了の中央値 | 73.0秒 | 3.8秒 |
| 最短〜最長 | 46.1〜452.2秒 | 1.5〜21.8秒 |
今回のQ2は、推論の途中経過ではなく最終回答が出始めるまでの中央値が53.8秒でした。20問の計測区間は約44分8秒。推論を含む生成26,447トークンを入力処理・待ち時間込みで割ると、全体で約10.0トークン/秒です。これは生成中だけの速度とは異なります。簡易評価の短文生成では約13.1トークン/秒でしたが、同じ指標として混ぜません。
長く考えた問題ほど待ち時間が延びました。条件別成功率の問題は約7分32秒、反証可能性の問題は約5分36秒です。B200とは並列条件も異なり、速度差をハードウェアだけの倍率として示すことはできません。今回の1M設定で、5秒間隔の観測によるGPUメモリ使用量の最大値は約67.0GiBでした。
同時利用の結果
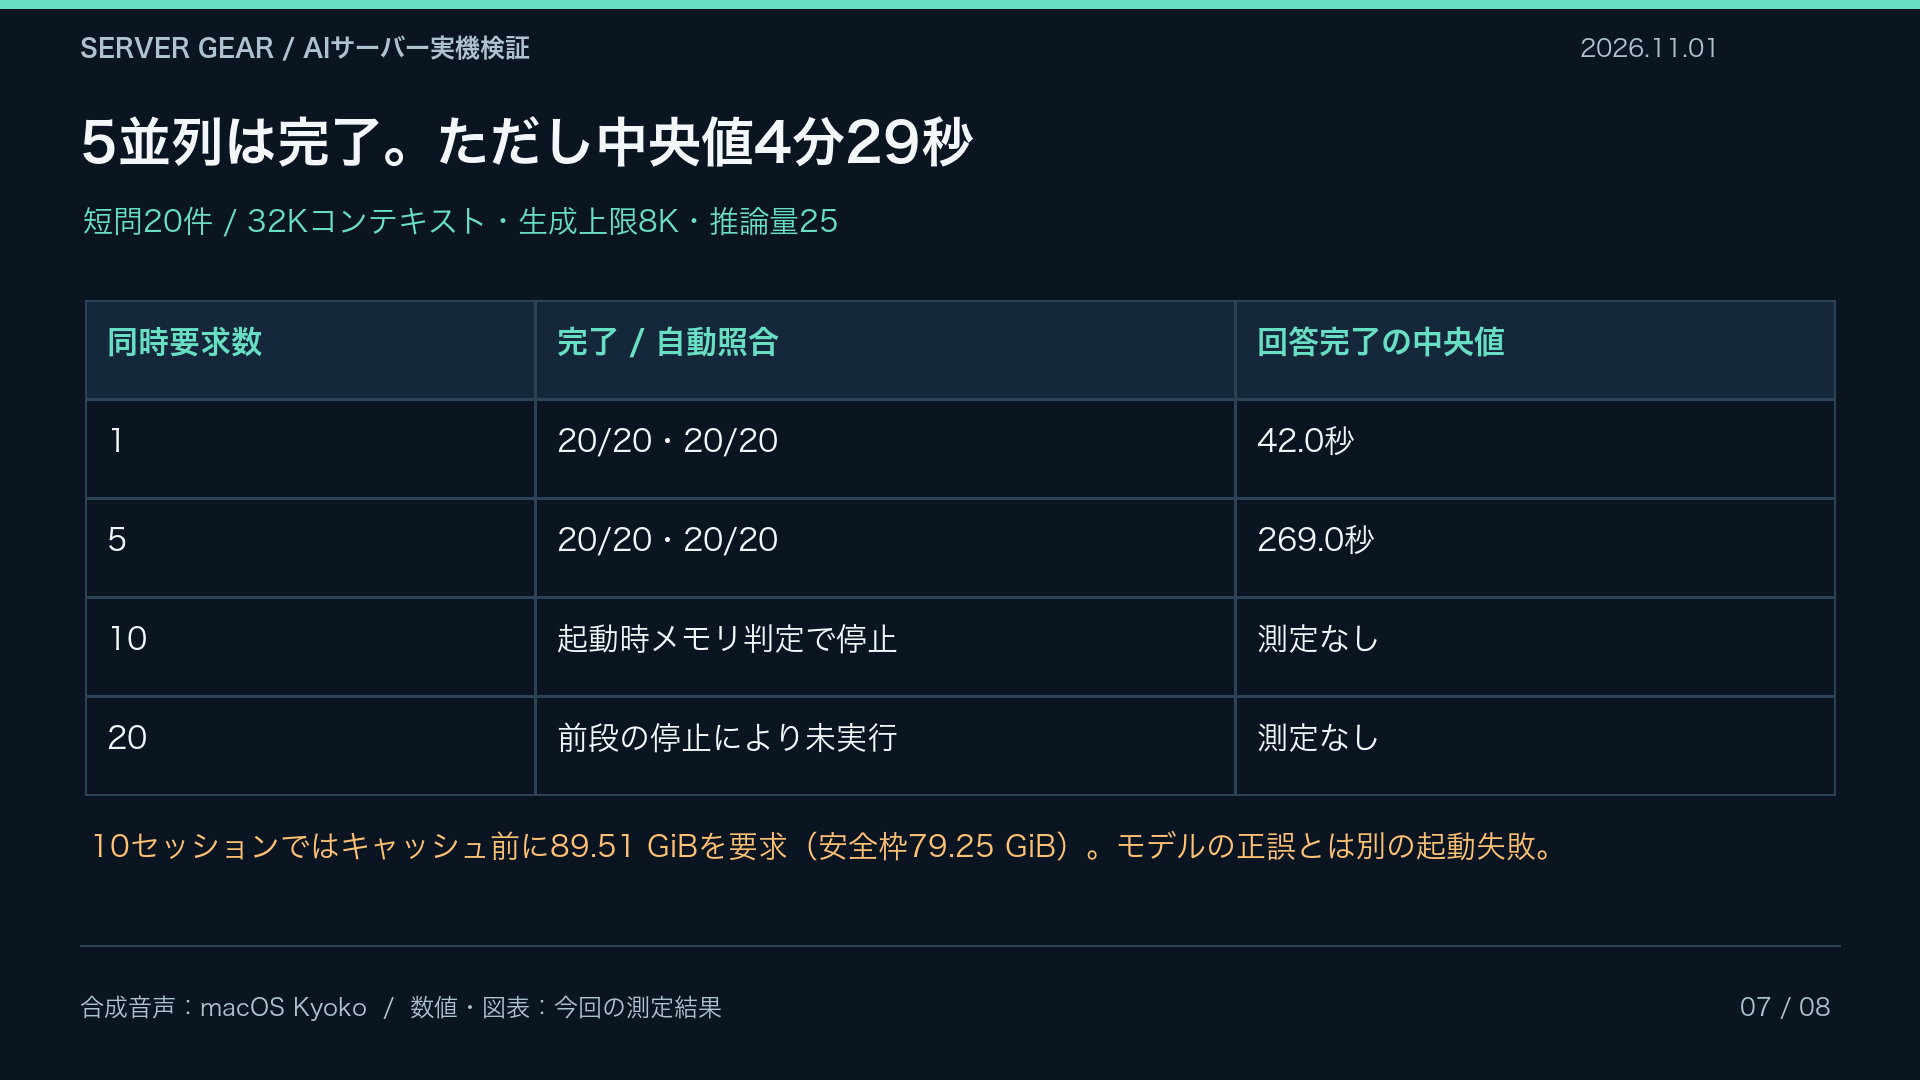
別の短問20件を使い、コンテキスト32,768、生成上限8,192、推論量25で、同時要求数を変えました。科学的推論20問とは別の検証です。
| 同時要求数 | 完了 / 数値の自動照合 | 回答完了の中央値 | 回答完了のp95 | 全体の生成量 |
|---|---|---|---|---|
| 1 | 20/20・20/20 | 42.0秒 | 56.6秒 | 6.78トークン/秒 |
| 5 | 20/20・20/20 | 269.0秒 | 362.4秒 | 5.04トークン/秒 |
| 10 | 起動時のメモリ判定で停止 | 要求送信前のため、応答時間・正誤は未測定 | ||
| 20 | 前段の停止により未実行 | 未測定 | ||
5並列でも全件完了しましたが、待ち時間は中央値で約4分29秒となり、全体の生成量も1並列より下がりました。p95は20件から線形補間した記述統計であり、長期間のサービス品質を表す値ではありません。生成量には推論を含み、入力処理と待ち時間を含む計測区間で割っています。
5セッション時には、動的エキスパートキャッシュが起動時に32.88GiBから21.69GiBへ自動調整されました。10セッションでは、キャッシュを載せる前の必要量が89.51GiB、安全枠が79.25GiBと見積もられ、起動前に拒否されました。単にQ2の回答能力が落ちたという結果ではありません。
原結果を保存した上で、プリフィル設定を512へ小さくする起動診断も別に行いましたが、同じメモリ判定で停止しました。このコミットのDeepSeek V4.1用の見積もりは、コンテキスト長から求めたグラフ領域にセッション数を掛けており、この設定変更は見積もりを減らしませんでした。安全判定を外す変更や、成功するまでの再試行はしていません。
同時利用の集計と診断 / 1・5並列の全最終回答を含む資料ZIP
今回わかったこと
A100 80GBが1枚でも、DwarfStarとSSDストリーミングを使って、このQ2版から意味のある回答を得られました。小規模な科学的推論では主な答えを保っています。一方、長く考える質問には数分かかり、応答速度を重視する用途では大きな制約があります。既存機での個人検証や、待ち時間を許容できる用途を考えるための結果です。
20問の一回測定から、公式重みと同等の能力、一般的な科学的正答率、20人向けのサービス品質、少ないホストRAMでも同じ速度が出ることまでは示していません。導入を判断する際は、実際の質問・文書長・同時利用数で測定する必要があります。
再現条件・ファイル識別情報 / 問題別の所要時間 / AI・HPCサーバーの構成・検証相談:Server Gear
再現条件と資料
全回答・条件・集計・CSVをまとめた資料ZIP。公開用資料には最終回答を収録し、内部の推論文や接続情報は含めていません。
ファイル識別情報と設定を表示
{
  "dwarfstar_commit": "c97964b8aa77034a8e17afb10ca7a686c40ab511",
  "model_repo": "antirez/deepseek-v4.1-flash-gguf",
  "model_revision": "9dcee51692e6540f697141fc98b097e3c96492a3",
  "model_filename": "DeepSeek-V4.1-Flash-1017-IQ2_XXS-Q2_K-imatrix.gguf",
  "model_bytes": 365713686528,
  "model_sha256": "5296e85ff64b42ecb62c8d0c0c54e1caa07e3df8e93112f2365ebbaed62ce93a",
  "baseline_model_revision": "1bae0e1088993b9b82de08f59de5be5a34e42170",
  "comparison_limits": [
    "Hardware, engine, quantization, concurrency and prompt renderer differ. This is an end-to-end configuration comparison, not a controlled quantization-only ablation.",
    "Baseline concurrency is 5; Q2 concurrency is 1. Latencies are descriptive, not GPU scaling measurements.",
    "Same numeric seed does not reproduce random samples across different engines.",
    "No retries or selection of best answer. Unfinished and not-started cases are reported separately from incorrect final answers.",
    "The Q2 label is mixed quantization, not every weight uniformly 2-bit.",
    "All 20 original messages and original automatic grading rules are preserved. Eight qualitative answers require human review.",
    "No speed claim about physically cold SSD reads: large host RAM and warm OS page cache can affect results."
  ],
  "quality_settings": {
    "backend": "CUDA",
    "hardware": "A100 80GB PCIe",
    "context": 1048576,
    "max_tokens": 262144,
    "temperature": 1.0,
    "top_p": 0.95,
    "min_p": 0.0,
    "top_k": 0,
    "reasoning_effort": "100",
    "seed_base": 20261026,
    "concurrency": 1,
    "timeout_s": 5400,
    "attempts_per_case": 1,
    "ssd_streaming": true,
    "ssd_expert_cache": "40GB",
    "disk_kv_cache": false
  },
  "hardware_note": "4枚搭載ホストのうちA10080GB PCIeを1枚使用。ホストRAM約503GiB。OSページキャッシュを排出せず測定。",
  "provenance": {
    "version": 3,
    "tensors": 1046,
    "metadata": {
      "general.architecture": "deepseek41",
      "general.name": "DeepSeek V4.1 Flash",
      "general.source.url": "https://huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash-1017",
      "general.source.revision": "1bae0e1088993b9b82de08f59de5be5a34e42170",
      "general.alignment": 16384,
      "deepseek41.candidate_source_layer_id": 20,
      "deepseek41.kv_source_layer_ids": {
        "array_type": 4,
        "count": 4
      },
      "deepseek41.index_source_layer_ids": {
        "array_type": 4,
        "count": 8
      },
      "deepseek41.quantization": "IQ2_XXS gate/up; Q2_K down; Q8_0 attention/shared/head",
      "quantize.imatrix.file": "bootstrap-calibration-8192.dat",
      "quantize.imatrix.sha256": "75fadebe6d743fe7f751a5e5cdc13d198e2f3aae2504afeaf7f6acd24cce052f"
    }
  },
  "baseline": "HGX B200×8、vLLM0.31.0、同時要求5。Q2側は同時要求1。"
}
同時利用の集計・診断
各段階の集計・起動失敗・別条件の診断
{
  "experiment": "DwarfStar Q2 A10080GBx1 short-question operational pilot",
  "settings": {
    "context": 32768,
    "max_output": 8192,
    "reasoning_effort": "25",
    "temperature": 1,
    "top_p": 0.95,
    "seed_base": 20261026,
    "request_timeout_s": 900,
    "requested_cache_gib": 40
  },
  "stages": [
    {
      "concurrency": 1,
      "planned": 20,
      "started": 20,
      "not_started": 0,
      "statuses": {
        "complete": 20
      },
      "completed": 20,
      "automatic_correct": 20,
      "quantile_method": "linear interpolation; descriptive small sample, completed responses only",
      "first_generated_s": {
        "n": 20,
        "median": 19.213226405030582,
        "p95": 20.191071174439276
      },
      "first_final_s": {
        "n": 20,
        "median": 30.689926737977657,
        "p95": 38.710826285305686
      },
      "completion_s": {
        "n": 20,
        "median": 42.040289405034855,
        "p95": 56.55192150897348
      },
      "recorded_completion_tokens": 6055,
      "measured_window_s": 892.834736949997,
      "aggregate_tokens_per_s": 6.781770185918639,
      "throughput_note": "Usage-reported generated tokens including reasoning / total request window; incomplete response usage may be missing."
    },
    {
      "concurrency": 5,
      "planned": 20,
      "started": 20,
      "not_started": 0,
      "statuses": {
        "complete": 20
      },
      "completed": 20,
      "automatic_correct": 20,
      "quantile_method": "linear interpolation; descriptive small sample, completed responses only",
      "first_generated_s": {
        "n": 20,
        "median": 182.45554651797283,
        "p95": 239.882095103513
      },
      "first_final_s": {
        "n": 20,
        "median": 230.70544554601656,
        "p95": 313.2484840076708
      },
      "completion_s": {
        "n": 20,
        "median": 268.98357007000595,
        "p95": 362.3820937822806
      },
      "recorded_completion_tokens": 6055,
      "measured_window_s": 1202.5745365929324,
      "aggregate_tokens_per_s": 5.035030940497618,
      "throughput_note": "Usage-reported generated tokens including reasoning / total request window; incomplete response usage may be missing."
    }
  ],
  "c10": {
    "state": "startup_failed",
    "requests_started": 0,
    "error": "V4.1 needs 89.51 GiB before the expert cache; safe budget 79.25 GiB",
    "classification": "runtime memory admission, not model-answer failure"
  },
  "c20": {
    "state": "not_run",
    "reason": "stopped after c10 startup failure"
  },
  "diagnostic": {
    "name": "c10-prefill512-startup",
    "isolated_from_original": true,
    "changed_setting": "--prefill-chunk 512, down from default8192; context32768 and10resident sessions unchanged",
    "ready": false,
    "same_error": true,
    "explanation": "Inspection of this commit shows DeepSeek4.1 memory admission uses ds41_graph_bytes(ctx) multiplied by session count; prefill_chunk does not enter this calculation. No safety check bypass and no scored rerun."
  },
  "limits": "20 short questions per level, single run. Different protocol from scientific20 comparison; not productionSLA. No drop of OS pagecache."
}
科学的推論20問:問題と最終回答
各項目を開くと、問題文と両構成の最終回答を確認できます。回答内の誤りや不明確な説明もそのまま保持しています。
reason-01-uncertainty — Q2 217.9秒 / B200 6.7秒
問題
質量100.0±0.2 g、体積12.50±0.05 cm³。±は独立な標準不確かさ。密度と一次誤差伝播での標準不確かさを求め、valueには密度の標準不確かさを入れてください。 最終回答はJSONオブジェクト1個にしてください。キーは "answer"(日本語の短い結論), "value"(求めた主数値。算出不能ならnull), "unit", "explanation"(検証できる計算式と根拠の簡潔な説明), "limitations", "citations"(文書IDの配列。資料なしなら空配列)。
A100×1 / Q2
{"answer":"密度は8.00 g/cm³、その標準不確かさは0.036 g/cm³(計算値0.0358 g/cm³)です。","value":0.0358,"unit":"g/cm³","explanation":"ρ=m/V=100.0/12.50=8.000 g/cm³。独立な標準不確かさの一次伝播より σρ=ρ√[(σm/m)²+(σV/V)²]=8.000×√[(0.2/100.0)²+(0.05/12.50)²]=8.000×√(0.002²+0.004²)=8.000×0.004472=0.03578≈0.036 g/cm³。寄与は質量0.016、体積0.032 g/cm³。","limitations":"質量・体積の不確かさは独立で相関なしと仮定し、線形一次伝播の範囲内としています。単一測定であり、試料の一様性や系統誤差は別途評価していません。表示は有効数字1桁なら0.04 g/cm³となります。","citations":[]}B200×8 / 公式1017
{"answer":"密度は 8.00 g/cm³、一次誤差伝播による標準不確かさは約 0.036 g/cm³(表示上は 8.00 ± 0.04 g/cm³)です。","value":0.036,"unit":"g/cm³","explanation":"ρ = m/V = 100.0 g / 12.50 cm³ = 8.00 g/cm³。独立な標準不確かさに対する一次伝播より、u(ρ) = ρ√[(u(m)/m)² + (u(V)/V)²] = 8.00 × √[(0.2/100.0)² + (0.05/12.50)²] = 8.00 × √[(0.002)² + (0.004)²] = 0.0358 g/cm³ ≈ 0.036 g/cm³。","limitations":"質量と体積の不確かさが独立で、相関がなく、一次近似が十分有効であると仮定しています。不確かさの有効数字は入力の不確かさの桁数に応じて丸める場合があります。","citations":[]}reason-02-bayes — Q2 67.2秒 / B200 2.5秒
問題
製品不良率1%。検査の感度95%、良品を陽性とする確率5%。無作為に選んだ製品が陽性だったとき、不良である確率を0〜1で求めてください。 最終回答はJSONオブジェクト1個にしてください。キーは "answer"(日本語の短い結論), "value"(求めた主数値。算出不能ならnull), "unit", "explanation"(検証できる計算式と根拠の簡潔な説明), "limitations", "citations"(文書IDの配列。資料なしなら空配列)。
A100×1 / Q2
{"answer":"陽性だった製品が不良である確率は約16.1%(0.161)です。","value":0.1610169491525424,"unit":"無次元(0〜1の確率)","explanation":"ベイズの定理より、P(不良|陽性)=P(陽性|不良)P(不良)/(P(陽性|不良)P(不良)+P(陽性|良品)P(良品))。数値を代入すると(0.95×0.01)/(0.95×0.01+0.05×0.99)=0.0095/(0.0095+0.0495)=0.0095/0.059≈0.1610です。","limitations":"問題文の数値のみを使用し、無作為抽出および検査結果の条件付き確率が所与であることを仮定しています。追加の文献・データはありません。","citations":[]}B200×8 / 公式1017
{"answer":"陽性だった製品が不良である確率は約16.1%です。","value":0.1610169492,"unit":"確率(0〜1)","explanation":"不良率P(不良)=0.01、感度P(陽性|不良)=0.95、良品を陽性とする確率P(陽性|良品)=0.05とします。ベイズの定理より、P(不良|陽性)=[0.01×0.95]/[0.01×0.95+0.99×0.05]=0.0095/(0.0095+0.0495)=0.0095/0.059=19/118≈0.1610です。","limitations":"与えられた不良率・感度・偽陽性率が正確かつ対象集団に適用可能で、検査結果がこれらの確率に従って独立に得られるという前提に基づく計算です。","citations":[]}reason-03-weighted_mean — Q2 88.2秒 / B200 3.9秒
問題
同じ量の独立な不偏測定10±1と14±2。±は既知の標準偏差。逆分散重み付き推定値を求めてください。 最終回答はJSONオブジェクト1個にしてください。キーは "answer"(日本語の短い結論), "value"(求めた主数値。算出不能ならnull), "unit", "explanation"(検証できる計算式と根拠の簡潔な説明), "limitations", "citations"(文書IDの配列。資料なしなら空配列)。
A100×1 / Q2
{"answer":"逆分散重み付き推定値は10.8(測定値と同じ単位)です。","value":10.8,"unit":"測定値と同じ単位(具体的単位は未指定)","explanation":"独立かつ標準偏差既知と仮定します。逆分散重みは w_i=1/σ_i^2 なので、w1=1/1^2=1、w2=1/2^2=0.25です。推定値=(1×10+0.25×14)/(1+0.25)=(10+3.5)/1.25=10.8です。合成分散は1/(1+0.25)=0.8、標準誤差は√0.8≈0.894です。","limitations":"測定値の具体的単位、測定間の独立性、分布・相関・バイアスの有無は情報不足です。逆分散重み付き推定は独立性と既知分散を前提とします。","citations":[]}B200×8 / 公式1017
{"answer":"逆分散重み付き推定値は10.8(標準誤差は約0.894)です。","value":10.8,"unit":"測定値と同じ単位(未指定)","explanation":"重みを w_i=1/σ_i^2 とすると、w_1=1/1^2=1、w_2=1/2^2=1/4です。逆分散重み付き推定値は (10×1+14×1/4)/(1+1/4)=(10+3.5)/1.25=13.5/1.25=10.8 です。推定値の分散は 1/(1+1/4)=0.8、標準誤差は √0.8≈0.894 です。","limitations":"測定値の単位が提示されていないため単位は未指定です。2測定が独立で、標準偏差が既知であり、各測定が同じ量の不偏測定であるという仮定に基づきます。","citations":[]}reason-04-arrhenius — Q2 137.5秒 / B200 3.4秒
問題
Arrhenius則に従う反応でk(300 K)=0.10 s^-1、k(330 K)=0.30 s^-1、R=8.314 J/(mol K)。活性化エネルギーをkJ/molで求めてください。 最終回答はJSONオブジェクト1個にしてください。キーは "answer"(日本語の短い結論), "value"(求めた主数値。算出不能ならnull), "unit", "explanation"(検証できる計算式と根拠の簡潔な説明), "limitations", "citations"(文書IDの配列。資料なしなら空配列)。
A100×1 / Q2
{"answer":"活性化エネルギーは約30.14 kJ/mol(約30.1 kJ/mol)です。","value":30.14,"unit":"kJ/mol","explanation":"Arrhenius式 k=A·exp(−Ea/(RT)) より、2温度の比から ln(k2/k1)=Ea/R·(1/T1−1/T2) です。T1=300 K、T2=330 K、k1=0.10 s^-1、k2=0.30 s^-1、R=8.314 J/(mol·K) を代入すると、Ea=8.314×ln(0.30/0.10)/(1/300−1/330)≈8.314×1.098612/(1/3300)≈30141.7 J/mol≈30.14 kJ/mol となります。","limitations":"Arrhenius則(前指数因子Aが温度に依存しない)を仮定し、2点の速度定数のみから算出しています。測定誤差や圧力・触媒条件などは考慮していません。","citations":[]}B200×8 / 公式1017
{"answer":"活性化エネルギーは約30.1 kJ/molです。","value":30.1,"unit":"kJ/mol","explanation":"Arrhenius式より ln(k2/k1)=-(Ea/R)(1/T2-1/T1) なので、Ea=R ln(k2/k1)/(1/T1-1/T2) です。T1=300 K, T2=330 K, k1=0.10 s^-1, k2=0.30 s^-1, R=8.314 J/(mol K) を代入すると、Ea=8.314×ln(0.30/0.10)/(1/300-1/330)=8.314×ln3/(1/3300)≈3.014×10^4 J/mol≈30.1 kJ/mol となります。","limitations":"Arrhenius則に従い、活性化エネルギーが温度によらず一定であると仮定しています。測定値の不確かさや反応機構の情報は与えられていません。","citations":[]}reason-05-mixing — Q2 52.9秒 / B200 1.6秒
問題
比熱が等しい水0.20 kgを80℃、0.30 kgを20℃で混合。容器の熱容量と損失を無視。平衡温度を℃で求めてください。 最終回答はJSONオブジェクト1個にしてください。キーは "answer"(日本語の短い結論), "value"(求めた主数値。算出不能ならnull), "unit", "explanation"(検証できる計算式と根拠の簡潔な説明), "limitations", "citations"(文書IDの配列。資料なしなら空配列)。
A100×1 / Q2
{"answer":"平衡温度は44℃です。","value":44,"unit":"℃","explanation":"熱量保存より、混合前後の熱量変化の和が0です。比熱をcとすると 0.20c(80−T) + 0.30c(20−T)=0。c≠0なので 0.20(80−T)+0.30(20−T)=0。これを解くと 16−0.20T+6−0.30T=0 → 22=0.50T → T=44℃。","limitations":"容器の熱容量・熱損失を無視し、水の比熱が等しく温度によらず一定、相変化や蒸発がないと仮定しています。","citations":[]}B200×8 / 公式1017
{"answer":"平衡温度は44℃です。","value":44,"unit":"℃","explanation":"熱量保存により、比熱をcとして 0.20c(80−T)=0.30c(T−20)。両辺をcで割り、0.20(80−T)=0.30(T−20)。16−0.20T=0.30T−6 より 22=0.50T、T=44℃。","limitations":"水の比熱が温度によらず等しいこと、容器の熱容量・熱損失・混合に伴う熱の出入りを無視できること、相変化がないことを仮定しています。","citations":[]}reason-06-pump_power — Q2 50.8秒 / B200 1.5秒
問題
体積流量0.004 m³/s、圧力上昇150 kPa、ポンプ効率0.60。必要軸動力をWで求めてください。 最終回答はJSONオブジェクト1個にしてください。キーは "answer"(日本語の短い結論), "value"(求めた主数値。算出不能ならnull), "unit", "explanation"(検証できる計算式と根拠の簡潔な説明), "limitations", "citations"(文書IDの配列。資料なしなら空配列)。
A100×1 / Q2
{"answer":"必要軸動力は約1000 Wです。","value":1000,"unit":"W","explanation":"水力動力 = 体積流量 × 圧力上昇 = 0.004 m³/s × 150 kPa = 0.004 × 150,000 Pa = 600 W。軸動力 = 水力動力 ÷ ポンプ効率 = 600 W ÷ 0.60 = 1000 W。","limitations":"定常・非圧縮性流体とし、圧力上昇は有効差圧、効率は軸動力から流体への変換効率とした。配管損失や圧力変動、効率の運転点依存などは考慮していない。","citations":[]}B200×8 / 公式1017
{"answer":"必要軸動力は約1000 Wです。","value":1000,"unit":"W","explanation":"体積流量Q=0.004 m³/s、圧力上昇Δp=150 kPa=150,000 Paとすると、流体に与える水力動力は P_h=QΔp=0.004×150,000=600 W。ポンプ効率η=0.60より、必要軸動力 P_shaft=P_h/η=600/0.60=1000 W。","limitations":"定常・非圧縮性流体とし、圧力上昇分のみを考慮しています。配管損失、高低差、速度変化、内部漏れなどは別途考慮が必要です。","citations":[]}reason-07-decay_inverse — Q2 67.6秒 / B200 4.4秒
問題
C(t)=C0 exp(-kt)でC(5 s)=8、C(15 s)=2。Cが1になる時刻をsで求めてください。 最終回答はJSONオブジェクト1個にしてください。キーは "answer"(日本語の短い結論), "value"(求めた主数値。算出不能ならnull), "unit", "explanation"(検証できる計算式と根拠の簡潔な説明), "limitations", "citations"(文書IDの配列。資料なしなら空配列)。
A100×1 / Q2
{"answer":"Cが1になる時刻は20 sです。","value":20,"unit":"s","explanation":"C(15)/C(5)=exp(-10k)=2/8=1/4 より k=ln(4)/10=ln(2)/5。次に 1=8·exp(-k(t-5)) を解くと exp(-k(t-5))=1/8、k(t-5)=ln(8)=3ln(2) なので t-5=15、t=20 s。別解として半減期が5 s(8→4→2→1)と確認できる。","limitations":"与えられた2点が正確であり、単一の指数減衰モデルC(t)=C0 exp(-kt)に従うと仮定している。外部資料は使用していない。","citations":[]}B200×8 / 公式1017
{"answer":"C=1となる時刻は20 sです。","value":20,"unit":"s","explanation":"C(15)/C(5)=2/8=1/4=exp(-10k) より、exp(-10k)=1/4、したがって k=ln4/10=ln2/5 s^-1。C(t)=C(5)exp[-k(t-5)] に C=1 を代入すると、1=8exp[-k(t-5)]、exp[-k(t-5)]=1/8。よって t-5=ln8/k=3ln2/(ln2/5)=15、t=20 s。別解として、5 sで8から2へ1/4(2回半減)なので半減期は5 s。15 sで2、その5 s後に1となるので20 s。","limitations":"C(t)=C0 exp(-kt) が全時刻で成立し、与えられたC(5)=8およびC(15)=2が正確であると仮定しています。","citations":[]}reason-08-grid_order — Q2 72.6秒 / B200 2.6秒
問題
同じ滑らかな解の誤差ノルムは格子幅h=0.1で0.004、h=0.05で0.001。E=C h^pの漸近域と仮定し、観測収束次数pを求め、仮定の限界を説明してください。 最終回答はJSONオブジェクト1個にしてください。キーは "answer"(日本語の短い結論), "value"(求めた主数値。算出不能ならnull), "unit", "explanation"(検証できる計算式と根拠の簡潔な説明), "limitations", "citations"(文書IDの配列。資料なしなら空配列)。
A100×1 / Q2
{"answer":"滑らかな解の誤差が E=C h^p に従うと仮定すると、観測収束次数は p=2(2次)です。","value":2.0,"unit":"無次元","explanation":"e(0.1)=0.004、e(0.05)=0.001 より、比は e(0.1)/e(0.05)=0.004/0.001=4。E=C h^p の漸近域では e(0.1)/e(0.05)=(0.1/0.05)^p=2^p なので、2^p=4 から p=log(4)/log(2)=2 となります。","limitations":"2格子点のみの観測であり、漸近域に入っている、誤差定数Cが一定、滑らかな解、同一ノルムという仮定に依存します。粗い格子や打ち切り誤差・丸め誤差・前漸近域の影響があるとp=2は保証されず、pの推定値を確認するには追加の格子幅やリッチャードソン外挿などが必要です。","citations":[]}B200×8 / 公式1017
{"answer":"観測収束次数はp=2(二次収束)と推定されます。","value":2.0,"unit":"無次元(収束次数)","explanation":"E=C h^p と仮定すると、E(0.1)/E(0.05)=(0.1/0.05)^p=2^p です。与えられた誤差ノルムから 0.004/0.001=4 なので、2^p=4 より p=log(4)/log(2)=2 となります。","limitations":"2格子点だけではpを厳密に決めるには十分ではなく、漸近域にあるかは検証できません。丸め誤差、離散化以外の誤差、解の滑らかさ、誤差ノルムの種類、格子列の詳細が不明なため、観測次数は推定値です。少なくとも3格子以上で比が一定か確認する必要があります。","citations":[]}reason-09-diffusion_stability — Q2 46.1秒 / B200 2.2秒
問題
1次元熱方程式の陽的中心差分で熱拡散率alpha=1e-5 m²/s、dx=1e-3 m。安定条件alpha*dt/dx²<=1/2から、dt上限をsで求めてください。 最終回答はJSONオブジェクト1個にしてください。キーは "answer"(日本語の短い結論), "value"(求めた主数値。算出不能ならnull), "unit", "explanation"(検証できる計算式と根拠の簡潔な説明), "limitations", "citations"(文書IDの配列。資料なしなら空配列)。
A100×1 / Q2
{"answer":"陽的中心差分の安定条件から、dtの上限は0.05 sです。","value":0.05,"unit":"s","explanation":"安定条件 α·dt/dx² ≤ 1/2 より dt ≤ (1/2)·dx²/α。α=1e-5 m²/s、dx=1e-3 mなので dx²=1e-6 m²、dx²/α=1e-6/1e-5=0.1 s、その半分は0.05 sです。","limitations":"1次元・均一格子・陽的中心差分・熱拡散率一定を仮定しています。境界条件や物性変化は考慮していません。","citations":[]}B200×8 / 公式1017
{"answer":"dtの上限は0.05秒です。","value":0.05,"unit":"s","explanation":"dx=1e-3 mよりdx²=1e-6 m²。α=1e-5 m²/sなので、α/dx²=1e-5/1e-6=10 s⁻¹。安定条件α·dt/dx²≤1/2より10·dt≤0.5、したがってdt≤0.05 sです。","limitations":"1次元・均質な熱拡散率・陽的スキームを前提とし、境界条件や非線形性は考慮していません。dt=0.05 sは限界的安定(等号)です。","citations":[]}reason-10-correlated_uncertainty — Q2 67.7秒 / B200 3.6秒
問題
X=10±1、Y=6±1、標準不確かさの相関係数rho=0.8。Z=X-Yの標準不確かさを求めてください。 最終回答はJSONオブジェクト1個にしてください。キーは "answer"(日本語の短い結論), "value"(求めた主数値。算出不能ならnull), "unit", "explanation"(検証できる計算式と根拠の簡潔な説明), "limitations", "citations"(文書IDの配列。資料なしなら空配列)。
A100×1 / Q2
{"answer":"Z=X−Yの標準不確かさは約0.63です。","value":0.632455532,"unit":"X・Yと同じ単位(単位未指定)","explanation":"u(X)=1、u(Y)=1、相関係数ρ=0.8と仮定する。Z=X−Yの分散は u²(Z)=u²(X)+u²(Y)−2ρu(X)u(Y)=1+1−2×0.8×1×1=0.4。したがって標準不確かさは u(Z)=√0.4≈0.632455532(約0.63)です。","limitations":"±1を標準不確かさ(包含係数k=1)と仮定しています。もし±1が拡張不確かさなら、kで割って標準不確かさに換算する必要があります。また線形一次伝播と与えられた相関係数を前提としています。","citations":[]}B200×8 / 公式1017
{"answer":"Z=X-Y の標準不確かさは約0.632(X・Yと同じ単位)です。","value":0.632455532,"unit":"X・Yと同じ単位","explanation":"XとYの標準不確かさをそれぞれ u_X=1、u_Y=1、相関係数を ρ=0.8 とすると、差の分散は u_Z^2=u_X^2+u_Y^2-2ρu_Xu_Y=1^2+1^2-2×0.8×1×1=0.4。したがって u_Z=√0.4≈0.632455532 です。","limitations":"±1を標準不確かさ(包含係数k=1)と仮定しています。もし±1が拡張不確かさの場合は、kで割って標準不確かさに変換する必要があります。線形伝播を仮定し、XとY以外の相関や非線形性は考慮していません。","citations":[]}reason-11-unit_conversion — Q2 46.1秒 / B200 2.1秒
問題
空気中濃度2.0 mg/m³の物質を、流量3.0 m³/minで40 min捕集。捕集効率80%。捕集量をmgで求めてください。 最終回答はJSONオブジェクト1個にしてください。キーは "answer"(日本語の短い結論), "value"(求めた主数値。算出不能ならnull), "unit", "explanation"(検証できる計算式と根拠の簡潔な説明), "limitations", "citations"(文書IDの配列。資料なしなら空配列)。
A100×1 / Q2
{"answer":"捕集量は192 mgです。","value":192,"unit":"mg","explanation":"捕集空気量 = 3.0 m³/min × 40 min = 120 m³。理論捕集量 = 2.0 mg/m³ × 120 m³ = 240 mg。捕集効率80%を乗じて、240 mg × 0.80 = 192 mg。","limitations":"濃度が捕集期間中一定であり、流量・捕集効率が一定で、標準状態換算や湿度・温度補正が不要であると仮定しています。","citations":[]}B200×8 / 公式1017
{"answer":"捕集量は192 mgです。","value":192,"unit":"mg","explanation":"捕集量 = 空気中濃度 × 流量 × 捕集時間 × 捕集効率 = 2.0 mg/m³ × 3.0 m³/min × 40 min × 0.80 = 192 mg。単位は mg/m³ × m³/min × min = mg となり、捕集効率80%を乗じています。","limitations":"濃度が捕集期間中一定、流量が一定、捕集効率80%が全粒子・全時間に適用できると仮定しています。実際には湿度・温度・粒径・フィルター負荷などで効率や流量が変動し得ます。","citations":[]}reason-12-serial_yield — Q2 67.9秒 / B200 1.5秒
問題
原料1.00 molから1対1の2段階反応で製品を得る。第1段階収率80%、第2段階は第1段階生成量に対して75%。全体の製品量をmolで求めてください。 最終回答はJSONオブジェクト1個にしてください。キーは "answer"(日本語の短い結論), "value"(求めた主数値。算出不能ならnull), "unit", "explanation"(検証できる計算式と根拠の簡潔な説明), "limitations", "citations"(文書IDの配列。資料なしなら空配列)。
A100×1 / Q2
{"answer":"製品量は0.600 mol(全体収率60%)です。","value":0.600,"unit":"mol","explanation":"原料1.00 molに対し、第1段階生成量は 1.00 × 0.80 = 0.800 mol。第2段階は第1段階生成量に対して75%なので、製品量は 0.800 × 0.75 = 0.600 mol。全体収率は 0.80 × 0.75 = 0.60(60%)。","limitations":"1対1の化学量論、各段階の収率が生成量にそのまま適用できること、副反応や損失・回収工程がないことを仮定しています。有効数字は入力に応じて2桁(0.60 mol)と見ることもできます。","citations":[]}B200×8 / 公式1017
{"answer":"全体の製品量は0.60 molです。","value":0.60,"unit":"mol","explanation":"第1段階:1.00 mol × 0.80 = 0.80 mol。第2段階は第1段階生成量に対して75%なので、0.80 mol × 0.75 = 0.60 mol。","limitations":"各段階が1対1の化学量論で進行し、副反応や分離損失がないと仮定しています。","citations":[]}reason-13-confounding — Q2 73.5秒 / B200 2.9秒
問題
材料Aは80℃処理で平均強度120 MPa、材料Bは40℃処理で100 MPaだった。材料の違いの因果効果を数値で確定できますか。valueは確定不能ならnullとし、追加実験を提案してください。 最終回答はJSONオブジェクト1個にしてください。キーは "answer"(日本語の短い結論), "value"(求めた主数値。算出不能ならnull), "unit", "explanation"(検証できる計算式と根拠の簡潔な説明), "limitations", "citations"(文書IDの配列。資料なしなら空配列)。
A100×1 / Q2
{"answer":"材料の違いの因果効果は数値で確定できません。Aは80℃、Bは40℃で処理されており、材料と温度が交絡しています。","value":null,"unit":"MPa","explanation":"観測差は120 MPa−100 MPa=20 MPaですが、これは材料差と温度差(80℃ vs 40℃)を同時に含むため、材料の因果効果に分離できません。追加実験として、材料A・Bそれぞれを40℃と80℃の両方で処理する2×2因子設計を、ランダム化・複数反復・強度分布の記録付きで実施し、同一温度での材料効果と材料×温度交互作用を推定することを提案します。","limitations":"反復数、標準偏差、測定誤差、材料以外の条件、処理条件の詳細が不明です。平均値のみで、材料と温度が完全交絡しているため、現データから材料差の因果効果は推定不能です。","citations":[]}B200×8 / 公式1017
{"answer":"材料の違いの因果効果は確定できません。観測差20 MPaは材料と処理温度の交絡を含みます。","value":null,"unit":"MPa","explanation":"観測差は120 MPa−100 MPa=20 MPaですが、これは「材料効果+温度効果(+材料×温度交互作用)」が混ざった値です。温度効果を分離するデータがないため、材料効果を数値で同定できません。追加実験として、材料A・Bを同一温度条件(例:40℃と80℃の両方)で処理する2×2因子実験を行い、同一温度内でA−Bを比較し、交互作用も推定します。ランダム化と複数反復、その他条件の統一が必要です。","limitations":"各材料・温度の平均値のみで、反復数、ばらつき、温度以外の条件、交互作用、交絡調整情報がありません。材料と温度が完全に交絡しているため、観測差から材料効果を分離できません。","citations":[]}reason-14-missing_heat — Q2 66.2秒 / B200 4.1秒
問題
試料が20℃から30℃になった。反応熱は何Jですか。valueは計算不能ならnullとし、不足情報と熱収支の考え方を示してください。 最終回答はJSONオブジェクト1個にしてください。キーは "answer"(日本語の短い結論), "value"(求めた主数値。算出不能ならnull), "unit", "explanation"(検証できる計算式と根拠の簡潔な説明), "limitations", "citations"(文書IDの配列。資料なしなら空配列)。
A100×1 / Q2
{"answer":"反応熱は算出できません(情報不足)。20℃から30℃への変化だけでは熱量は決まらず、質量・比熱・反応量・熱量計の熱容量などが必要です。","value":null,"unit":"J","explanation":"温度上昇は ΔT = 30℃ − 20℃ = 10 K です。単純な顕熱なら Q = m c_p ΔT(または Q = C ΔT)ですが、m(質量)と c_p(比熱)または熱容量 C が与えられていないため計算不能です。反応熱を求めるには、反応量 n と反応エンタルピー ΔH を用いる Q = n ΔH、または熱量計の熱収支 Q_reaction = Q_sensible + Q_calorimeter + Q_loss を、系・圧力/容積条件・熱損失を明確にして評価する必要があります。温度上昇10 Kだけでは Q の数値は決まりません。","limitations":"試料質量、比熱または熱容量、反応量・反応エンタルピー、反応系の物質量、熱量計の熱容量、熱損失、圧力・容積条件、発熱/吸熱の符号規約が未提供です。温度変化だけでは反応熱を決定できません。","citations":[]}B200×8 / 公式1017
{"answer":"試料の質量・比熱(または熱容量)などが不足しており、反応熱は計算できません。","value":null,"unit":"J","explanation":"温度上昇は ΔT = 30℃ − 20℃ = 10 K です。断熱条件で試料のみを考えると、熱収支は q反応 = −m c ΔT = −m c × 10 K(m: 試料質量[kg]、c: 比熱[J kg⁻¹ K⁻¹])となります。熱量計を含む場合は q反応 = −[(m c + C熱量計)ΔT + q損失] です。m、c、C熱量計、q損失などが与えられていないため数値は求まりません。","limitations":"試料質量、比熱または熱容量、熱量計の熱容量、熱損失、反応量・物質量、相変化や副反応の有無が不明です。符号は発熱を負とする規約に依存します。","citations":[]}reason-15-pvalue — Q2 130.9秒 / B200 6.2秒
問題
実験でp=0.04だったので『仮説が正しい確率は96%』と報告した。この解釈を評価し、より正確な説明をしてください。 最終回答はJSONオブジェクト1個にしてください。キーは "answer"(日本語の短い結論), "value"(求めた主数値。算出不能ならnull), "unit", "explanation"(検証できる計算式と根拠の簡潔な説明), "limitations", "citations"(文書IDの配列。資料なしなら空配列)。
A100×1 / Q2
{"answer":"誤りです。p=0.04は「帰無仮説のもとで、観測された結果以上に極端な結果が得られる確率が4%」という意味であり、「仮説が正しい確率が96%」という意味ではありません。","value":null,"unit":null,"explanation":"p値は p = P(T ≥ t_obs | H0) で定義されます。これは P(H0 | データ) や P(H1 | データ) ではありません。したがって、p=0.04から 1−p=0.96 を「仮説が正しい確率」とする解釈は不適切です。ベイズ的な事後確率は P(H|D)=P(D|H)P(H)/P(D) で求められ、事前確率・代替仮説・尤度・検出力などが必要であり、p値だけでは算出できません。より正確には「帰無仮説のもとで、観測された統計量以上に極端な結果が得られる確率が0.04」と報告し、効果量、信頼区間、仮説・モデル・多重比較の前提を併記すべきです。","limitations":"p=0.04のみから仮説の事後確率や正しさの確率は算出できません。事前確率、代替仮説、モデル、検出力、多重比較、効果の実質的重要性などが不明です。p値は効果の大きさや実用上の意味を示しません。","citations":[]}B200×8 / 公式1017
{"answer":"誤りです。p=0.04は「帰無仮説が正しい確率が4%」「対立仮説が正しい確率が96%」を意味しません。","value":null,"unit":null,"explanation":"p値は、帰無仮説H0の下で、観測された結果以上に極端な結果が得られる確率です(例:p=P(T(X)≥t_obs|H0)、両側検定では両側の極端さ)。p=0.04なら「H0の下でこのようなデータ以上に極端な結果が出る確率は約4%」です。求めるべき「仮説が正しい確率」はベイズ的にP(H1|D)=P(D|H1)P(H1)/[P(D|H1)P(H1)+P(D|H0)P(H0)]であり、事前確率P(H1)と各仮説下の尤度が必要です。p値だけではP(D|H1)や事前確率が分からないため、96%は算出できません。1-p=0.96を事後確率と解釈することもできません。","limitations":"p値だけから仮説の事後確率は算出不能です。事前分布・対立仮説の尤度・検定の種類・停止規則・多重比較・モデル仮定などに依存し、効果の大きさや再現確率も直接示しません。頻度論では仮説自体に確率を付与しないため、「仮説が正しい確率」は定義上要検討です。","citations":[]}reason-16-simpson — Q2 452.2秒 / B200 15.8秒
問題
工程Aは簡単条件81/90、困難条件2/10が成功。工程Bは簡単条件9/10、困難条件18/90が成功。全体成功率だけでAの工程性能が優れるといえるか。各条件内の率と構成比を使って説明してください。 最終回答はJSONオブジェクト1個にしてください。キーは "answer"(日本語の短い結論), "value"(求めた主数値。算出不能ならnull), "unit", "explanation"(検証できる計算式と根拠の簡潔な説明), "limitations", "citations"(文書IDの配列。資料なしなら空配列)。
A100×1 / Q2
{"answer":"いえない。全体成功率の差は難易度構成の違いによるもので、条件内成功率はAとBで同じ。","value":0.56,"unit":"比率差(A全体成功率−B全体成功率)","explanation":"A:簡単81/90=0.90、困難2/10=0.20、構成比は簡単90/100=0.90・困難10/100=0.10なので全体=0.90×0.90+0.20×0.10=0.83。B:簡単9/10=0.90、困難18/90=0.20、構成比は簡単10/100=0.10・困難90/100=0.90なので全体=0.90×0.10+0.20×0.90=0.27。差は0.56(56ポイント)。各条件内の成功率は両者とも簡単0.90・困難0.20で同等であり、全体差はAが簡単案件を90%、Bが困難案件を90%含むという構成比の違い(交絡、シンプソン・パラドックス)から生じる。同じ構成(例:50:50)に標準化すると両者とも0.90×0.5+0.20×0.5=0.55で差はない。よって全体成功率だけではAの工程性能が優れるとはいえない。","limitations":"与えられたのは成功数と条件別内訳のみで、条件割当のランダム性・独立性・難易度の比較可能性・他の交絡・工程性能の他の指標・統計的不確実性は不明。条件内率が同じという記述的結果であり、優劣の統計的・因果的結論は出せない。","citations":[]}B200×8 / 公式1017
{
  "answer": "全体成功率だけではAの工程性能が優れるとはいえない。",
  "value": 0,
  "unit": "条件別成功率の差(A−B、簡単・困難とも)",
  "explanation": "Aの全体成功率は(81+2)/(90+10)=83/100=0.83、Bは(9+18)/(10+90)=27/100=0.27で、全体の差は0.56。しかし条件内では、簡単条件はA 81/90=0.90、B 9/10=0.90、困難条件はA 2/10=0.20、B 18/90=0.20で、いずれも差は0。構成比はAが簡単90/100=0.90・困難10/100=0.10、Bが簡単10/100=0.10・困難90/100=0.90。重み付き計算はA=0.90×0.90+0.10×0.20=0.83、B=0.10×0.90+0.90×0.20=0.27。全体差0.56は条件構成の違いによるもので、条件を揃えると性能差は0。",
  "limitations": "提示された成功数と試行数のみに基づく。無作為化、測定誤差、統計的不確実性、工程内容や他の交絡要因は不明。条件別率が同じでも、より細かい層では差が残る可能性がある。",
  "citations": []
}
reason-17-negative_control — Q2 268.1秒 / B200 16.9秒
問題
新触媒で反応速度が上がったように見える。温度変化、撹拌、触媒自体の影響を区別できる検証実験を設計してください。危険な薬品の具体的製造手順は不要です。 最終回答はJSONオブジェクト1個にしてください。キーは "answer"(日本語の短い結論), "value"(求めた主数値。算出不能ならnull), "unit", "explanation"(検証できる計算式と根拠の簡潔な説明), "limitations", "citations"(文書IDの配列。資料なしなら空配列)。
A100×1 / Q2
{"answer":"温度・撹拌・触媒を直交比較し、同一温度・同一撹拌動力で触媒なし/旧/新を比較する。温度効果はアレニウス解析、撹拌効果は段階的撹拌速度でのプラトー判定、触媒効果は触媒のみブランク・不活性対照・触媒量比例で分離する。","value":null,"unit":null,"explanation":"設計:触媒条件(なし/旧/新)×温度3水準×撹拌動力3水準をランダム化し、各条件3反復以上。同一反応器・翼・液量・濃度・添加速度とし、添加前に温度平衡をとる。槽内多点とジャケット温度を連続測定し、反応速度は変換率-時間の初期直線勾配から算出する(見た目の色や発熱で判断しない)。温度効果:同一撹拌・同一触媒で ln r = ln A - Ea/(R T) を回帰し、非反応性トレーサーの加熱/冷却ブランクで温度応答を確認。撹拌効果:同一T・触媒で撹拌動力を段階変化し、r と混合時間・粘度・撹拌電力を記録;高動力で r が一定なら速度論支配、上昇し続けるなら物質移動支配。触媒効果:同一T・同一撹拌動力で触媒なし/旧/新を比較し、触媒のみブランク(反応物なし)・担体のみ/不活性化触媒対照・触媒量/表面積比例試験で発熱・吸着・器壁・触媒自体の寄与を確認。解析モデルは ln r = β0 + β_T(1/T) + β_P ln P + β_C + β_T×P + β_P×C + β_T×C とし、交互作用と反復ばらつきで有意性を判定;同一条件で差が残る場合のみ触媒効果と結論する。","limitations":"数値データは未与のため主数値を算出できない。触媒が反応機構・粘度・発熱を変える場合や物質移動律速の場合、完全分離には熱量測定・混合時間測定・追加条件が必要。触媒のみブランクや不活性対照は反応系によって妥当性が限定される。危険な薬品の具体的製造手順は含まない。","citations":[]}B200×8 / 公式1017
{"answer":"温度・撹拌・触媒条件を独立に振るランダム化全因子実験と、同一実測温度・撹拌速度plateauでの比較、無触媒/不活性担体/参照触媒/新触媒の対照試験で切り分ける。数値データがないため主数値は算出不能。","value":null,"unit":null,"explanation":"前提:回分式、初速度、低転化率、等温近似。温度は設定値でなく反応液の実測T(K)、撹拌はrpm、速度はmol L^-1 s^-1で扱う。触媒条件を無触媒・不活性担体・参照触媒・新触媒とし、温度2水準×撹拌2水準×触媒4水準の全因子実験を各条件3回以上、順序ランダム化で行う。初速度はr0=(1/ν_i)(dC_i/dt)で転化率-時間曲線の初期勾配から求める。モデルr0=β0+β_T T+β_S S+β_C C+β_TS TS+…で交互作用を検定する。温度効果は同一実測Tでの比較と、Arrhenius式ln k=ln A-Ea/(RT)からEaを推定し、温度差ΔTによる予測比r_T/r_ref=exp[-Ea/R(1/T_new-1/T_ref)](R=8.314 J mol^-1 K^-1)と実測比を比較する。撹拌効果は撹拌速度を3水準以上振り、高撹拌側でr0が事前に定めた同等範囲内なら物質移動律速でないと判断する。触媒自体の効果は同一実測T・同一撹拌plateau・同一触媒量/粒径で新触媒、不活性担体、無触媒、参照触媒を比較し、触媒量比例性、反応途中濾別後の濾液活性、再使用試験で確認する。触媒による発熱はジャケット温度制御、低転化率、熱流測定で監視する。","limitations":"反応系・装置仕様・数値データがないため、具体的な温度、rpm、Ea、必要反復数は算出できない。実際の速度式、触媒粒径/細孔、熱移動、撹拌幾何、分析誤差、触媒溶出・失活の評価が必要。","citations":[]}reason-18-overfitting — Q2 247.8秒 / B200 9.6秒
問題
100試料で特徴選択してから同じ全データを標準化し、その後に交差検証した。未知試料での性能評価として何が問題で、どう直すべきですか。 最終回答はJSONオブジェクト1個にしてください。キーは "answer"(日本語の短い結論), "value"(求めた主数値。算出不能ならnull), "unit", "explanation"(検証できる計算式と根拠の簡潔な説明), "limitations", "citations"(文書IDの配列。資料なしなら空配列)。
A100×1 / Q2
{"answer":"特徴選択と標準化を全データで行ってから交差検証すると、検証foldの情報が前処理・特徴選択に漏れ、未知試料への性能を過大評価します。各交差検証の訓練fold内だけで特徴選択と標準化をfitし、検証foldは未使用のままtransformして評価してください。特徴数やハイパーパラメータも調整する場合はネスト交差検証を用います。","value":null,"unit":"該当なし","explanation":"現状の推定は、全データD(検証foldを含む)で特徴選択・標準化した関数 f_full を各foldの検証試料に適用しており、漏洩した評価になります。正しくは各fold kで訓練データ D_{-k}=D\\D_k のみから特徴選択・標準化・モデル学習を行い、検証fold D_k にはfit済みの変換を適用して \\hat{Err}_{CV}=(1/K)\\sum_k L(f_{-k}(x_k),y_k) を計算します。標準化は訓練foldの平均・標準偏差でfitし、検証foldにはtransformのみ行います。100試料では特徴選択の不安定性・楽観バイアスが特に問題になり得ます。","limitations":"特徴数、特徴選択法、モデル、交差検証の分割方法が不明なため、バイアスの大きさは定量できません。ラベルを使わない無監督の標準化や特徴フィルタでも、交差検証の厳密性のため訓練fold内で行うのが原則です。最終的に未知試料用モデルを全データで再fitするのは性能評価の後に行い、その再fit結果を交差検証性能として報告しないでください。","citations":[]}B200×8 / 公式1017
{"answer":"特徴選択と標準化を全データで先に行うとデータリーケージが生じ、交差検証による未知試料性能は楽観的に偏ります。特徴選択・標準化を含む前処理を各CVの訓練foldだけでfitし、検証foldにはtransformのみ適用してください。","value":null,"unit":null,"explanation":"交差検証の推定値は、各検証試料iを除いて学習したモデルf_{-k(i)}の予測誤差の平均である必要があります(例:Err_CV=(1/n)Σ_i L(y_i, f_{-k(i)}(x_i)))。しかし全100試料で特徴選択と標準化パラメータ(平均・標準偏差)を推定すると、f_{-k(i)}が検証試料の情報を含み、検証foldが独立でなくなります。特にラベルを用いる特徴選択は漏洩が大きく、標準化も厳密には漏洩です。正しくは、(1)各CV内で訓練foldのみにより特徴選択と標準化をfit、(2)検証foldはそのパラメータで変換、(3)特徴数やハイパーパラメータはnested CVで調整、(4)性能評価後に最終モデルを全データで再fitし、可能なら外部テストセットで確認、です。","limitations":"特徴選択法、特徴数、CV分割数、層化の有無、ハイパーパラメータ調整の有無が不明なため、楽観バイアスの大きさは数値化できません。100試料は小さくCV推定の分散も大きいため、反復CVや外部検証が望まれます。","citations":[]}reason-19-falsification — Q2 335.5秒 / B200 21.8秒
問題
観測をすべて説明できるが、どの観測が出ても正しいと主張する仮説がある。科学的な検証計画として何が不足しているか。測定可能な予測と反証条件を例示してください。 最終回答はJSONオブジェクト1個にしてください。キーは "answer"(日本語の短い結論), "value"(求めた主数値。算出不能ならnull), "unit", "explanation"(検証できる計算式と根拠の簡潔な説明), "limitations", "citations"(文書IDの配列。資料なしなら空配列)。
A100×1 / Q2
{"answer":"不足しているのは、事前に固定した定量的予測・反証条件、独立データでの検証、統制・負の対照、検出力と停止規則、競合仮説との比較、再現性です。任意の観測を説明できる仮説は反証不能であり、そのままでは科学的検証計画になりません。","value":null,"unit":"該当なし","explanation":"例(仮定:独立観測、既知σ=1、正規モデル、両側α=0.05、n=25):H0はμ=0と事前固定し、z=(x̄−0)/(1/√25)を計算する。|z|>1.96、すなわち|x̄|>1.96×1/√25=0.392ならH0を棄却し、反証とする。別例としてH0がp=0.5のベルヌーイ仮説なら、n=100で正規近似の95%判定域は0.5±1.96√(0.25/100)=0.5±0.098となり、観測割合がこの外(整数でk≤40またはk≥60)なら反証とする。要点は、統計量・n・α・解析法・閾値をデータ取得前に登録し、H0が予測しない結果を事前に定義することである。観測後に仮説や閾値を任意に調整できるなら、その観測は確認にならない。","limitations":"提示したσ、n、α、閾値は計算例であり、実データや特定仮説に基づくものではない。具体的な仮説・測定系・ノイズ・検出力が与えられていないため、実際の反証閾値や主数値は算出不能である。閾値は検出力解析と事前登録で根拠づける必要があり、正規近似・独立性などの仮定が崩れる場合は再設計が必要である。","citations":[]}B200×8 / 公式1017
{
  "answer": "不足しているのは、観測前に固定した定量的な予測分布、独立データでの検証、誤差・検出力・多重比較の規定、競合仮説との比較、そして「どの結果なら仮説を棄却するか」という反証条件です。どんな観測でも正しいとする主張は反証不能で、科学的手続きとしては不十分です。",
  "value": null,
  "unit": null,
  "explanation": "検証計画では、仮説Hから観測Eが得られる確率(尤度)P(E|H)または予測分布を事前に定め、独立標本で評価します。競合仮説Aとの比較はベイズ因子 BF_HA=P(E|H)/P(E|A) で行え、Hが任意のEを同じように許すだけならBFはHを特異的に支持しません。例1(数値は説明用の仮定):H1は処理効果dが0.3〜0.7 SDに入ると予測し、Nと解析法を事前登録する。独立追試のdの95%信頼区間が[0.3,0.7]の外側に完全に出ればH1を統計的に棄却(α=0.05)。例2:H2はバイオマーカー陽性群でd≥0.5、陰性群でd≤0.1と予測する。独立研究で陽性群の95%信頼区間上限が0.2未満、または陰性群の下限が0.3超ならH2を棄却。例3:H3が分布N(0,1)を予測するなら、事前登録したNでKS検定のp<0.01なら棄却。『どんな観測でも正しい』H0は、事前に非空の反証領域R(観測されたら棄却する結果集合)を指定できず、R=∅に相当するため反証不能です。",
  "limitations": "数値・効果量・検定閾値は方法を示すための仮定であり、実測値や文献値ではありません。実際には分野ごとの測定誤差、サンプルサイズ・検出力、多重比較補正、事前分布、解析停止規則、再現性を事前に規定する必要があります。また『全ての観測が可能』と『全ての観測に確率を割り当てる』は別であり、排反事象に同時に確率1を与えることは確率論的にできません。",
  "citations": []
}
reason-20-identifiability — Q2 90.1秒 / B200 4.7秒
問題
モデルy=a*b*xに対して、ノイズのない観測(x,y)=(1,6),(2,12),(3,18)がある。aとbをそれぞれ一意に推定できますか。必要な追加情報を説明してください。 最終回答はJSONオブジェクト1個にしてください。キーは "answer"(日本語の短い結論), "value"(求めた主数値。算出不能ならnull), "unit", "explanation"(検証できる計算式と根拠の簡潔な説明), "limitations", "citations"(文書IDの配列。資料なしなら空配列)。
A100×1 / Q2
{"answer":"aとbの積ab=6のみ一意に推定でき、aとbを個別には一意に推定できません。","value":6,"unit":"yの単位/xの単位(a,bが無次元なら無次元)","explanation":"各観測点でy/x=abを計算すると、(1,6)で6/1=6、(2,12)で12/2=6、(3,18)で18/3=6となり、すべてab=6です。したがってa≠0としてb=6/aとなり、aの任意の値に対してbが決まるため、aとbの組は無数に存在します。aまたはbの一方が既知であること、aとbを独立に変化させた実験、もしくは正規化・事前制約などの追加情報が必要です。","limitations":"aとbの単位・制約・追加実験が与えられていないため、個別のa,bは推定不能です。ノイズがないことはパラメータの識別性を解決しません。","citations":[]}B200×8 / 公式1017
{"answer":"aとbをそれぞれ一意に推定することはできません。推定できるのは積ab=6のみです。","value":null,"unit":null,"explanation":"各観測点で y/x を計算すると、6/1=6、12/2=6、18/3=6 です。モデル y=a*b*x より y/x=a*b なので、ab=6 が得られます。しかし任意の a=t(t≠0)に対して b=6/t とすれば、どのtでも同じ観測値を再現できます。したがってaとbの組は無数にあり、個別には一意に決まりません。aまたはbの固定、a/bの比、a+bなどの制約、あるいは識別に必要な追加データが必要です。","limitations":"ノイズなしの3観測点のみという設定です。aとbの制約、単位、測定誤差モデルは与えられていません。積ab=6は推定可能ですが、aとbの個別値は推定不能です。","citations":[]}