GLM-5.3-FlashをB200・H100×2で実測:MTPの回答品質、1Mバッファと推論速度
H100×2でGLM-5.3-Flashは指定条件の生成速度50 tokens/s超。MTPの基礎、1M容量での待ち時間、出力上限4,096・8,192の288回答、個別の誤答と限界を公開します。
生成AIの返答を速くしたい。でも、速くするために回答の正確さが落ちてしまっては困ります。本記事では、文章の「先読み」を利用するMTPについて、速さと回答品質を分けて確かめます。
MTPとは何か:文章の続きを先読みする仕組み
生成AIは文章をトークンという小さな単位で扱います。1トークンが1文字や1単語と同じとは限りません。通常の文章生成では、次のトークンを一つずつ決め、文章を伸ばしていきます。
MTP(Multi-Token Prediction)は、先の複数のトークンを予測する仕組みです。今回は、この予測を本体モデルによる検証と組み合わせ、文章生成の高速化に利用します。
- 先読みする:文章の続きとなるトークンの候補を作ります。
- 本体モデルで検証する:候補をまとめて検証し、採用できる部分を進めます。一致しない所より先の候補は使わず、作り直します。
- 処理を効率化する:複数トークンをまとめて進められれば、重い本体の処理を一つずつ繰り返す回数を減らせます。
先読みや検証にも計算・メモリの負担があります。候補が採用される割合も変わるため、「3トークン先を予測すれば3倍速くなる」という意味ではありません。
ここでいう「検証」は、回答の事実や計算が正しいかを確認することではありません。本体モデルが選ぶトークンとの整合を調べる処理です。元のモデルの誤答を自動で直す仕組みではないため、生成速度とは別に回答品質も測る必要があります。以下では、この先読みを使う条件を「MTPあり」、使わない条件を「MTPなし」と呼びます。
今回、何を確かめるのか
「どれだけ速くなるか」と「回答品質は落ちないか」を、同じモデル・同じ入力を使って比較します。確認するのは次の3点です。
- 回答の出始め:質問してから、最初の回答本文が届くまでの時間。
- 生成速度:生成中の1秒あたりのトークン数(tokens/s)。日本語の文字数毎秒とは別です。
- 回答品質:事前に正解を決めた問題での正答率と、実際に生じた誤答や回答の打切り。
GLM-5.3-Flashはモデルの名前、llama.cppとExLlamaV3はモデルを動かすソフト、B200とH100は計算に使うGPUです。本記事では各構成の実測を示しますが、ソフトだけでなく量子化やGPU数が違う比較は、その条件差も明記します。
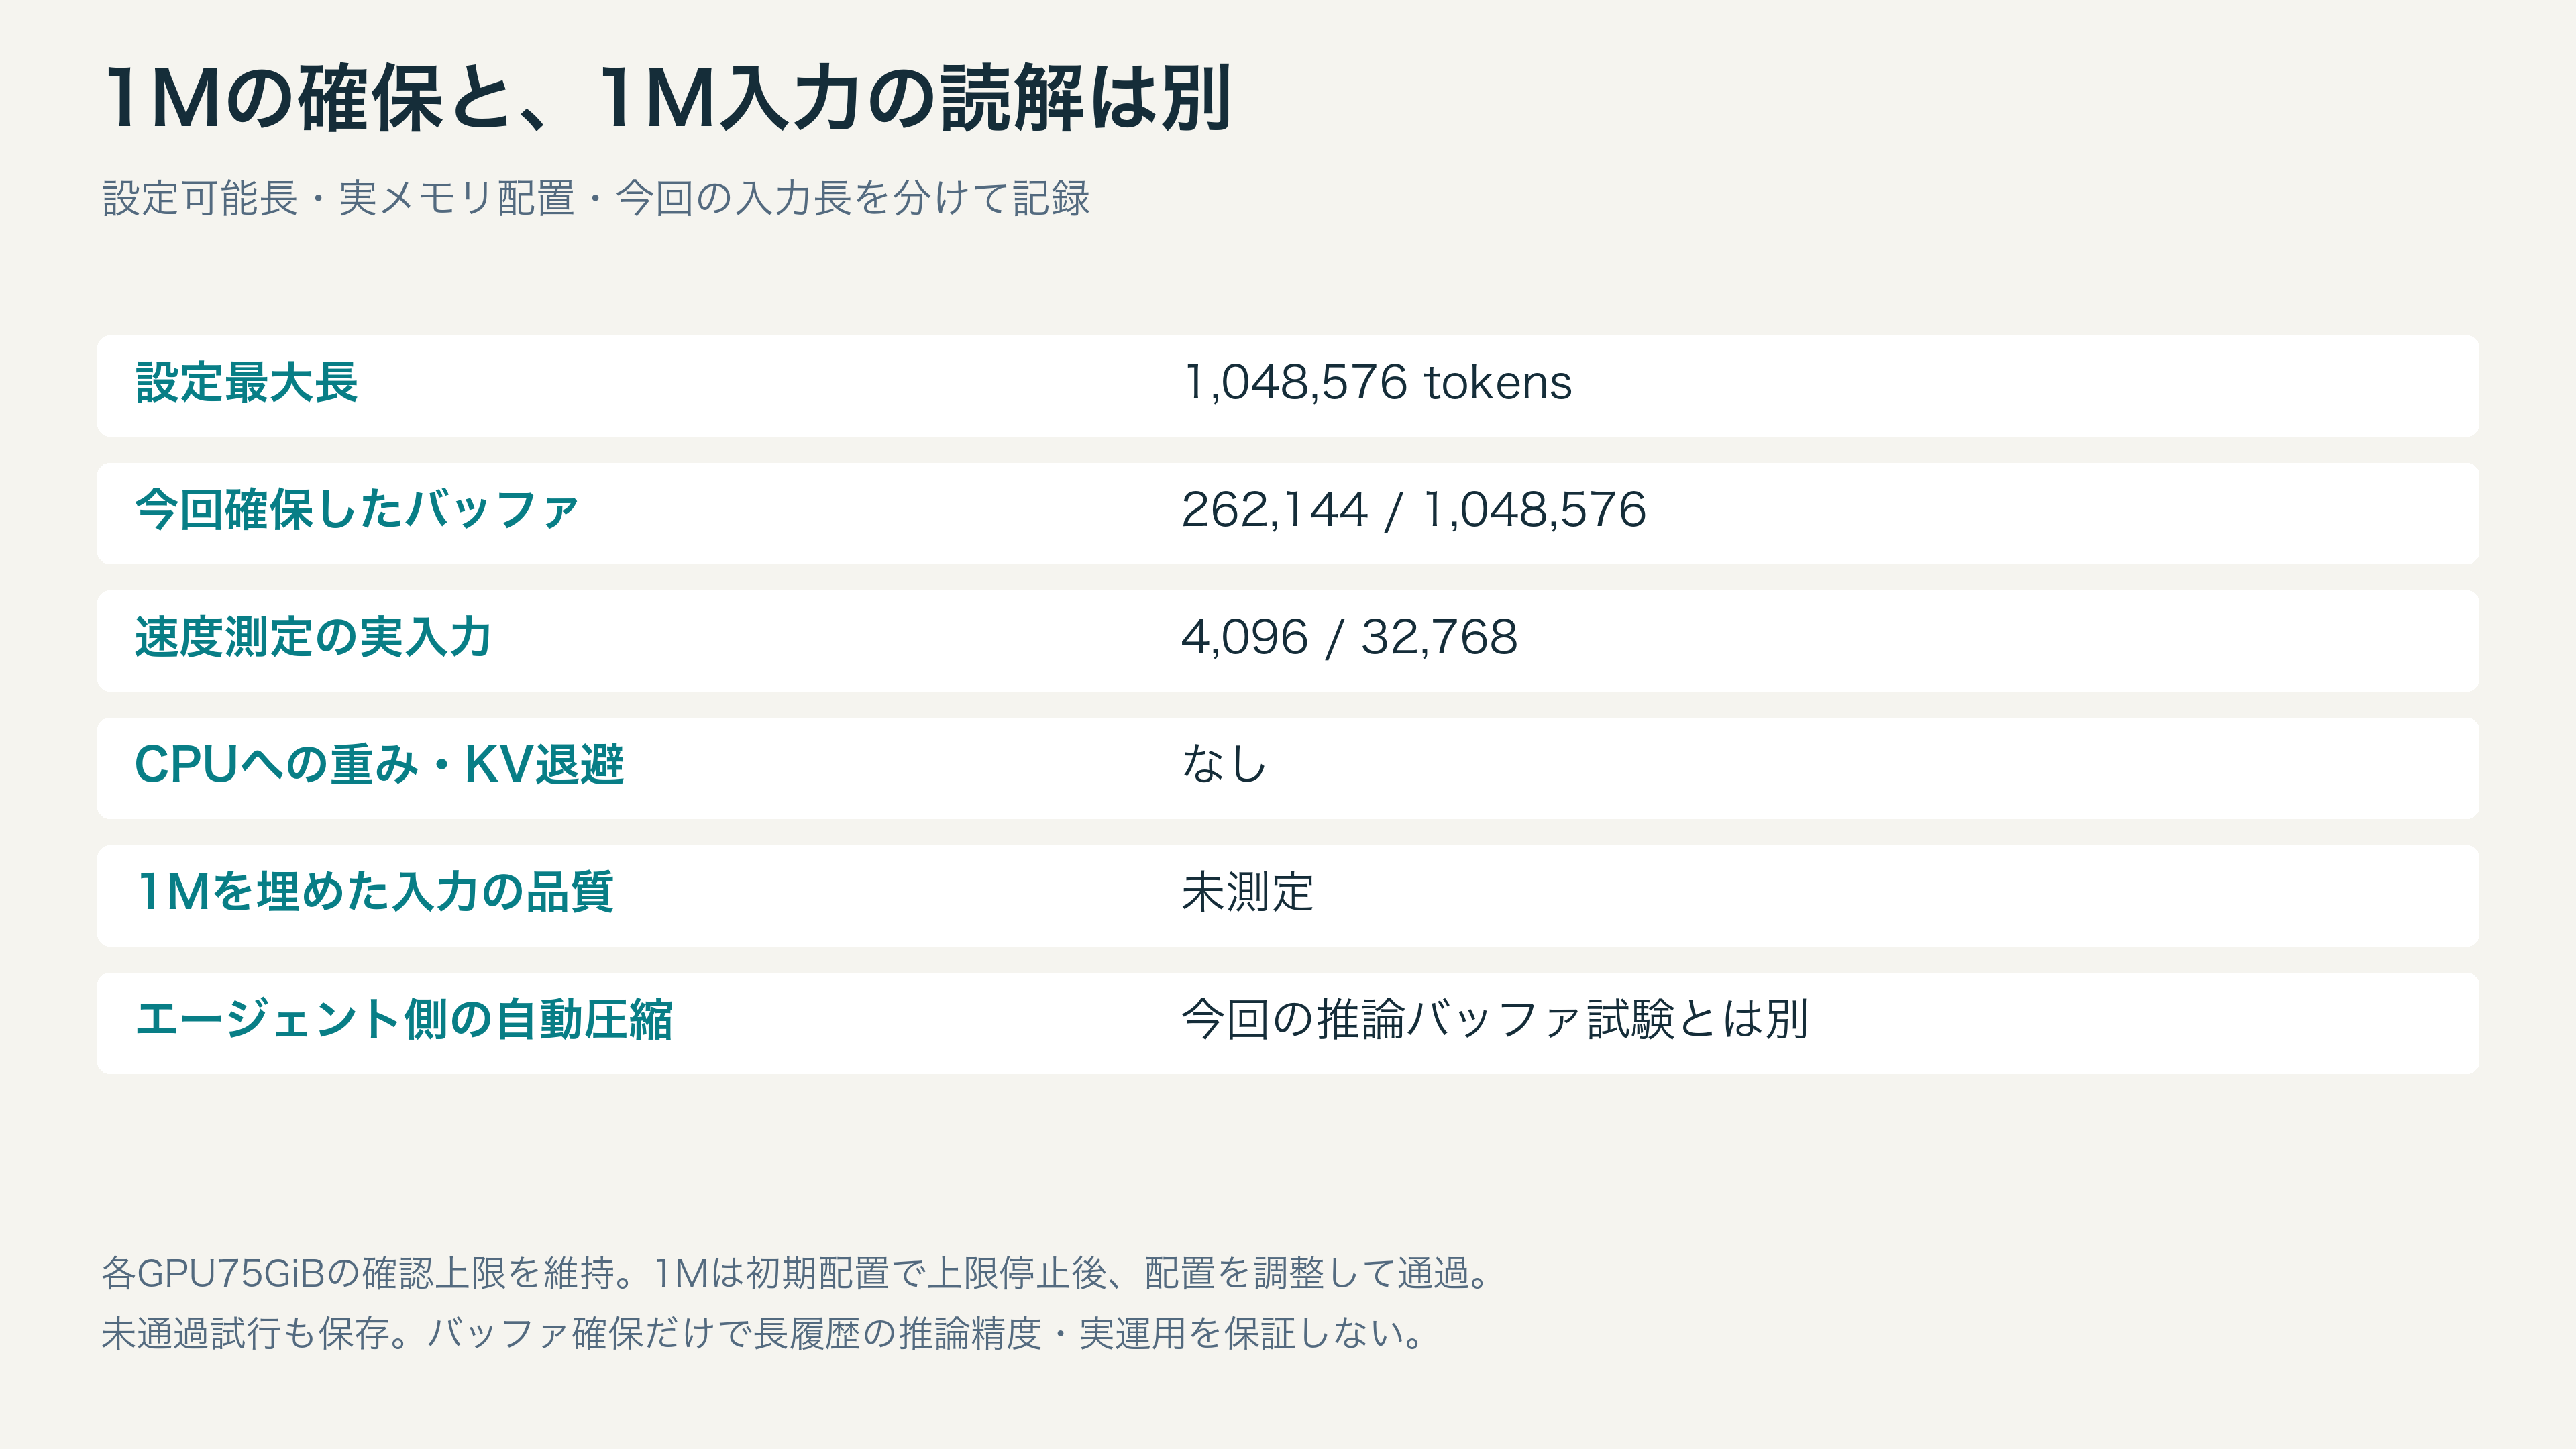
さらに、入力などを保持するコンテキストバッファの容量を増やした場合も確認しました。容量は256K・1M(正確には262,144・1,048,576トークン)、実際に入れた文章は4K・32Kです。「入れられる枠」と「実際に入れた長さ」は区別し、1Mまで埋めた入力の理解やエージェントの長時間動作を確認したとは扱いません。
H100×2の品質比較・大容量バッファの詳しい結果へ。まずH100×2で50 tokens/sを超えた構成と判断の範囲を示し、出力上限を増やした追加試験、従来の比較、詳細な根拠を続けます。
MTPの基礎と出力上限の追加試験を解説する改訂版をYouTubeで見る(日本語Marin合成音声・4K・字幕)
結果の要点と、言える範囲
H100 80GB×2・ExLlamaV3の1Mバッファでは、MTPありの生成速度中央値は4K入力で79.59、32K入力で75.13 tokens/sでした。最初の回答本文までは、それぞれ1.68秒・10.83秒です。この速度確認用タスクでは生成中の速度が上がり、本文開始はわずかに遅くなりました。下記の追加資料課題では、思考量も異なるため待ち時間を別に報告します。
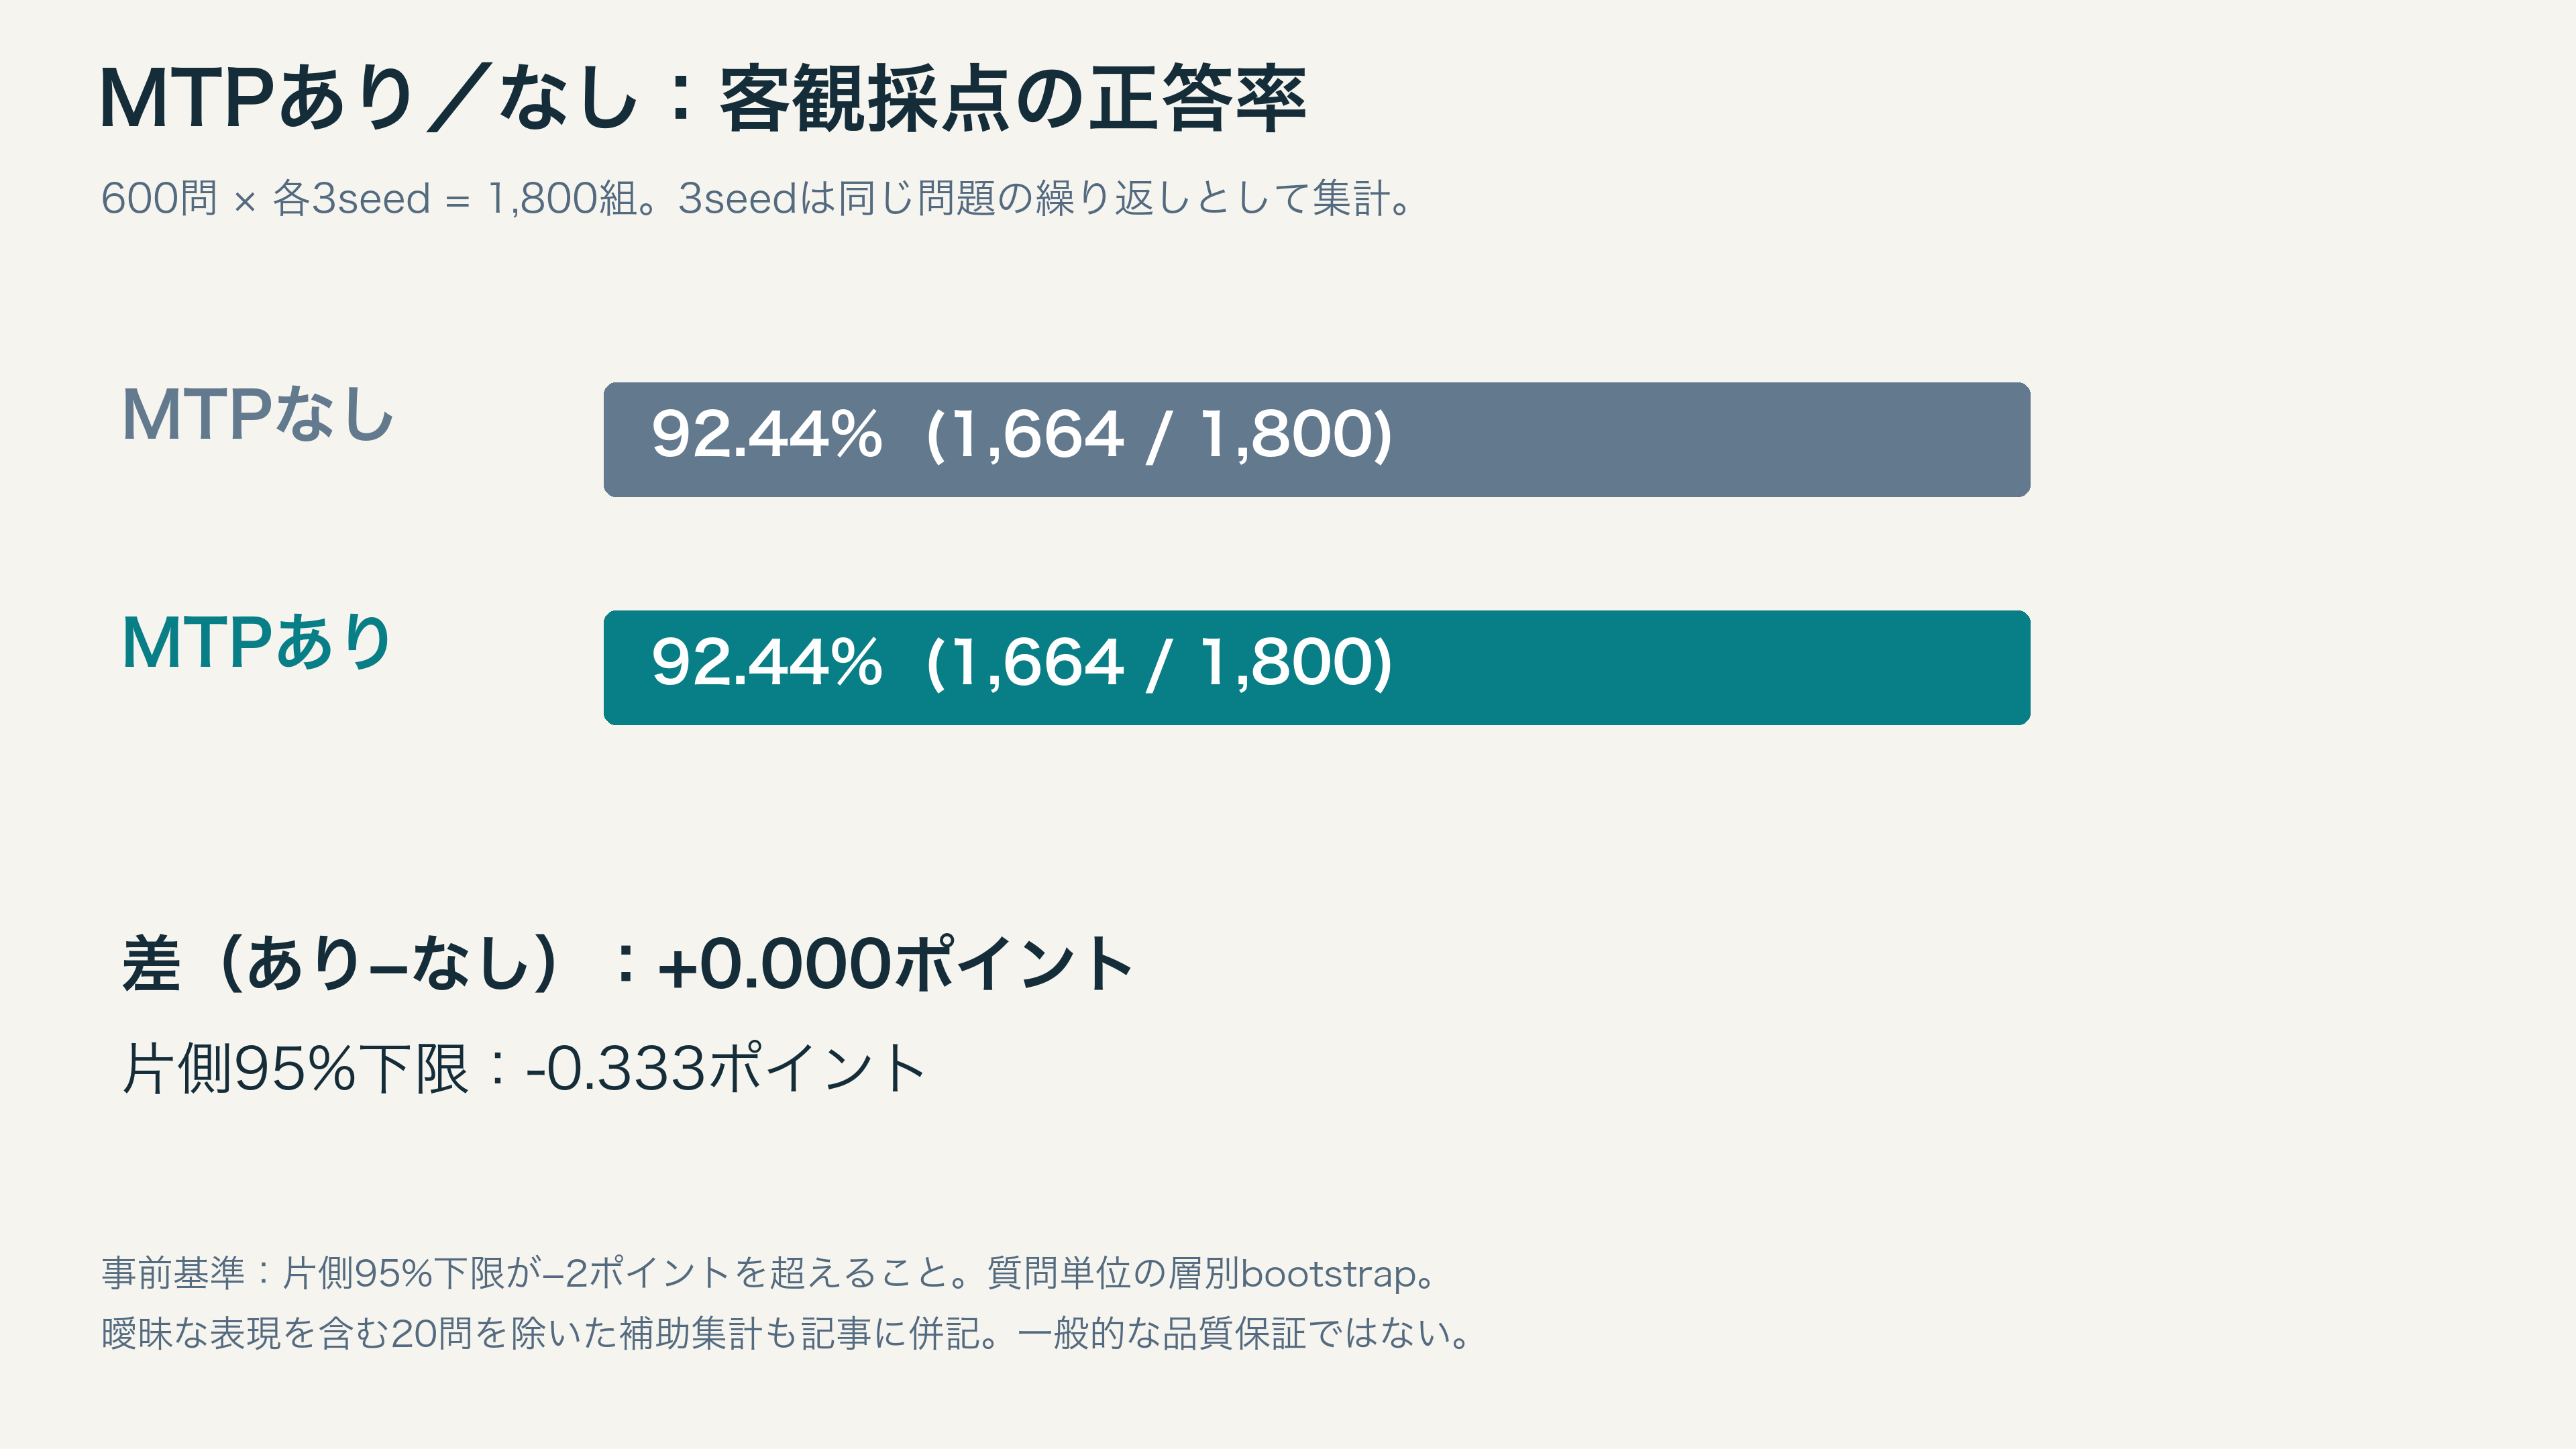
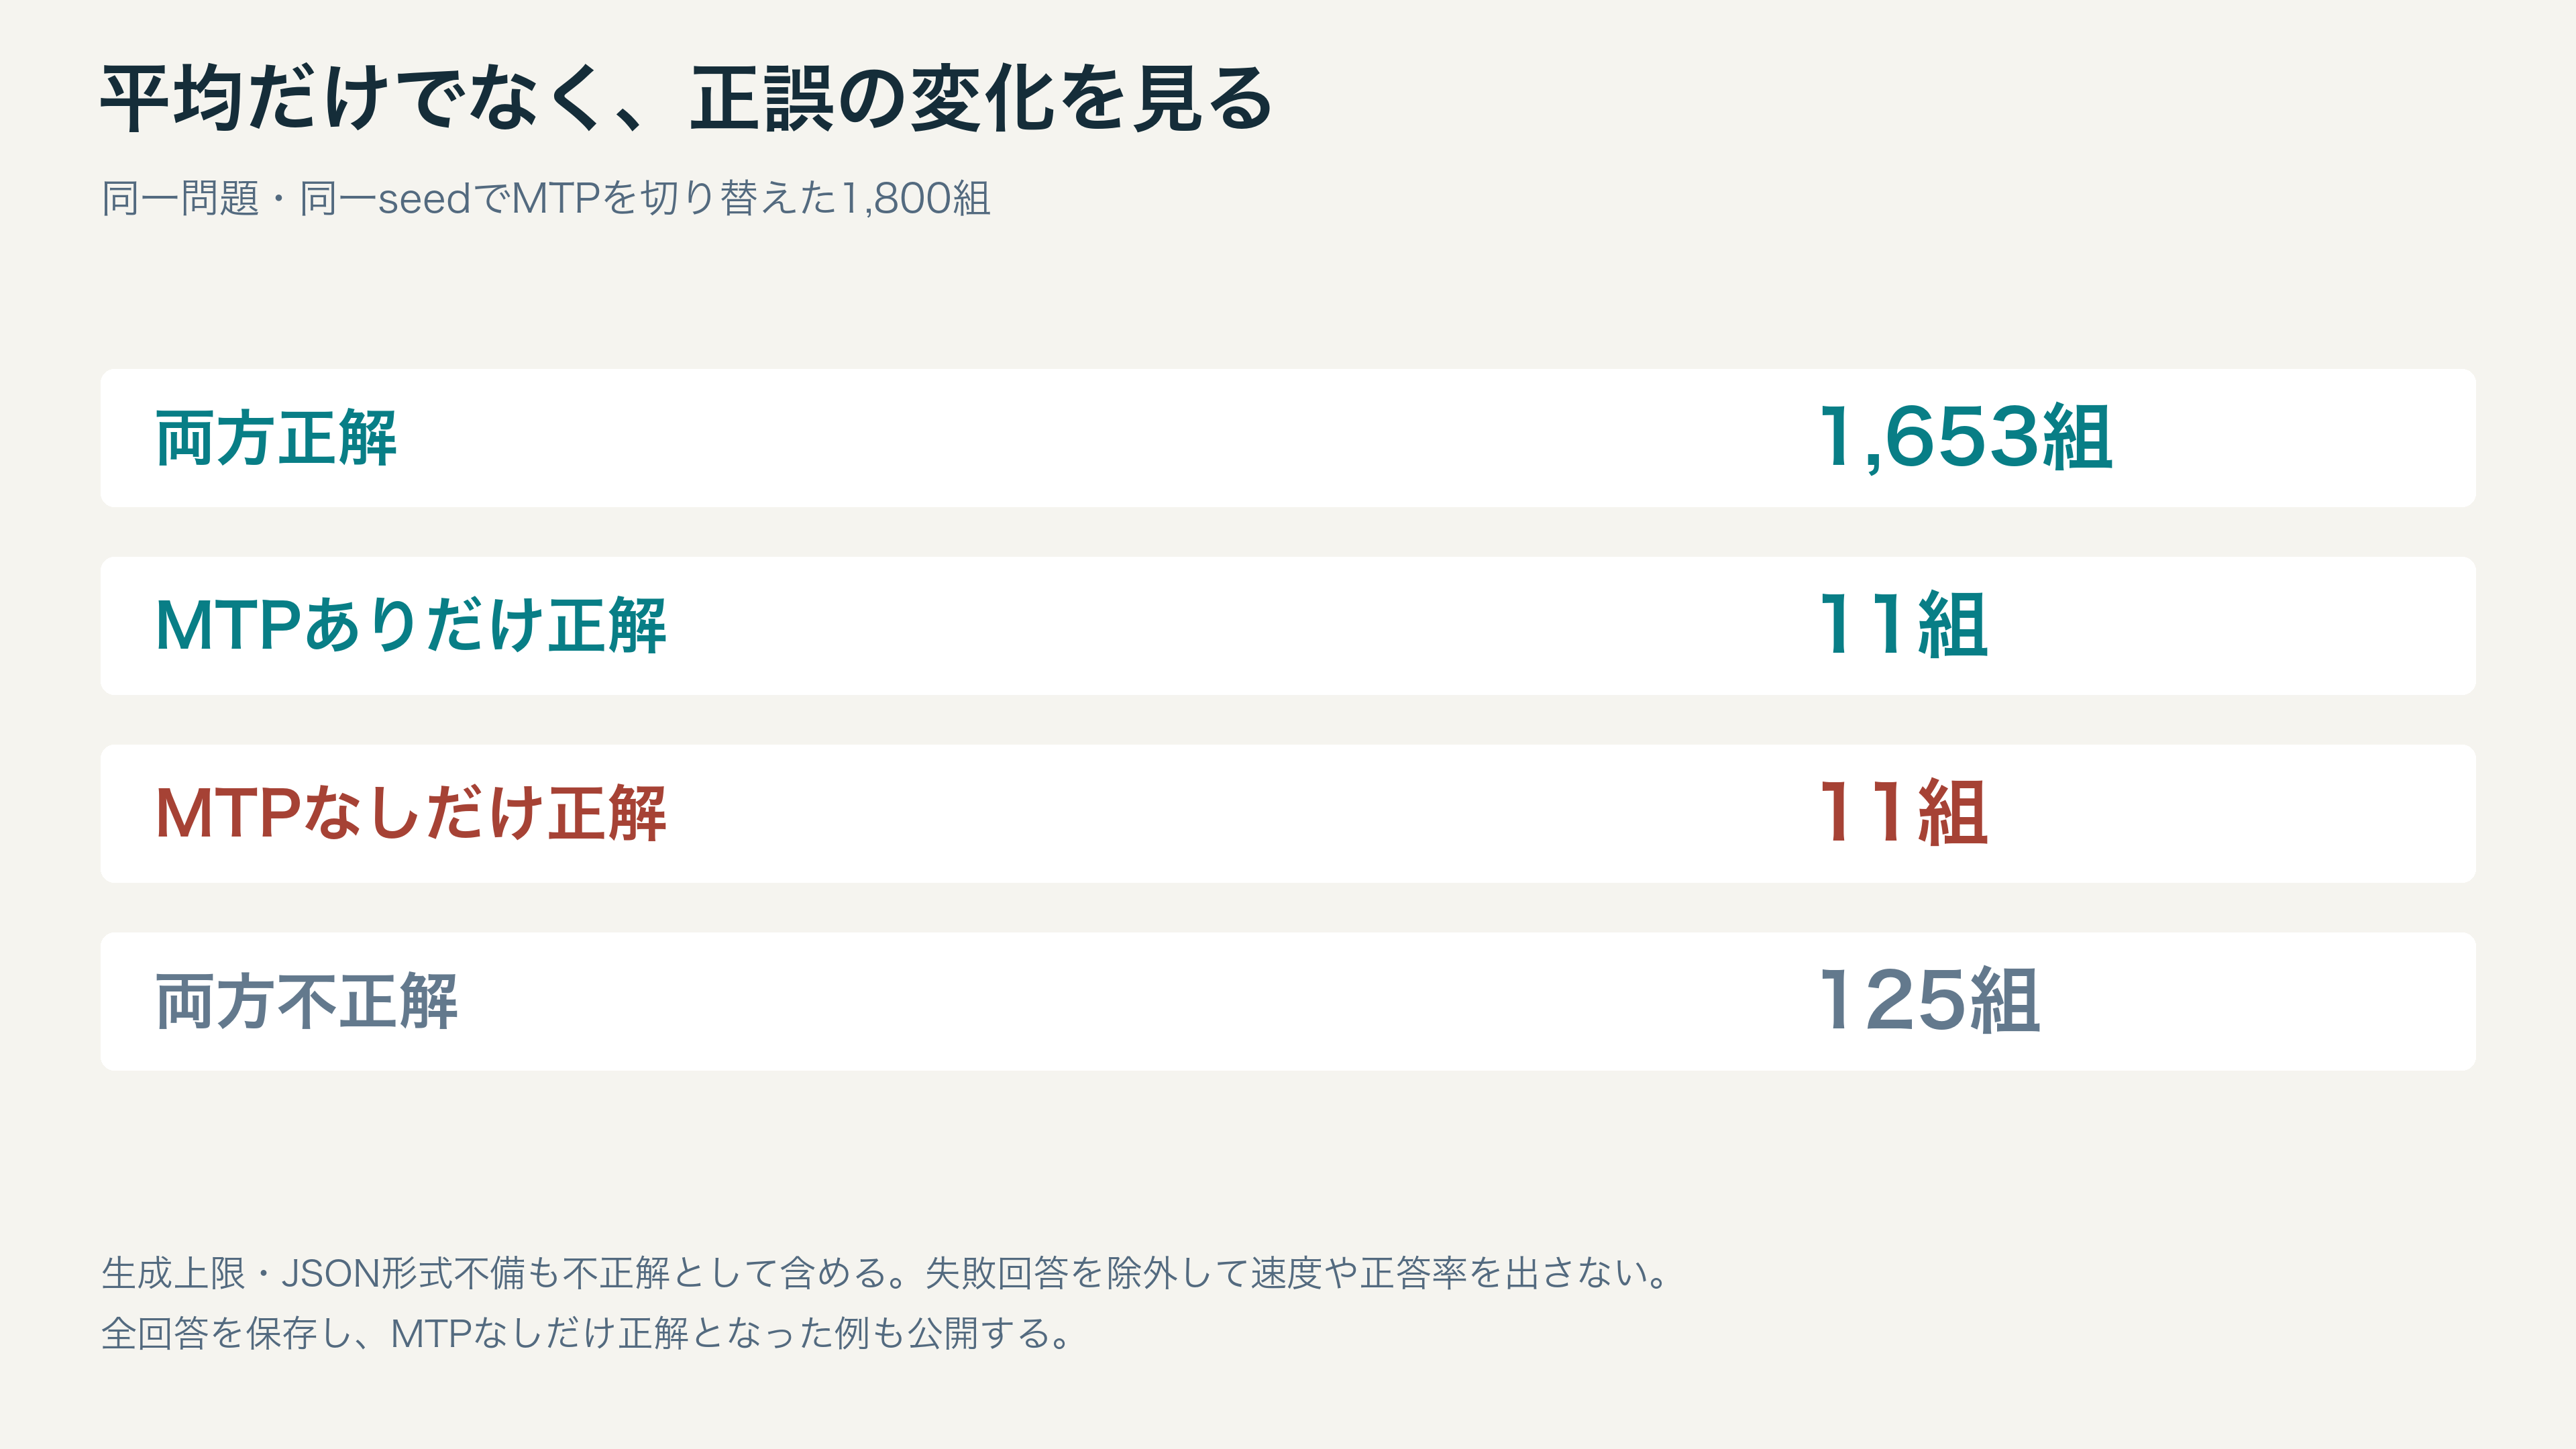
日本語の実務を想定した固定問題集600問を各3seedで比較すると、正答はMTPなし1664/1,800、あり1664/1,800でした。事前に定めた「平均正答率の低下が許容幅内か」という基準を満たしましたが、MTPありだけ不正解になる組もありました。どの回答でも品質が落ちない、または全問正解になるという結論ではありません。
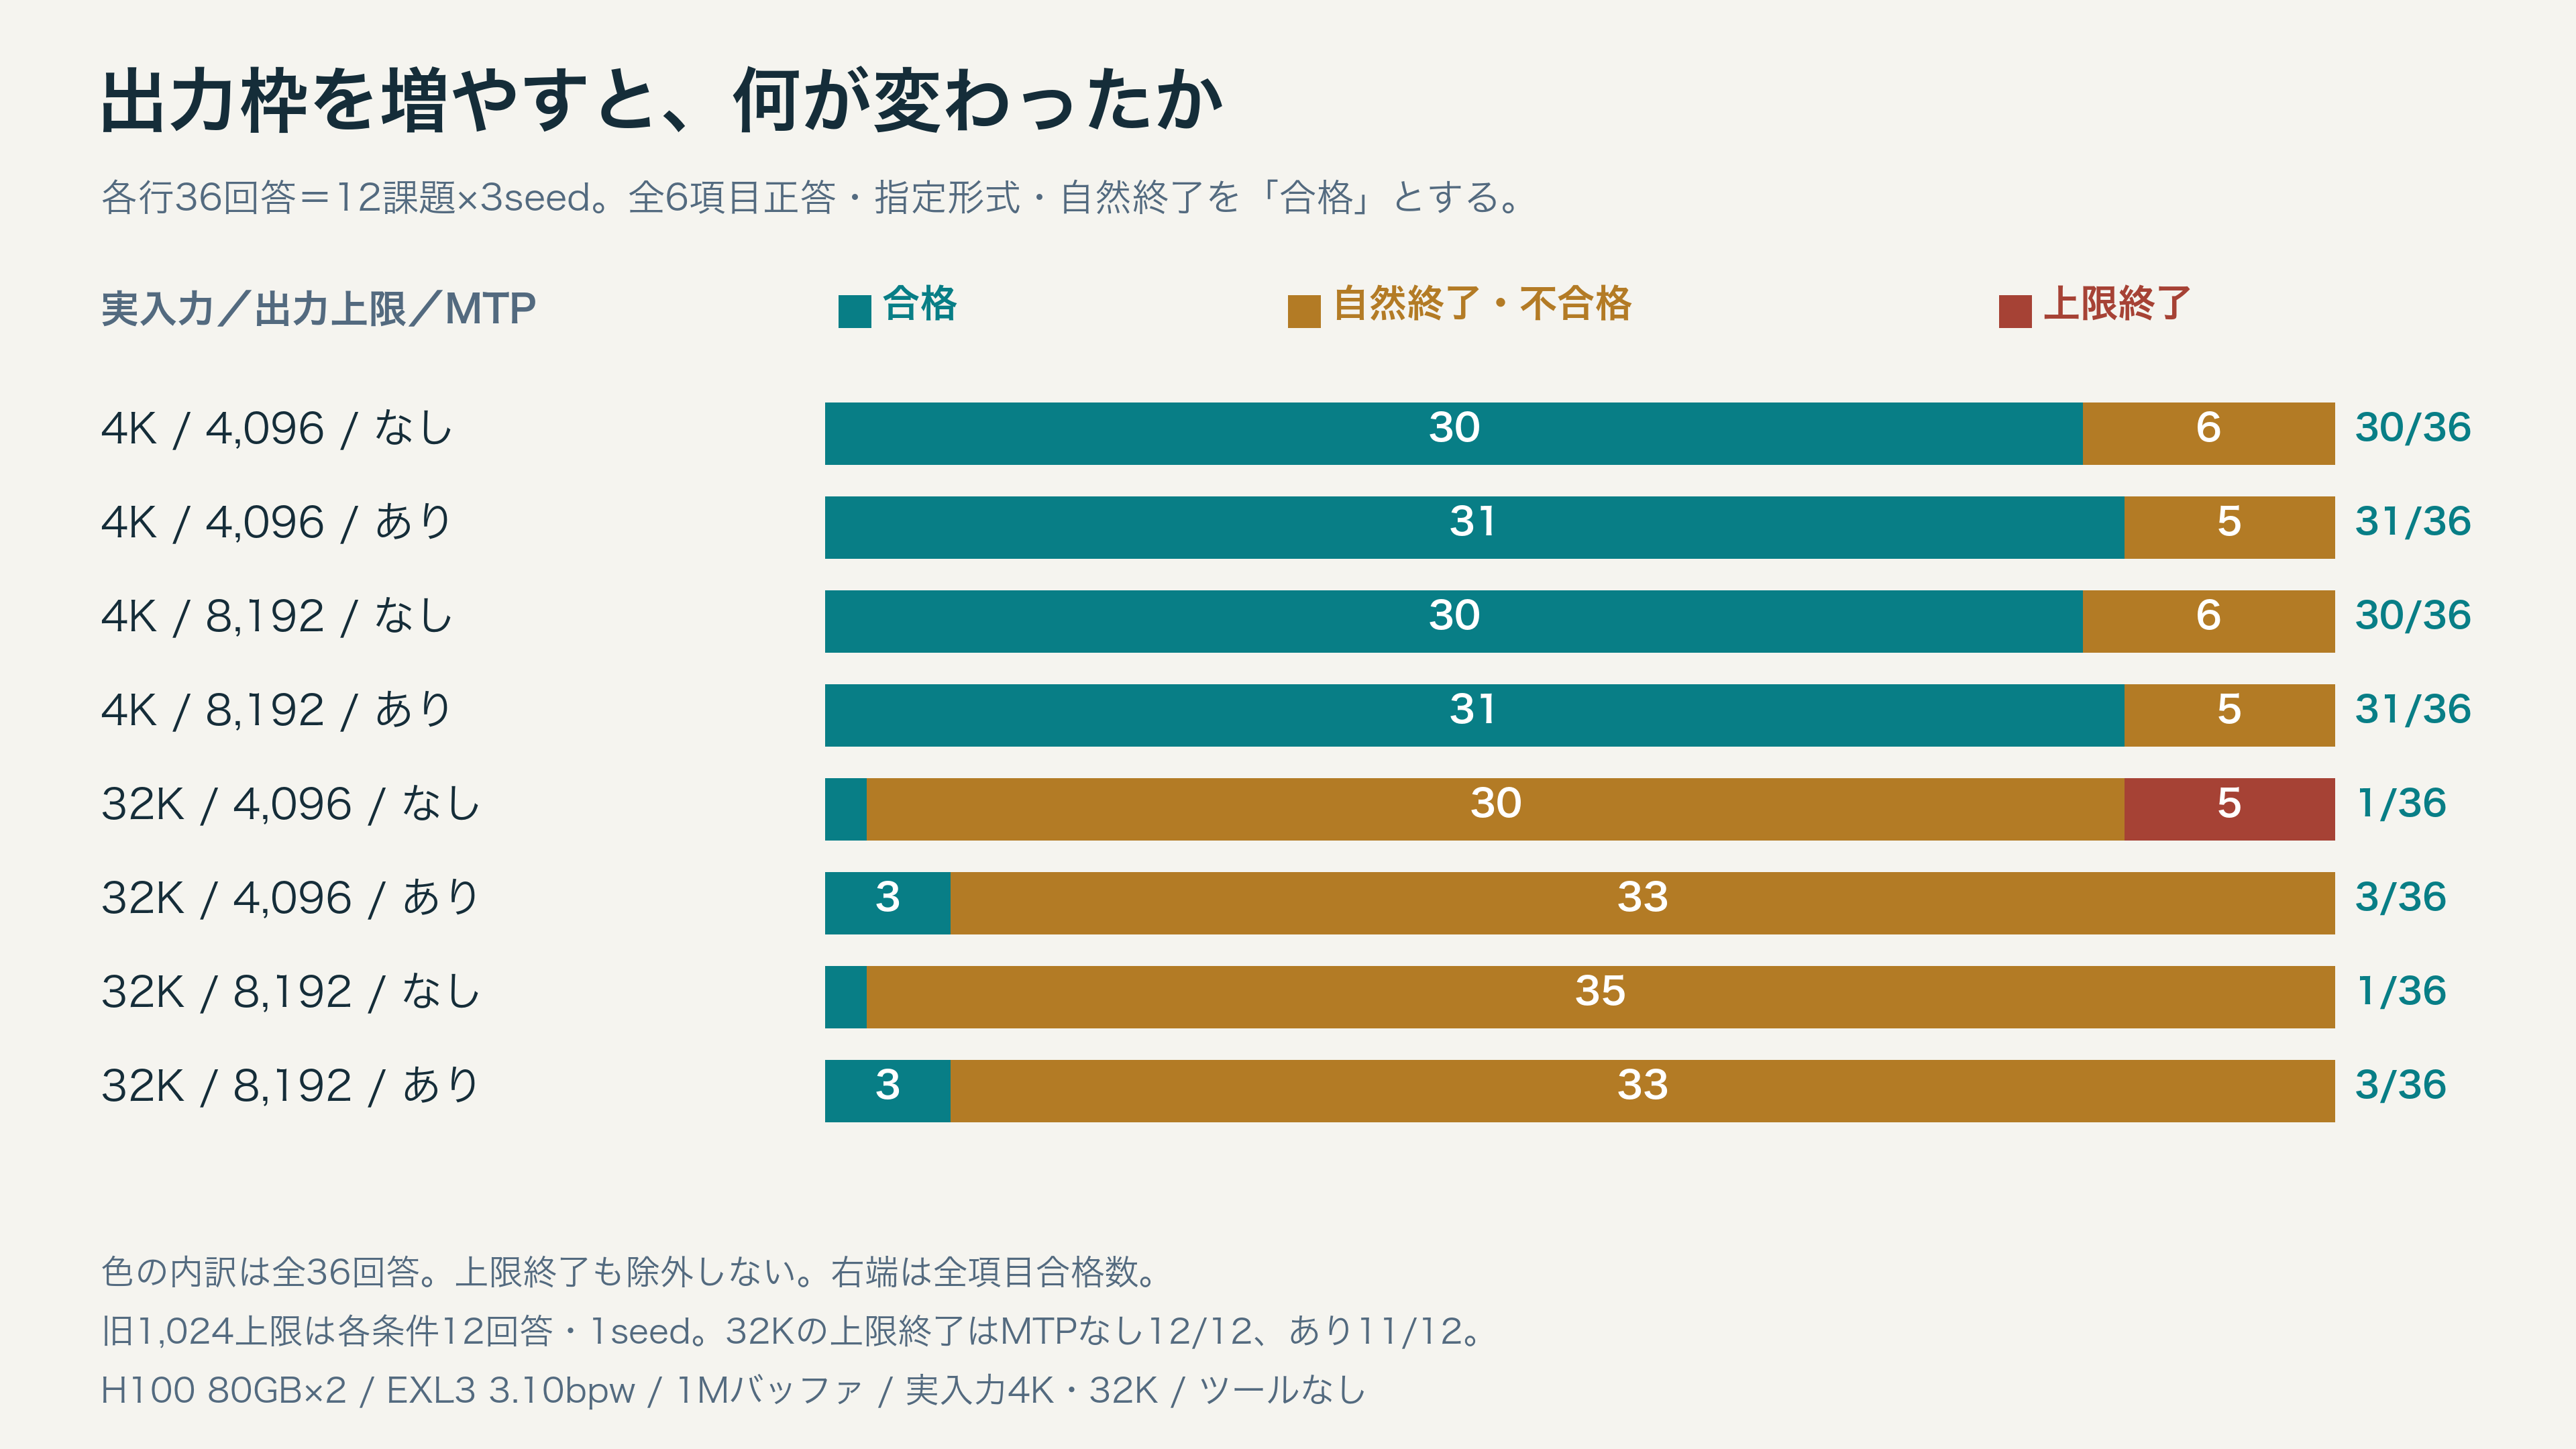
出力上限を増やした追加試験:出力上限8,192では上限終了0/144回答、本文未到達1/144回答。32K資料の全項目合格はなし1/36、あり3/36で、回答の完成と内容の正確さを分ける必要があります。 288回答の結果・待ち時間・誤答の内訳へ。旧1,024上限の結果も保持しています。
2026年10月30〜31日測定/ServerGear。B200・H100推論エンジン比較の全体解説と、導入説明を追加する前の品質検証動画も履歴として保持しています。
構成提案の結論:H100×2で50 tokens/s超を確認
H100 PCIe 80GB×2、GLM-5.3-Flash EXL3 sc_3.10bpw、ExLlamaV3、MTPありは、単一要求で50 tokens/s超を確認できた構成です。1,048,576 tokensのコンテキスト容量を確保し、実入力4K・32Kで各3回測定しました。MTPありの全6回で、生成区間の平均が50 tokens/sを超えています。CPUへの重み・KV退避はありません。
| 実入力 | MTP | 生成tokens/s | 最初の生成 秒 | 回答本文まで 秒 | 自然終了まで 秒 |
|---|---|---|---|---|---|
| 4K | なし | 49.63 | 1.63 | 1.65 | 19.62 |
| 4K | あり | 79.59 | 1.68 | 1.68 | 13.60 |
| 32K | なし | 49.56 | 10.51 | 10.54 | 27.82 |
| 32K | あり | 75.13 | 10.83 | 10.83 | 23.54 |
各3回の中央値です。この表は短いレポートを作る速度確認用タスクで、下の資料集計課題とは異なります。生成速度は思考・制御を含み、入力処理を含む要求全体の平均速度ではありません。待ち時間は入力処理と生成を含みますが、モデル読み込み・通信・トークン化は除きます。出力上限は1,024で、この1M容量の速度確認12回答はすべて自然終了しました。本文に根拠を越えた因果説明などがあり、自然終了を全項目正答とは扱いません。
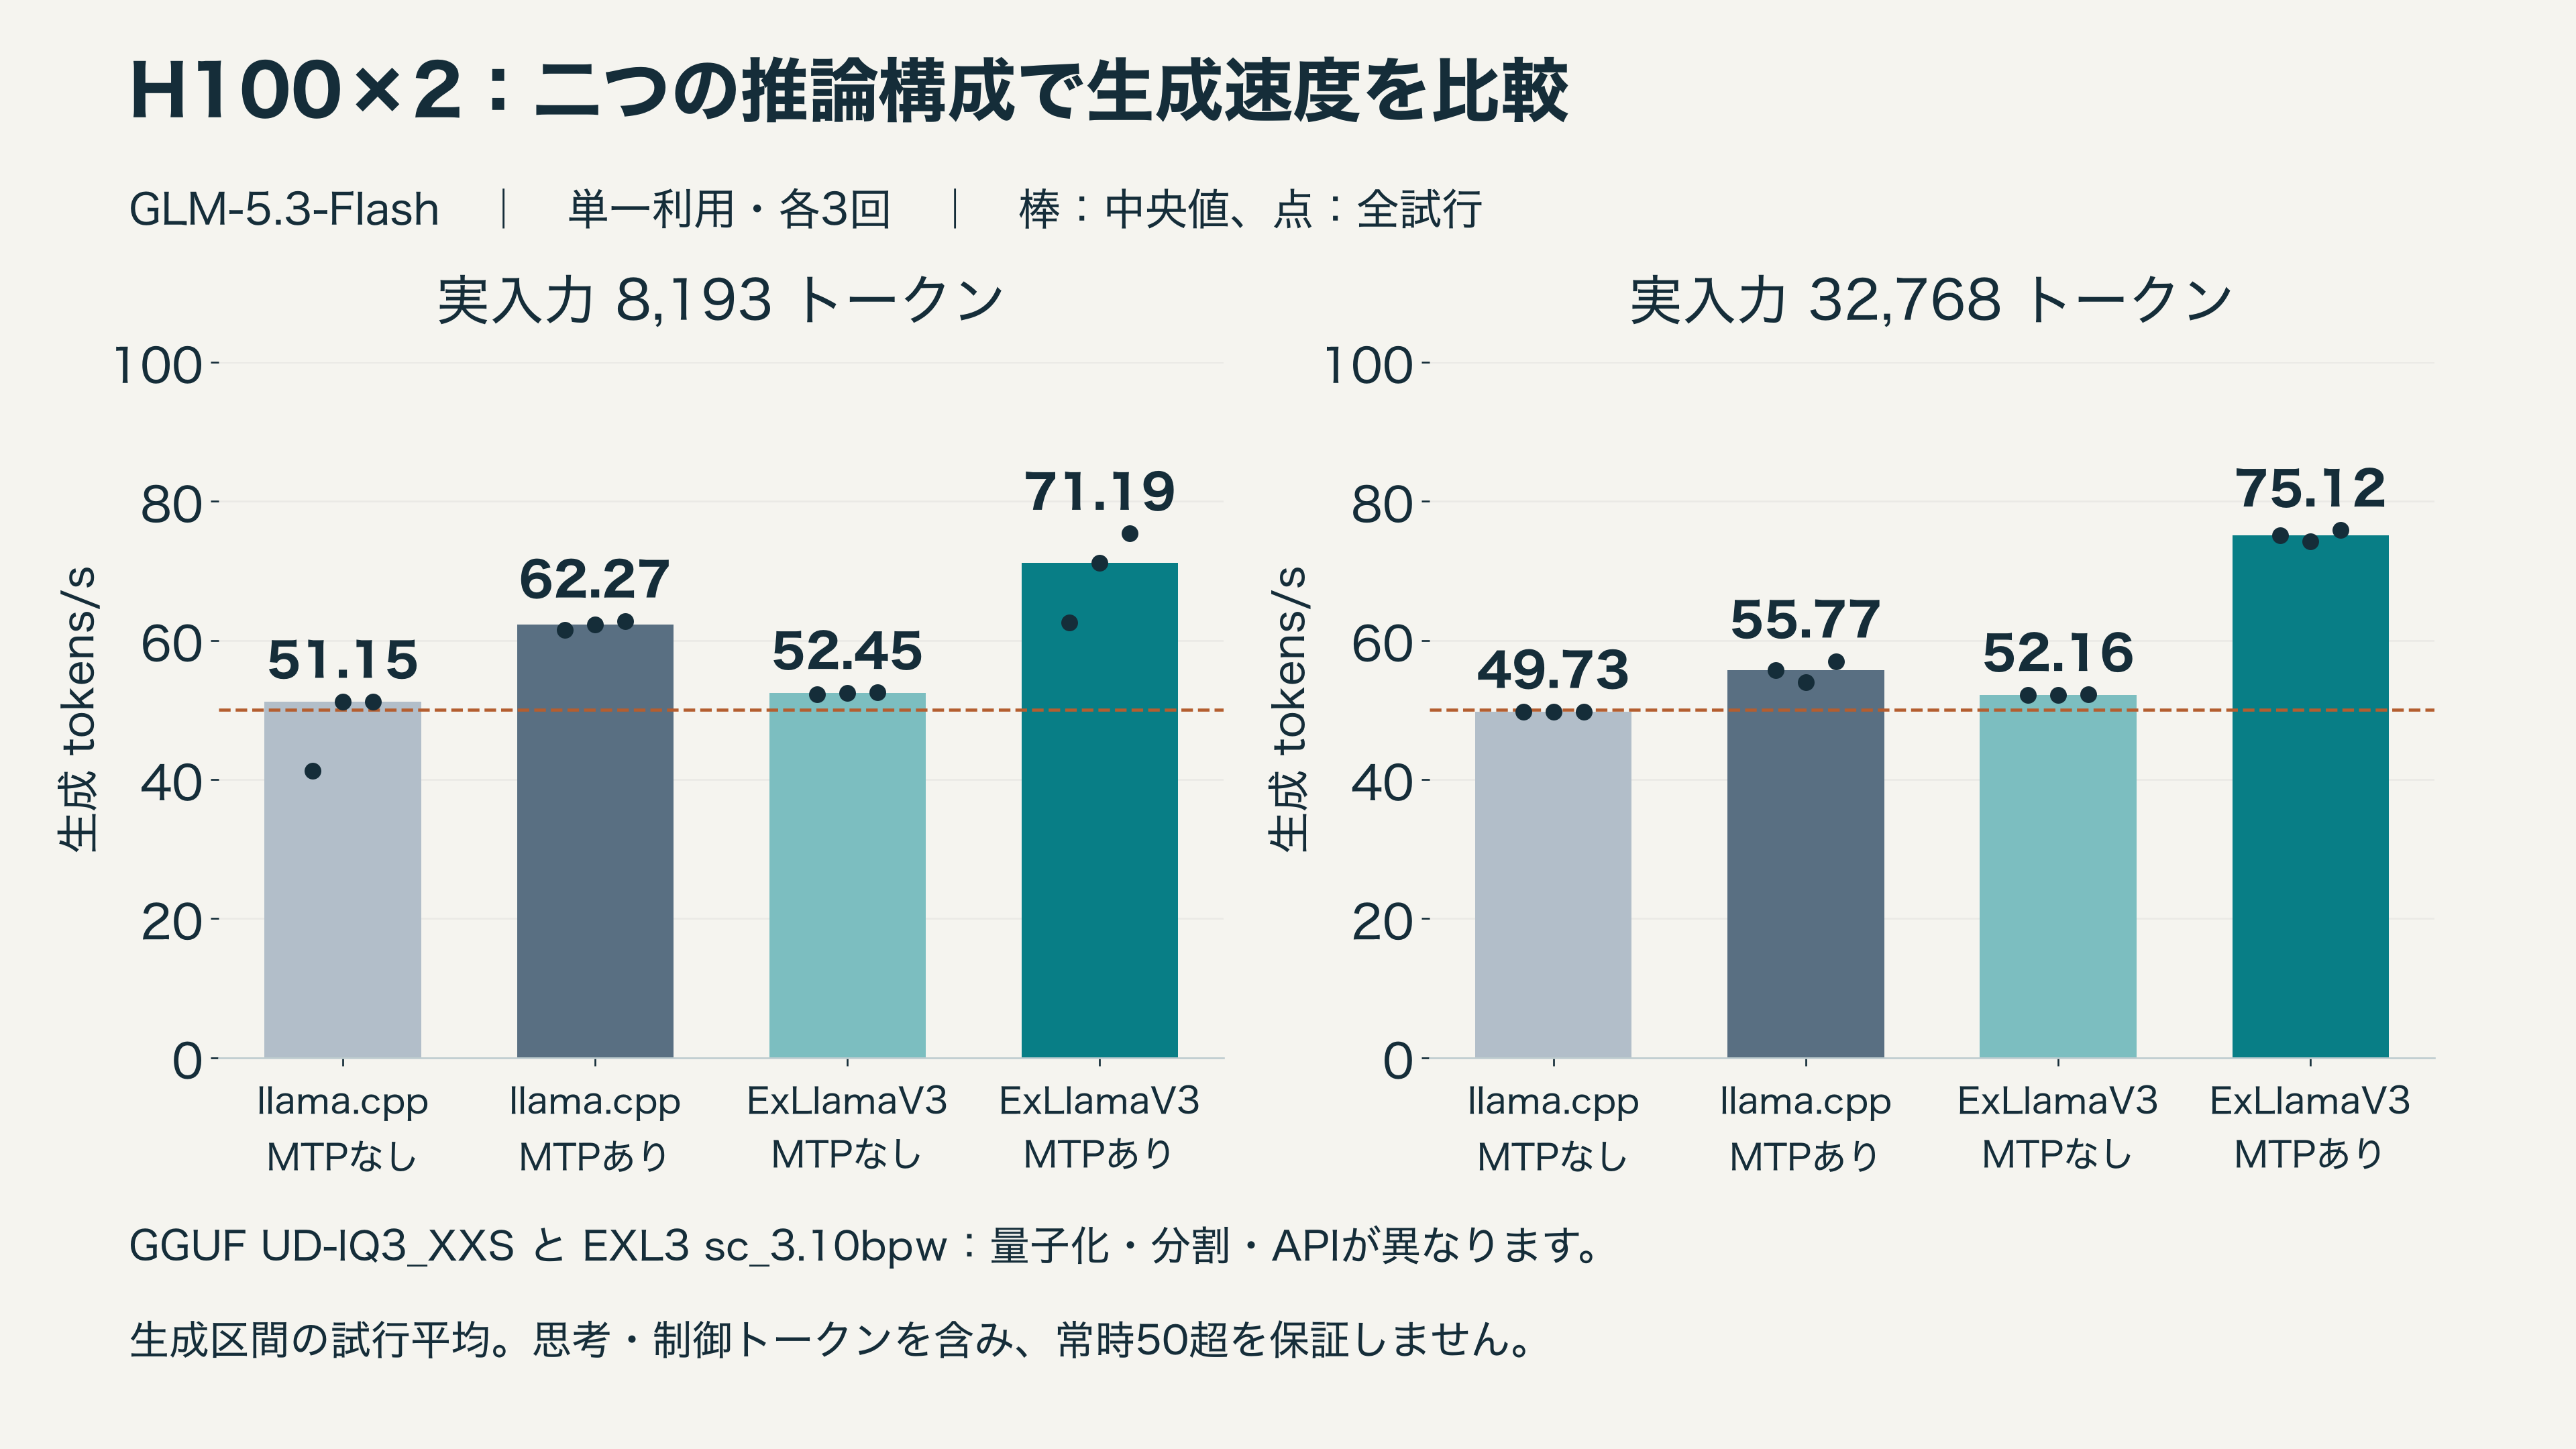
llama.cpp+GGUF UD-IQ3_XXSでも、別の約40K容量・MTPありの試験では、8K入力62.27、32K入力55.77 tokens/sを確認しています。ただし、GPU配置・量子化形式・入力・計測インターフェースなどが異なり、6回中3回は1,024出力上限で終了しました。旧llama.cpp試験の全結果と限界を保持し、上のExLlama構成との単純な速度倍率にはしていません。
品質について確認したのは、同じExLlamaモデル内のMTPあり/なしです。llama.cpp+GGUFから品質が劣化していないことを直接証明した試験ではありません。平均正解率が同じでも個別に正誤は入れ替わり、後述の追加資料課題にも誤答が残っています。
導入候補としては、使用するソフトと量子化形式を明示したうえで、代表的な業務入力・出力形式・同時利用数に合わせ、回答品質と応答時間を確認するのが適切です。1M容量の確保は、1Mまで埋めた履歴の理解やエージェントの長時間動作の保証ではありません。他GPUへの速度換算や、常時50 tokens/sという保証もしていません。
追加試験:出力上限4,096・8,192でもMTPの品質を比べる
出力上限8,192では上限終了0/144回答、本文未到達1/144回答。32K資料の全項目合格はなし1/36、あり3/36で、回答の完成と内容の正確さを分ける必要があります。
なぜ1,024のままでは足りなかったか
前回の32K資料課題では、MTPなし12/12回答、あり11/12回答が、思考を含む1,024出力トークンで打ち切られました。1,024は試験側で設定した上限であり、H100やモデルの出力限界を実測した数値ではありません。打ち切りが大半と分かった段階で、出力予算を増やした確認が必要でした。初回の結果だけでは、回答を完成させたときの正確さを十分評価できていませんでした。
この不足を確認するため、元の24課題、正解、入力本文、採点方法を保持し、出力上限4,096と8,192を比較しました。旧1,024の失敗も残しています。最初の試験結果を見た後に追加した追試であり、元の600問の事前登録主試験を置き換えるものではありません。
追加試験の条件
| 項目 | 条件 |
|---|---|
| GPU・実行ソフト | H100 PCIe 80GB×2/ExLlamaV3 1.6.5-gpuembed1 |
| モデル | GLM-5.3-Flash EXL3 sc_3.10bpw/固定リビジョン b570edf655a2bb00beca23e18d3b98724bfc2db5 |
| コンテキスト容量 | 1,048,576 tokens。CPUへの重み・KV退避なし |
| 実入力・記録量 | 4,096 tokens:50件/32,768 tokens:600件。各12課題 |
| 出力上限 | 4,096/8,192 tokens。思考・制御・回答を含む |
| 比較 | 24課題 × 3seed × 2上限 × MTPなし/候補3あり=288回答 |
| 生成 | temperature=1、top_p=0.95、top_k=0、min_p=0、reasoning_effort=low、enable_thinking=true |
| モデルに与えたツール | なし。電卓・検索・コード実行を提供しない |
| 主な採点 | 6項目すべて正答+指定JSON形式+自然終了 |
| ウォームアップ | 4回答を本集計から除外し、全文と設定を別に保存 |
6項目は、行数、待ち秒の最小・最大、対象部署の件数合計、指定IDの待ち秒、遅延原因です。元資料のJSON行から正解を独立に再計算し、全24課題で一致しました。原因についての対照実験や追加資料はないため、遅延原因の正解は「不明」です。入力プロンプトと入力トークン列も元の試験と照合しました。
顧客の実データではなく、合成した業務記録を使っています。入力の先頭には「計算には使用しない」と明記した参考ログを繰り返して長さを調整し、その後に記録と質問を置きました。4K・32Kはこの参考ログやチャットの制御部分も含む入力長の目標値で、許容差は4トークンです。全入力が回答に必要な情報という意味ではなく、情報の位置を変えた探索性能も測っていません。
モデル・量子化・配置を固定し、MTPなしでも補助モデルとKVを保持して比較しました。追加の2seedは元seedに100,000と200,000を加えたものです。課題・出力上限・seedの順と、各対のMTP実行順は、追試開始前に固定しました。成功・誤答・形式不備・打ち切りをすべて集計します。4Kと32Kは記録量と課題内容が異なるため、入力長だけの因果効果を測った比較ではありません。
打ち切りは減ったか。完成した回答は正しかったか
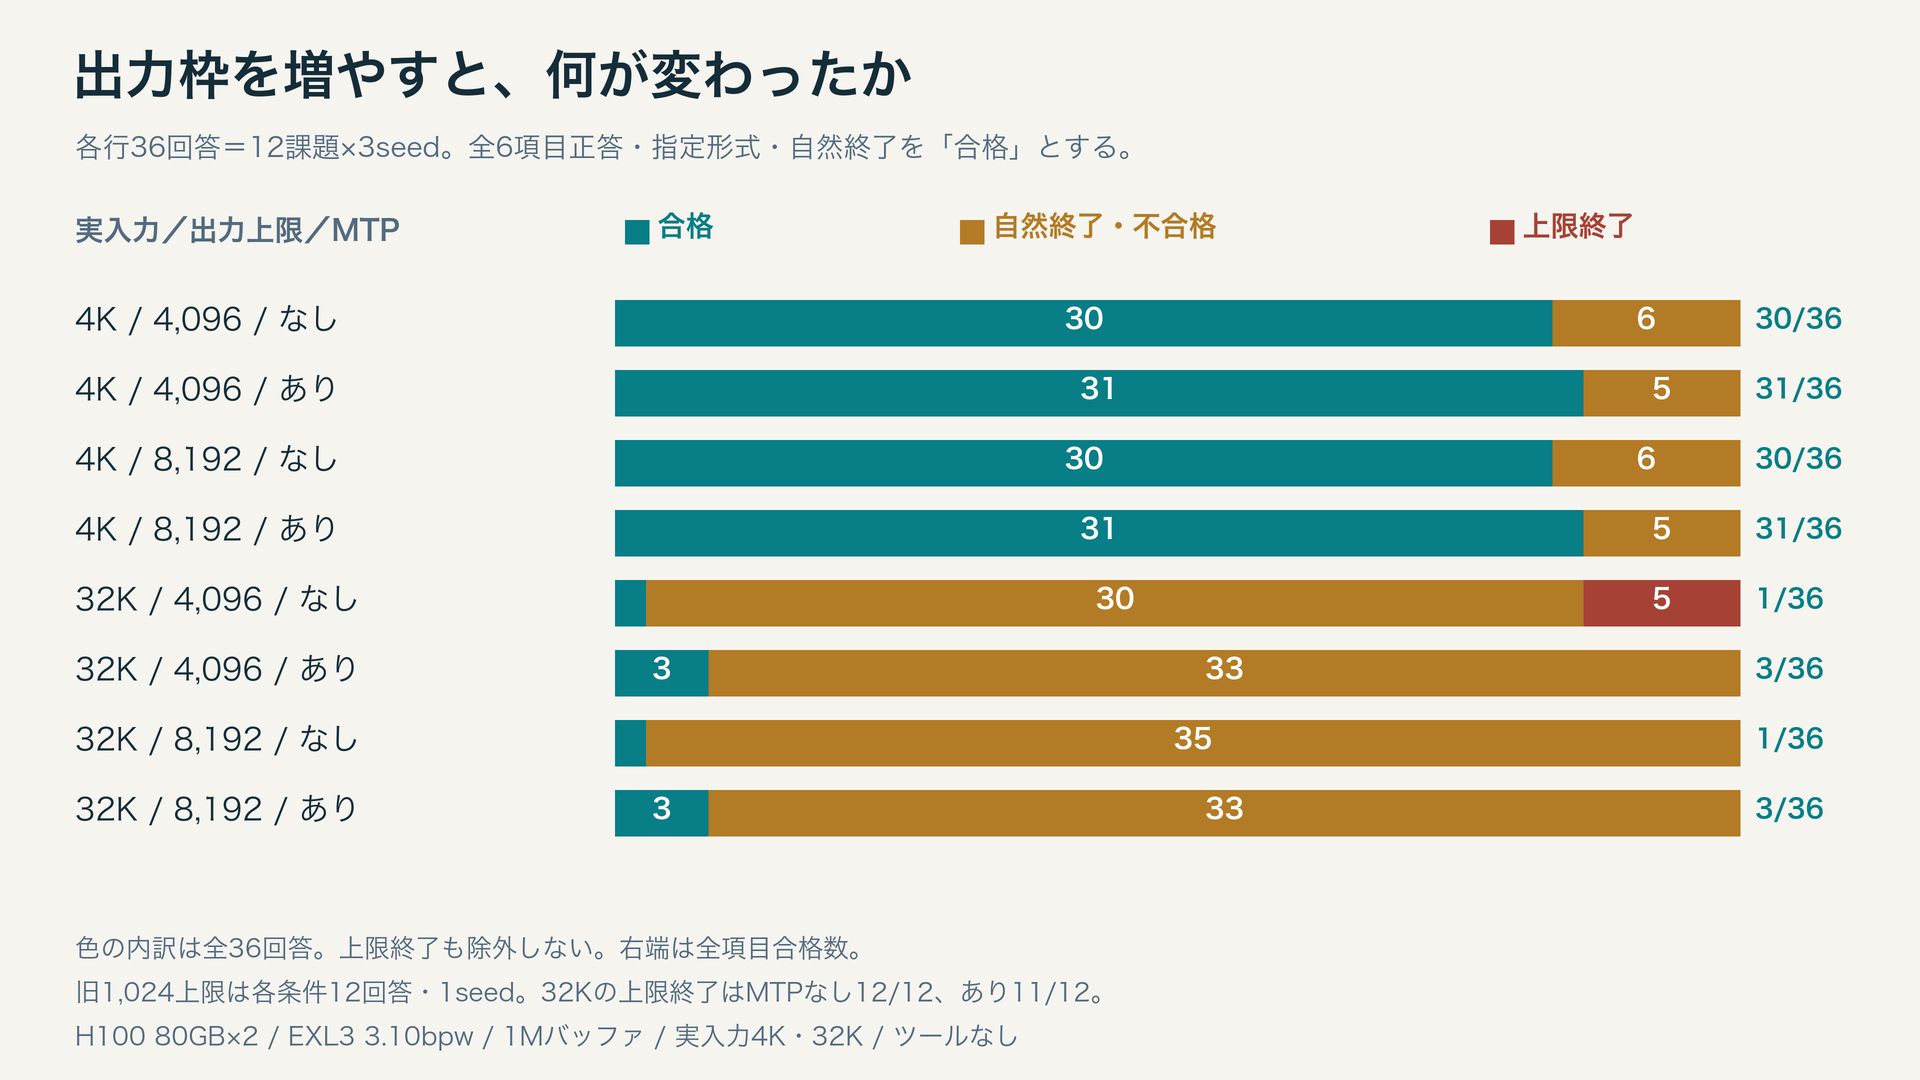
| 実入力 | 出力上限 | MTP | 回答数 | 全項目合格 | 自然終了 | 上限終了 | 本文未到達 |
|---|---|---|---|---|---|---|---|
| 4K | 1,024(旧試験) | なし | 12 | 11 | 12 | 0 | 0 |
| 4K | 1,024(旧試験) | あり | 12 | 11 | 12 | 0 | 0 |
| 4K | 4,096 | なし | 36 | 30 | 36 | 0 | 0 |
| 4K | 4,096 | あり | 36 | 31 | 36 | 0 | 0 |
| 4K | 8,192 | なし | 36 | 30 | 36 | 0 | 0 |
| 4K | 8,192 | あり | 36 | 31 | 36 | 0 | 0 |
| 32K | 1,024(旧試験) | なし | 12 | 0 | 0 | 12 | 12 |
| 32K | 1,024(旧試験) | あり | 12 | 0 | 1 | 11 | 11 |
| 32K | 4,096 | なし | 36 | 1 | 31 | 5 | 6 |
| 32K | 4,096 | あり | 36 | 3 | 36 | 0 | 0 |
| 32K | 8,192 | なし | 36 | 1 | 36 | 0 | 1 |
| 32K | 8,192 | あり | 36 | 3 | 36 | 0 | 0 |
旧1,024は各条件12回答・1seed、追加4,096/8,192は各条件36回答・3seedです。元seedだけに絞った各12回答の比較も公開JSONに収録しました。旧試験とは実行セッションも異なるため、旧結果との差を出力上限だけの厳密な因果効果とは断定しません。新しい4,096/8,192間は、同じ24課題・3seedで対にした比較です。各上限で最初から生成し直しており、旧回答の続きをそのまま生成したものではありません。同じseedでも回答列の完全一致は保証していません。
4Kの全項目合格は、上限4,096でなし30/36、あり31/36、上限8,192でなし30/36、あり31/36でした。
32Kの全項目合格は、上限4,096でなし1/36、あり3/36、上限8,192でなし1/36、あり3/36でした。8,192上限の144回答中、上限終了は0回答、本文未到達は1回答です。自然終了と本文の完成や正答は同じではありません。
出力上限を増やすことは、回答を完成させる機会を確保する対応です。記録の取り違えや誤った集計まで自動で直るとは限りません。
4,096から8,192へ増やすと、MTPなしの32Kで打ち切られた5回答はすべて自然終了しました。ただし、この5回答も全項目合格には至りませんでした。4K・32Kとも、各MTP条件の合格数は二つの上限で変わっていません。
32K資料の項目別結果と、実際の誤り
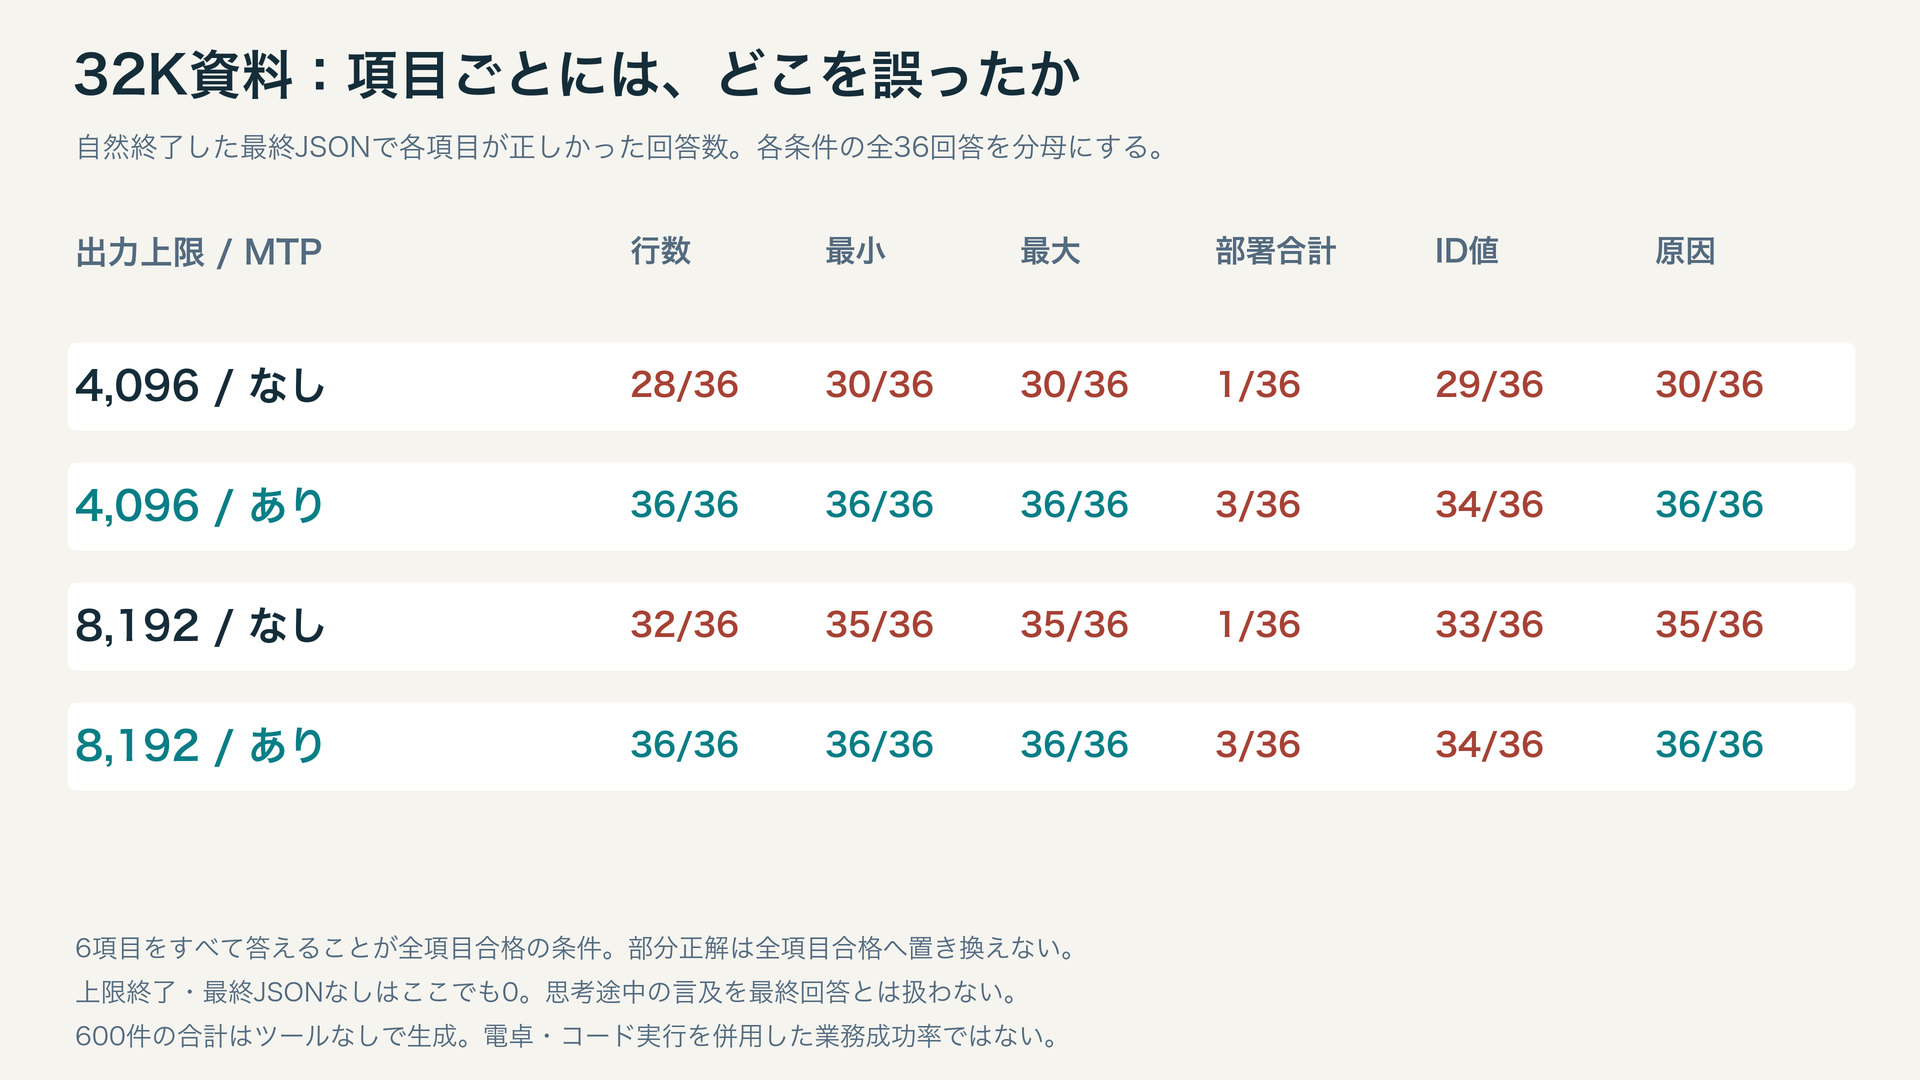
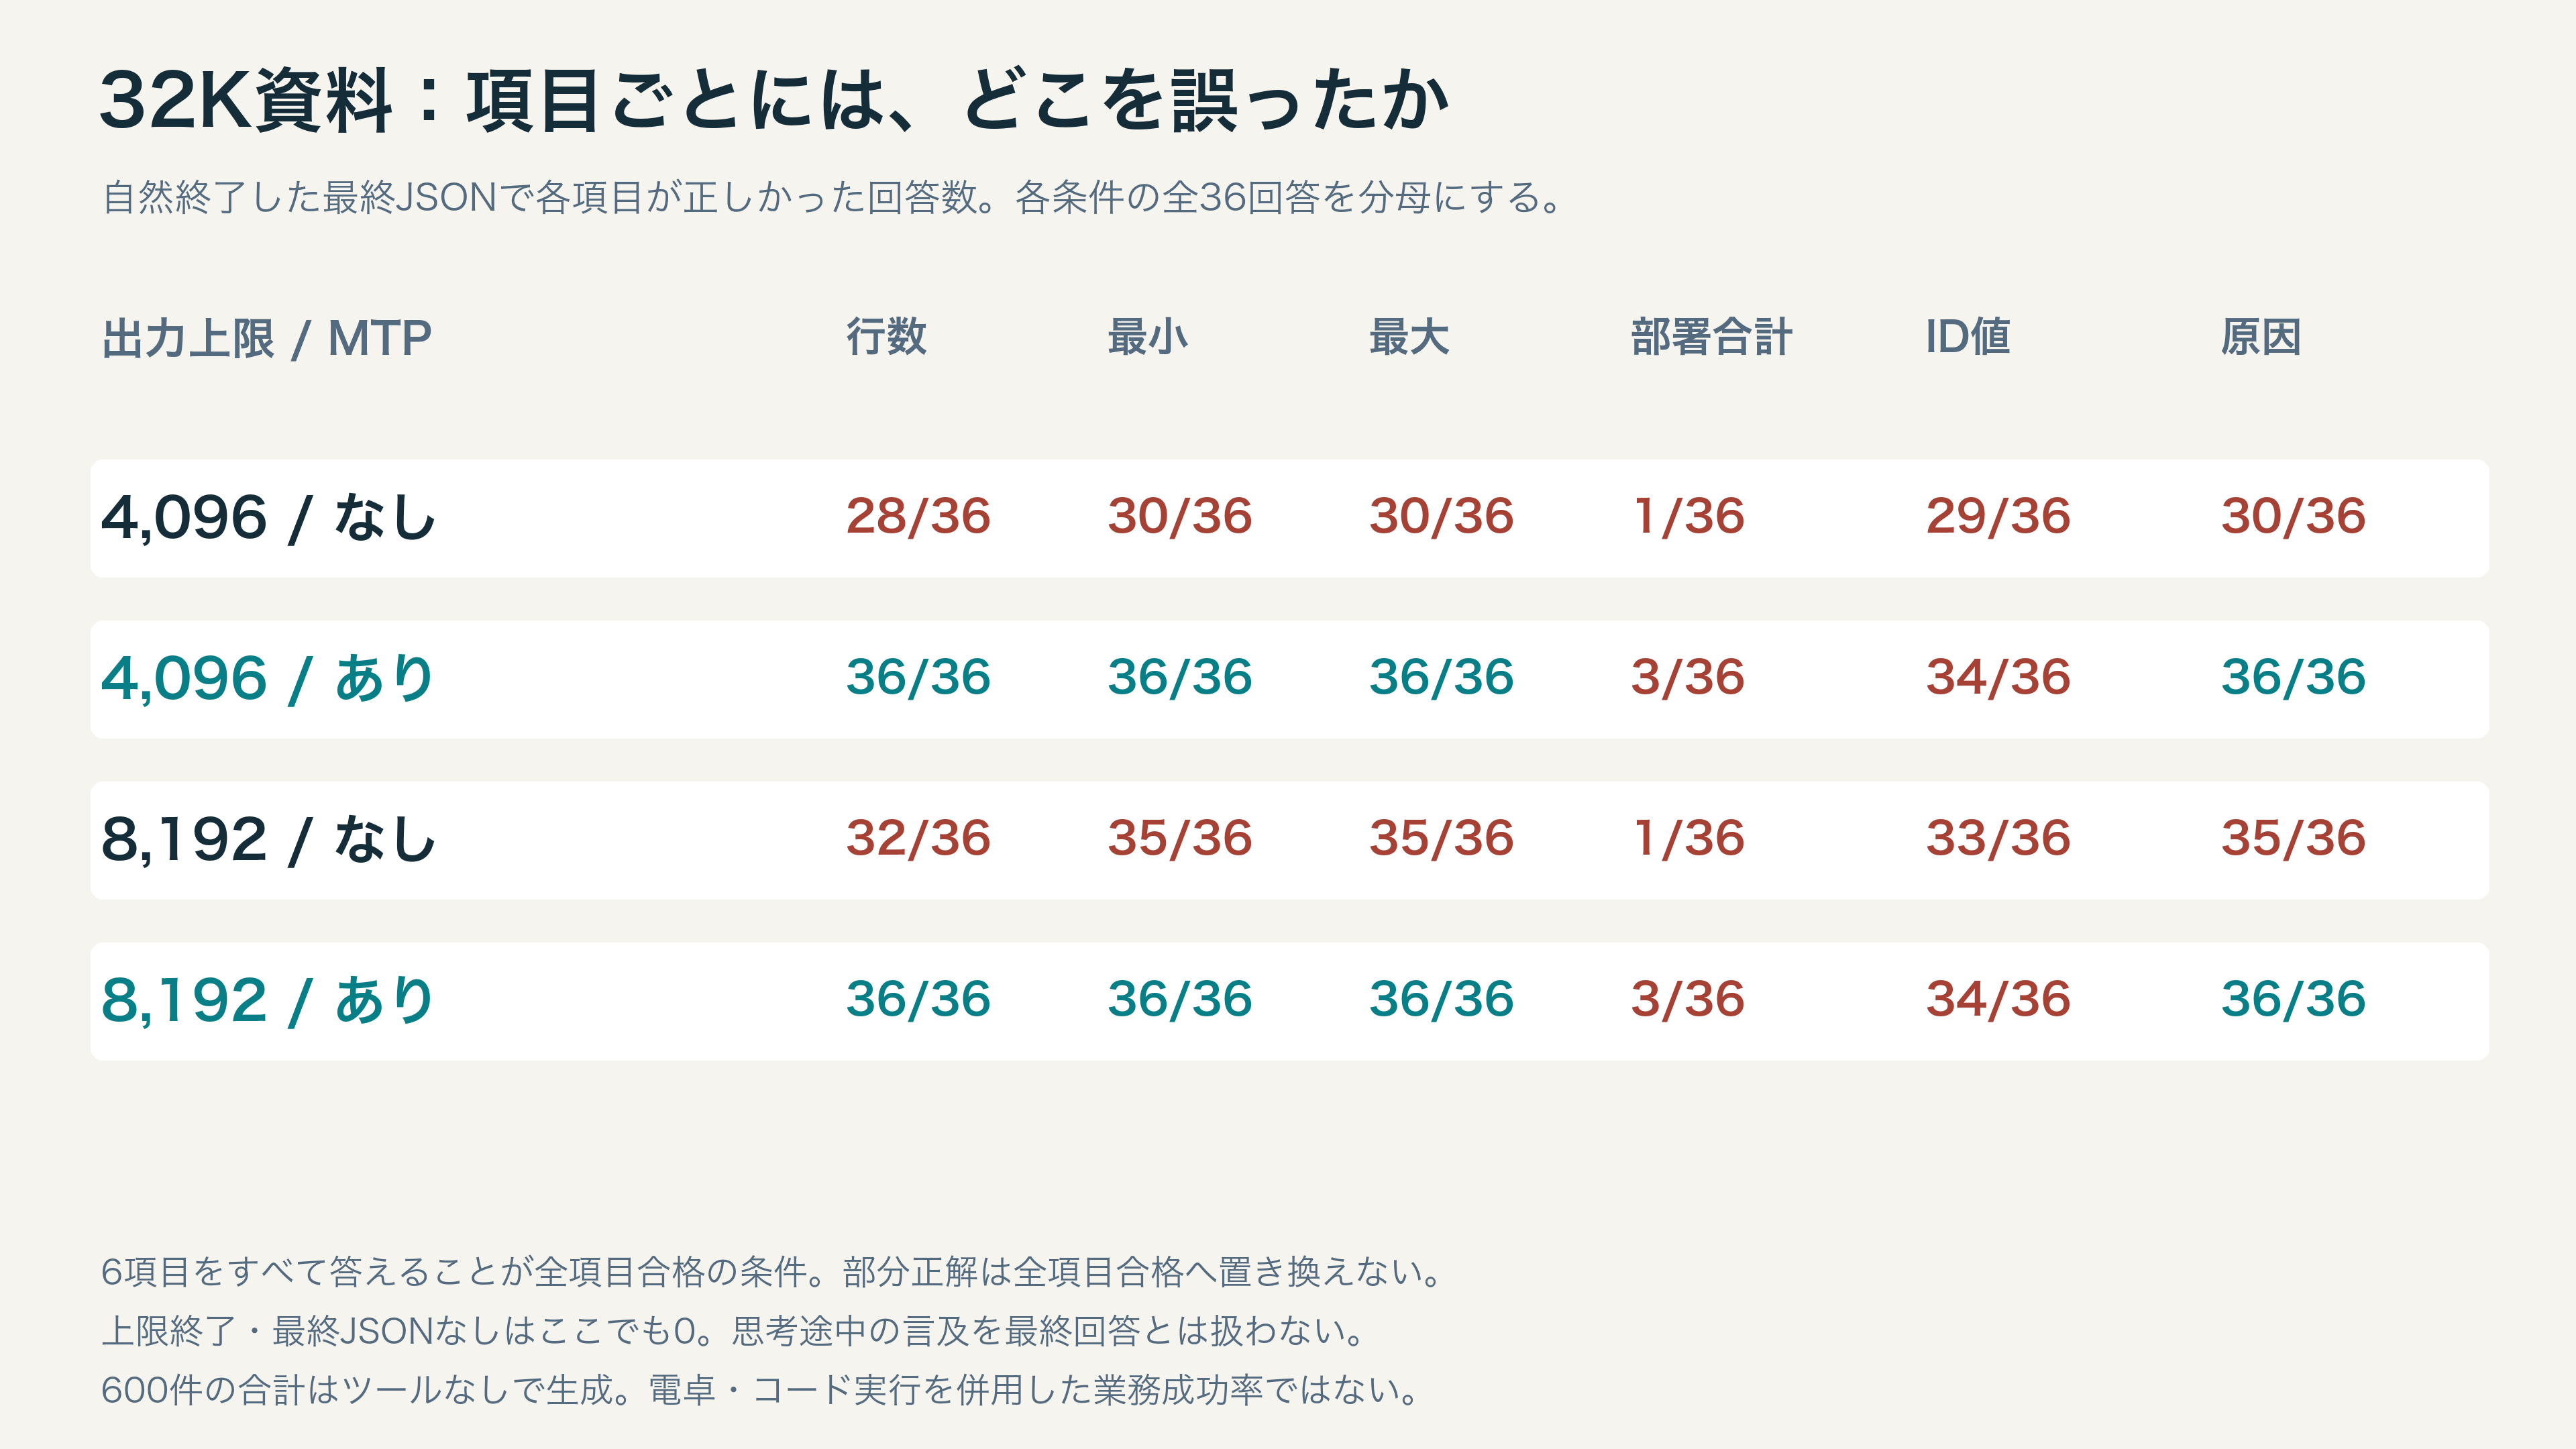
32Kでは対象部署の件数合計で誤りが多く、行数や指定IDの値を誤った回答もありました。項目別の図には未回答も不正解として含め、全36回答を分母にしています。
最終数字だけでなく、なしで合格・ありで不合格の全対について回答全文を照合しました。以下の例と付録では、観測できた誤りの経路と、内部原因として未確定の部分を分けています。
以下は現象を説明するために全回答の確認後に選んだ例です。無作為標本ではありません。頻度は上の全件集計で判断してください。
| 課題・seed・出力上限 | 項目・正解 | MTPなし | MTPあり |
|---|---|---|---|
| long-records-015/seed289116/両上限 | 管理部署の件数合計=11,482 | 11,482。全項目合格・自然終了 | 11,535。38行で待ち秒を件数として転記・自然終了 |
| long-records-020/seed189121/上限8,192 | 対象部署の件数合計=10,702 | 10,703。合計のみ不正解 | 10,702。全項目合格 |
| long-records-016/seed289117/上限8,192 | 合計=9,883/指定IDの待ち秒=31 | 合計9,830/待ち秒31 | 合計8,688/待ち秒15 |
本文が出るまで、完了まで、生成tokens/s
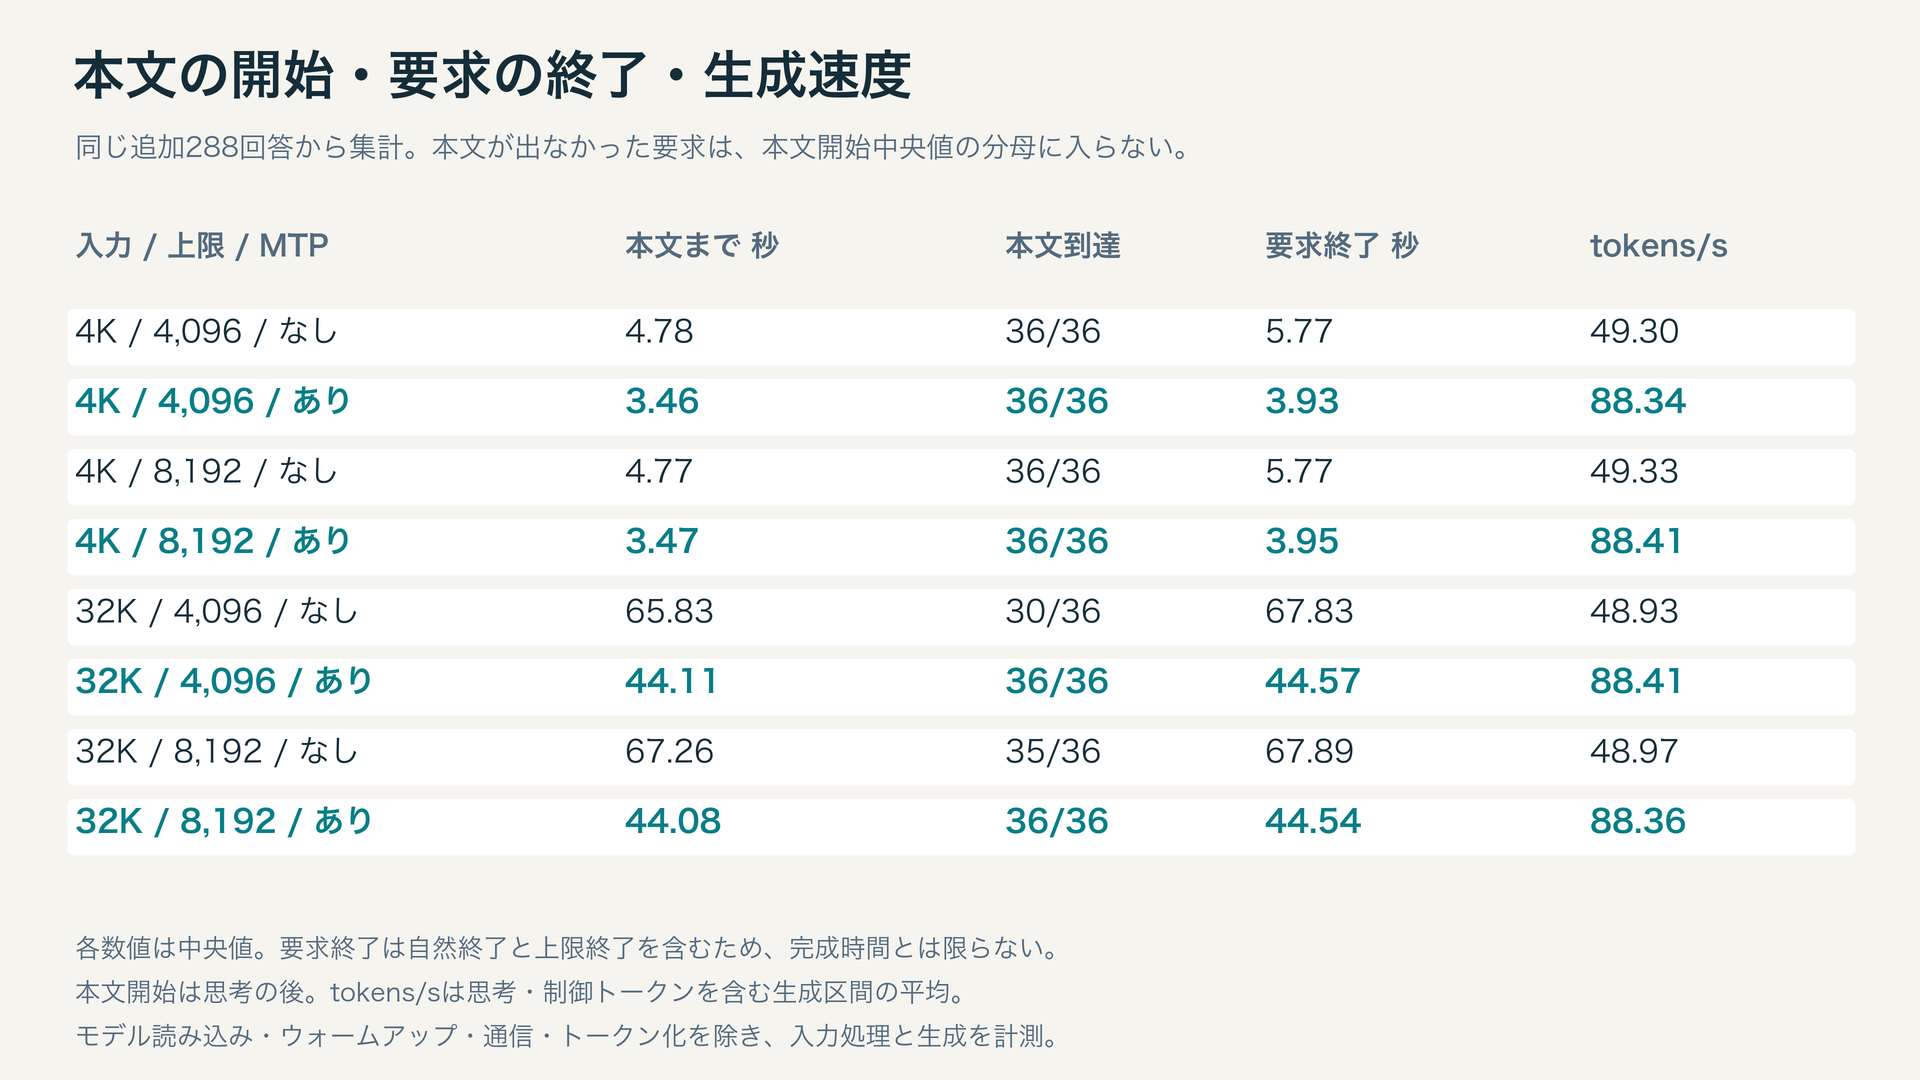
| 実入力 | 出力上限 | MTP | 最初の生成 秒 | 本文まで 秒/到達数 | 要求終了 秒(全件) | 自然終了まで 秒/件数 | 生成tokens/s | 生成数中央値 |
|---|---|---|---|---|---|---|---|---|
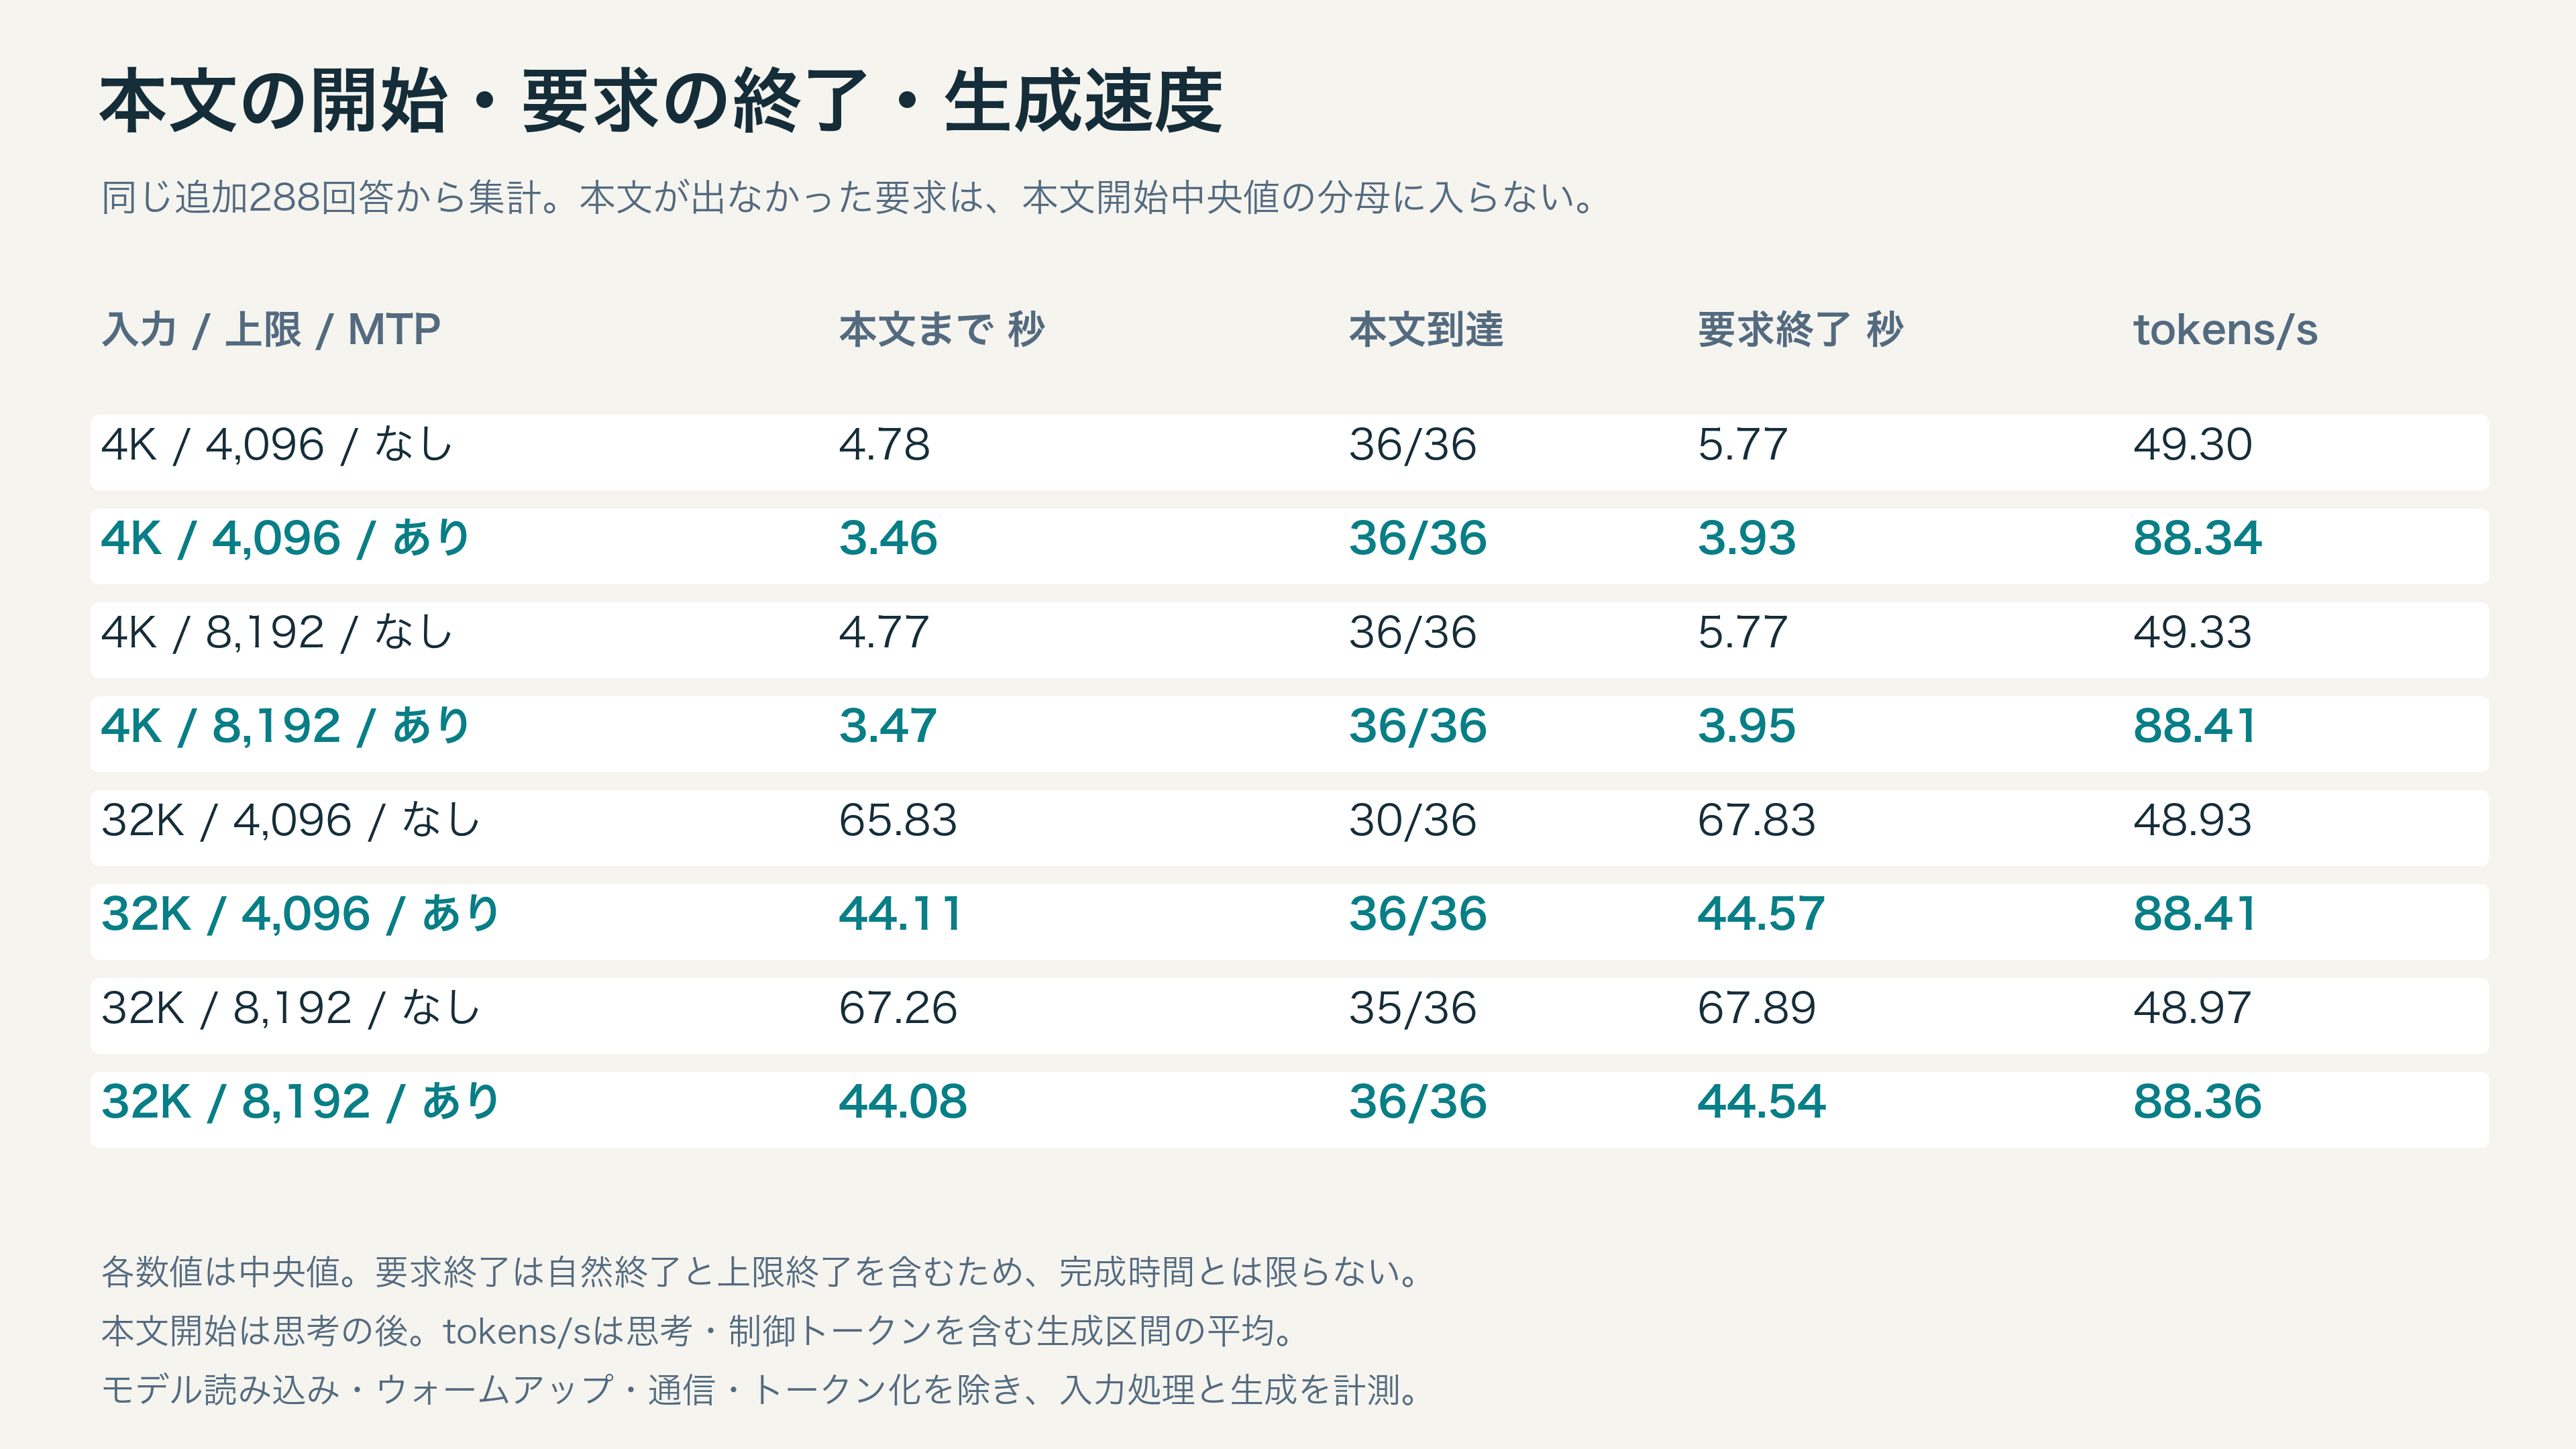
| 4K | 4,096 | なし | 1.61 | 4.78/36/36 | 5.77 | 5.77/36/36 | 49.30 | 207.5 |
| 4K | 4,096 | あり | 1.66 | 3.46/36/36 | 3.93 | 3.93/36/36 | 88.34 | 198.0 |
| 4K | 8,192 | なし | 1.61 | 4.77/36/36 | 5.77 | 5.77/36/36 | 49.33 | 207.5 |
| 4K | 8,192 | あり | 1.66 | 3.47/36/36 | 3.95 | 3.95/36/36 | 88.41 | 198.0 |
| 32K | 4,096 | なし | 11.08 | 65.83/30/36 | 67.83 | 66.65/31/36 | 48.93 | 2782.5 |
| 32K | 4,096 | あり | 11.41 | 44.11/36/36 | 44.57 | 44.57/36/36 | 88.41 | 2841.5 |
| 32K | 8,192 | なし | 11.08 | 67.26/35/36 | 67.89 | 67.89/36/36 | 48.97 | 2782.5 |
| 32K | 8,192 | あり | 11.41 | 44.08/36/36 | 44.54 | 44.54/36/36 | 88.36 | 2841.5 |
すべて中央値です。本文までの時間は本文へ到達した要求だけ、自然終了までの時間は自然終了した要求だけの中央値です。未到達や打ち切りの数も一緒に読む必要があります。全要求の終了時間は上限終了も含むため、完成した回答の待ち時間とは限りません。自然終了しても誤答の場合があります。
時間は、読み込み済みモデルへの要求からプロセス内ストリームで測定しました。入力処理と生成を含み、モデル読み込み、初期ウォームアップ、トークン化、ネットワークは除きます。生成tokens/sは思考・制御を含む最初の1トークン以後の生成区間平均です。日本語の文字数毎秒や、同じ長さの回答の完了速度比ではありません。前半にある短い速度確認用タスクの待ち時間とも、課題が異なるため混同しないでください。
上限8,192の4K資料課題では、本文までの中央値はなし4.77秒、あり3.47秒でした。生成速度はそれぞれ49.33、88.41 tokens/sです。
上限8,192の32K資料課題では、本文までの中央値はなし67.26秒、あり44.08秒でした。生成速度はそれぞれ48.97、88.36 tokens/sです。
同じ課題でも思考・回答の長さが変わるため、生成速度の比率をそのまま要求全体の時間短縮率にはしません。上限や本文未到達の有無を併記しています。
MTPで品質が落ちるのか
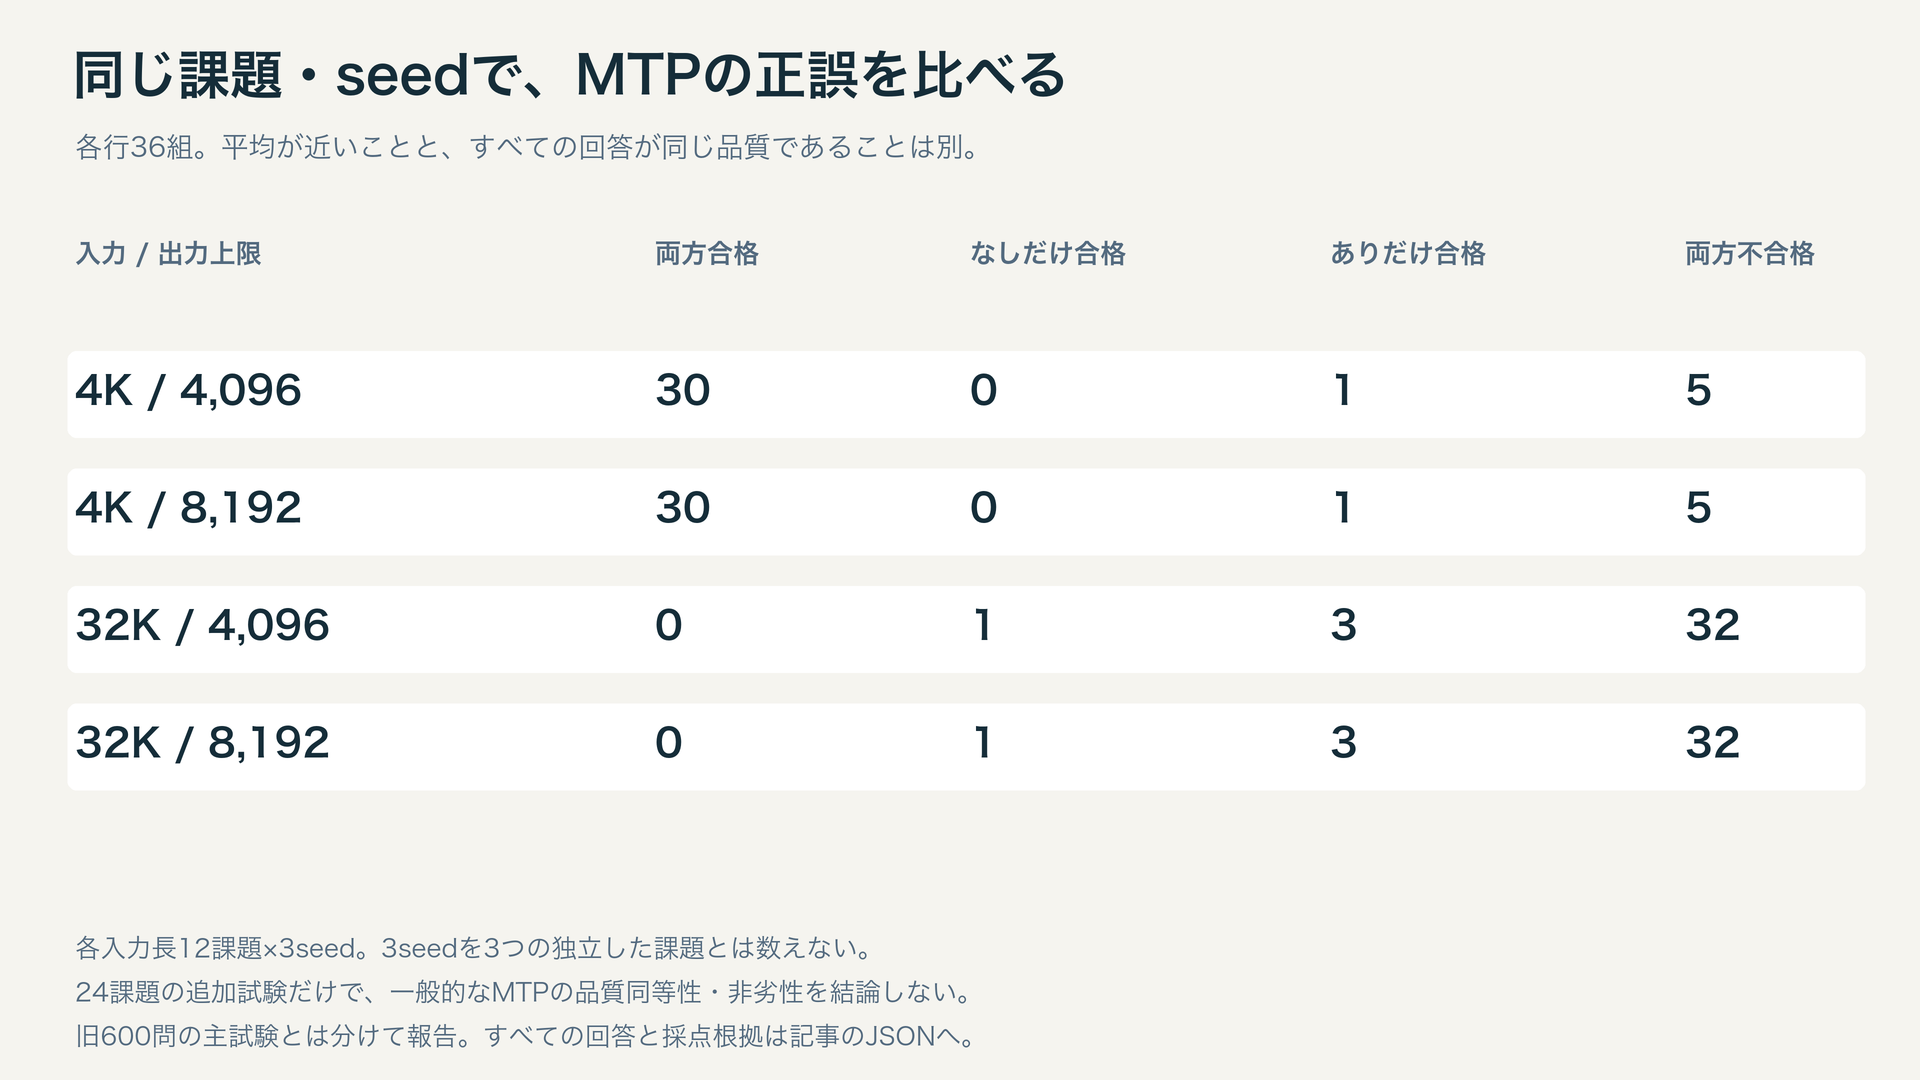
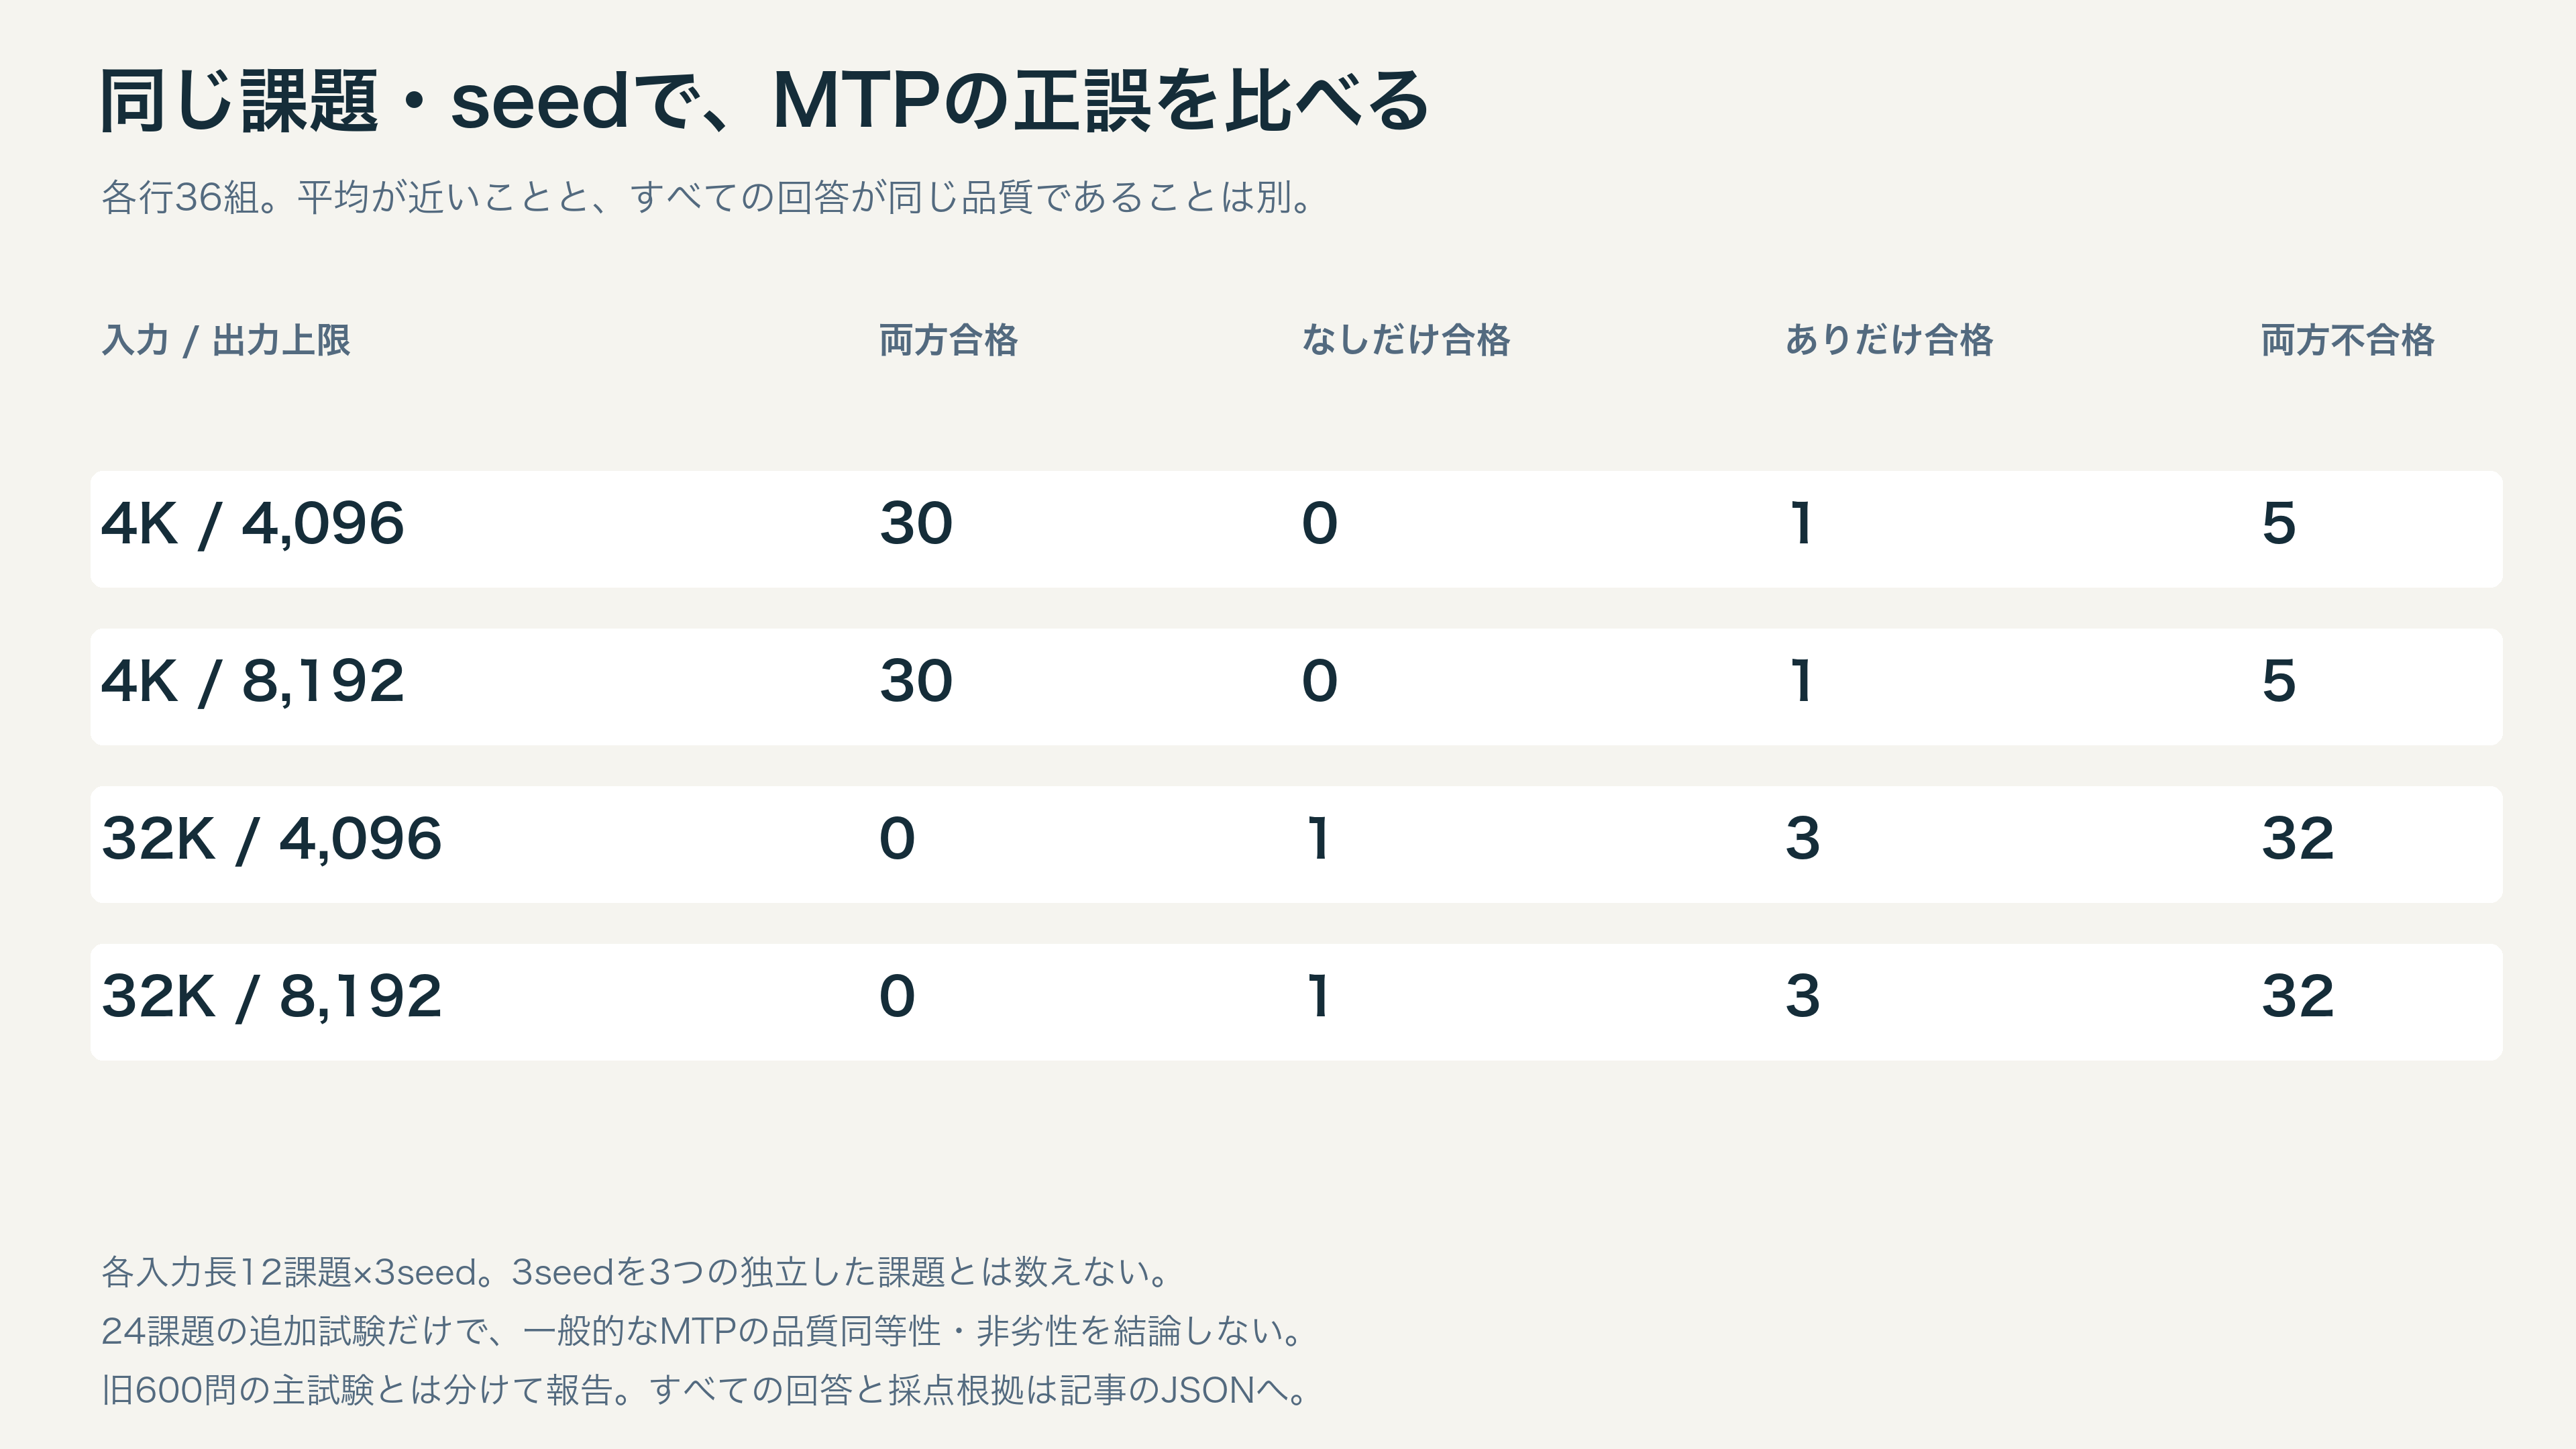
4K・上限4,096の36対では、両方合格30対、なしのみ合格0対、ありのみ合格1対、両方不合格5対でした。
4K・上限8,192の36対では、両方合格30対、なしのみ合格0対、ありのみ合格1対、両方不合格5対でした。
32K・上限4,096の36対では、両方合格0対、なしのみ合格1対、ありのみ合格3対、両方不合格32対でした。
32K・上限8,192の36対では、両方合格0対、なしのみ合格1対、ありのみ合格3対、両方不合格32対でした。
両上限に出る同じ課題・同じseedの悪化例は、独立した二つの課題とは数えません。
この固定問題群から「MTPなら必ず品質が落ちる」とも、「どの回答も劣化しない」とも結論しません。今回の比較相手は同じExLlamaモデルのMTPなしであり、llama.cpp+GGUFとの品質同等性は直接検証していません。
付録:なし正解・あり不正解の全例と、観測できた誤りの経路
平均の正解率で隠れる「なしは合格、ありは不合格」
同じ平均正解率でも、正解する問題が入れ替わることがあります。そこで、同じ課題・seedの対で、MTPなしは合格したのに、ありは不合格になった全例を確認しました。逆方向の改善例と両方の不合格も全件集計に残しています。「合格→不合格」には、内容の誤りだけでなく、出力仕様違反や設問の曖昧さも含まれるため、原因を分けます。
今回の追加試験で該当したのは2対です。課題・seedが同じでも出力上限が違えば別の対として数えます。独立した新問題がその数だけあるという意味ではありません。全対象の回答、誤った項目、確認できた経路は公開JSONに収録しました。
具体例:足す前に「件数」と「待ち秒」を取り違えた
32K資料のlong-records-015、seed289116では、管理部署215行の「件数」の正しい合計は11,482です。MTPなしは正解し、ありは11,535と回答しました。出力された計算過程を元の600行と照合すると、両方とも対象215行のIDを一度ずつ列挙しています。しかし、ありでは38行で「件数」の代わりに同じ行の「待ち秒」を転記していました。
| 資料のID | 正しい件数 | 同じ行の待ち秒 | MTPありで加えた値 |
|---|---|---|---|
| 84 | 37 | 33 | 33 |
| 87 | 43 | 32 | 32 |
| 140 | 6 | 78 | 78 |
| 512 | 84 | 71 | 71 |
ありの転記リストを独立に足すと11,535になり、最終回答と一致します。誤った38個の転記値による合計差は+53です。確認できた誤りは、足す対象の列の取り違えです。4,096と8,192の両上限で、それぞれのMTP条件の出力全文は一致し、両方とも4,096未満で自然終了していました。この例は出力打ち切りでは説明できません。
ただし、出力された計算過程はモデル内部の計算そのものを観測した記録ではありません。なぜMTPありの生成がこの経路へ分岐したのか、MTP実装・量子化・丸め・乱数・キャッシュのどれが原因だったのかは、ここまでの記録から確定していません。
旧600問の11対も、全例を分類する
旧600問×3seedでは、合格数は両方1,664/1,800でしたが、なしだけ合格した対が11、ありだけ合格した対も11ありました。なしで合格した1,664回答を分母にすると、ありで不合格になったのは11/1,664=約0.66%です。これはこの固定課題群での観測値であり、実務全般での障害発生率ではありません。同じ問題のseed違いも含みます。
その11対を確認すると、内容上の明確な誤り7対、数値型・単位の指定違反3対、設問の曖昧さ1対でした。すべて上限に達する前に自然終了しています。平均だけでなく、この内訳を読む必要があります。元の採点結果は変更せず、曖昧な設問の同一テンプレート20問をまとめて除く既存の感度分析も保持しました。
11対すべての回答差と、別枠のgreedy1対を見る
| 課題・生成 | MTPなし | MTPあり | 確認できた誤り/限界 |
|---|---|---|---|
| code-008/greedy/rep0 | [18, 12, 11] | [18, 12, 0] | 正しい添字は1,3,5。ありの末尾0は添字6の値。思考文はなく、内部でどの計算をしたかは不明。 |
| code-056/sampling/rep1 | 10 | 13 | 両方とも昇順リストは正しく列挙。ありは[-2]を最後の値13としている。正解は10。 |
| logic-039/sampling/rep2 | 1 | 2 | 6人は定員6のBだけに入るため元の正解は1。ただし「複数の会議室」を文字どおり読むと2も合理的。明確なMTP品質悪化とは扱わない。既存の20問一括除外感度分析も保持。 |
| arithmetic-053/sampling/rep2 | 93.95 | "93.95%" | 数値93.95は両方同じ。ありは単位付き文字列93.95%を返し、数値に単位を付けない出力仕様に違反。JSON構文自体は妥当。 |
| code-037/sampling/rep0 | 228 | 113 | 正しい状態は29→58→115→228。ありの出力過程は29→58→57→113で、2回目の更新から異なる。 |
| records-012/sampling/rep0 | 542 | 442 | 両方とも同じ12個の正しい加数を列挙。合計は542だが、ありは442と出力した。 |
| arithmetic-018/sampling/rep2 | 89.5 | "89.50%" | 89.5と89.50%は数量として同じだが、ありは単位付き文字列を返す。計算の間違いと区別する。 |
| code-054/sampling/rep1 | 101 | 87 | 正しい項は0,-5,18,18,4,45,0,21。ありは2項目を-25、4項目を24としている。その誤った項の合計は出力87と一致する。 |
| logic-027/sampling/rep0 | "断定できない" | "断定できる" | 障害なら通知という規則と通知の存在だけでは障害を断定できない。ありの断定できるは誤り。思考文がないので内部の誤推論の経路は不明。 |
| arithmetic-092/sampling/rep1 | 75 | 74 | 両方とも商74.01…を認識。74箱では5402個しか入らず、残り1個のため75箱必要。ありは74箱と回答した。 |
| records-037/sampling/rep1 | 371 | 381 | 両方とも同じ12個の正しい加数を列挙。合計は371だが、ありは381と出力した。 |
| arithmetic-058/sampling/rep2 | 87.96 | "87.96%" | 数値87.96は両方同じ。ありだけ単位付き文字列87.96%を返す出力仕様違反。 |
数値が同じでも「93.95」と「"93.95%"」は、自動処理で数値型を求める仕様では異なります。ただし、計算そのものの誤りとは区別します。また、会議室を「複数」に分けるという設問の曖昧さを、MTPが品質を落とした明確な例には数えません。
付録:MTPの品質保証を扱う論文、量子化、未検証の対照試験
論文では、高速化の代償をどう説明しているか
MTPは候補を先に作る役目です。候補を本体モデルで検証し、正しい採用手続きに従うspeculative decodingは、理論上、元のモデルの出力確率分布を保てます。検証とは、本体モデルが選ぶトークンに従う処理であり、事実・計算の正誤を検査する機能ではありません。元のモデルが間違える可能性も、その分布に含まれます。
- Fast Inference from Transformers via Speculative Decoding(ICML 2023):正しい検証・サンプリングで対象モデルの出力確率分布を保つ方式を示し、T5-XXLで2〜3倍の高速化を報告。 GLM・ExLlamaV3・3.10bpwでの個別回答の一致や品質を直接検証した研究ではない。
- DeepSeek-V3 Technical Report, section5.4.3(Technical report v2):MTPの2番目トークンの採用率85〜90%、生成tokens/s1.8倍を報告。 採用率は回答正解率ではない。この節はなし正解・あり誤答の全例分類を提供していない。MTP学習のアブレーションと推論時ON/OFFは別の比較。
- Speculative Decoding: Performance or Illusion?(arXiv2601.11580v2, revised2026-03-18):H100・vLLMでMTPを含む方式を評価。候補生成・検証の時間、採用率、バッチ数によって効果が変化。GLM-4.5-AirのMTPも測定。greedyでも出力長の差を観測。 メモリ表はモデル仕様に基づく重みとKVの計算値で、実行中activationを含まない。GLM-5.3-Flashの3bit品質比較ではない。著者の数値非決定性という説明だけで今回の原因を確定しない。
- Understanding and Mitigating Numerical Sources of Nondeterminism in LLM Inference(NeurIPS2025):バッチ数・GPU構成などによる浮動小数点の丸め差が、推論モデルの回答列や精度へ波及することを実測。 MTP専用研究ではなく、今回の差の原因を証明しない。重みを3bitから4bitにする変更と、演算精度をFP32へ変える変更は同じでない。
- A Theoretical Perspective for Speculative Decoding Algorithm(NeurIPS2024):分布保存方式を解析した上で、分布の偏りを許す拡張について推論コストと品質指標のトレードオフを理論解析。 対象は定義されたアルゴリズム族と分布のずれであり、一般的な日本語実務正解率の低下量ではない。今回ExLlamaV3がその緩い採用方式を使う証拠として扱わない。
- Windowed-MTP: Removing the Full-Context Draft-KV Tax at Million-Token Context(arXiv2607.21535v1 preprint):実1M入力ではMTP候補側の全履歴KV参照が負担になる。SGLangの別モデル群で、深い先読みがMTPなしより遅くなる条件、候補KVが全KVの7.7〜11%を占める測定を報告。 GLM/ExLlamaV3の実測ではない。当試験は1M容量だが実入力は4K/32Kであり、1Mを埋めた結果へ転用しない。
「採用率90%」は先読み候補の採用割合であり、「回答の正解率90%」ではありません。また、分布が同じという保証は、有限回の正解率や、同じseedでの出力文字列が必ず一致するという意味ではありません。理論上の条件と実機での挙動を分けて確認します。
主に比較すべき代償は、候補を作って検証する追加計算、補助モデルとKVのメモリ、最初の返答までの待ち時間、同時処理時の性能です。今回の比較では配置条件をそろえるため、MTPなしにも補助モデルとKVを保持しました。そのため、MTPを全く読み込まない構成に対する追加VRAM量は測っていません。同時多数要求の性能や消費電力量も、この単一要求の試験からは分かりません。
ExLlamaV3の当該版では、本体でサンプリングしたトークンと候補の一致で採用を判定し、不一致時に候補側を巻き戻す処理を確認しました。先読みに伴う乱数状態の復元処理もあるため、回答差を単に「乱数を余分に使ったため」とは断定しません。数値丸めの論文も、今回の原因を直接証明するものではありません。確認した実装
3bitから4bitにすると解決するのか
今回の重みはEXL3のsc_3.10bpw、平均約3.10bit/weightです。すべての層が一律3bitという意味ではありません。sc_4.10bpw版もありますが、比較測定はしていません。量子化を細かくすることで誤差が減り、回答が改善する可能性はあります。しかし、全問正解やMTPなしとの回答一致を保証するものではありません。
4.10bpw版の重みファイルは約156.2GiBあり、H100×2の合計メモリに近づきます。ファイル容量と実際のGPU常駐量は同一ではありませんが、KVや作業領域も必要なため、現在の1M容量・全GPU配置の条件で安全に収まるとは判断できませんでした。これは事前の容量評価であり、4bit版を読み込んで失敗したという結果ではありません。3bitと4bitの差、MTPの有無、演算の丸めの影響は、別々に比較する必要があります。
各条件36回答は、12課題を3seedで繰り返したものです。36個の独立した実務課題とは数えません。この24課題の追試だけで、一般的な品質同等性や32K品質の非劣性を結論していません。元の600問で事前に定めた非劣性の結果と、今回の資料課題の結果は分けて解釈します。平均が近くても全問正解とは限らず、個別の悪化や改善が相殺される場合もあります。
確保した容量は1M、実入力は4Kと32Kです。250K・1Mまで履歴を埋めた品質や、エージェントの自動圧縮設定、ツールを使う業務全体の成功率は未検証です。量子化は3.10bpwで固定しており、4bit版による改善も測っていません。今回の追試では8,192を超える出力上限を測っていません。
採点とタイミングは保存ログから再計算し、H100とMacの全回収ファイルをSHA256で照合しました。最終回答の確認者はCodexです。人間が全回答・全音声を確認したという意味ではありません。上限終了した思考を最終回答に読み替えません。
追加試験の条件・全件集計・項目別採点・確認記録(JSON) / 追加288回答・ウォームアップ4回答・旧48回答の全文と入力(JSON) / なし合格・あり不合格の全例、回答全文、誤りの分類(JSON)。元の600問のデータも後半のリンクから確認できます。
出力上限を増やす前のMTP基礎・品質解説動画も試験履歴として保持しています。
二つの「速さ」を測る
最初の指標はTTFT、最初のトークンが返るまでの時間です。入力処理に加え、呼び出し方式や初回生成などの影響も含みます。ここでいう待ち時間は、モデルファイルをディスクから読み込む時間ではありません。モデルは事前に読み込み済みです。
二つ目は生成tokens/sです。今回の値は各試行の生成区間の平均速度を求め、その3回の中央値を示しています。思考・制御用のトークンもエンジンの生成数に含まれ、画面に見える日本語の文字数毎秒とは異なります。
まず構成を変更した比較
入力は約8Kと32K。実入力長は8,193と32,768トークンです。同時利用は1、コンテキスト容量は40,960、生成上限は1,024トークンで、各条件を3回測りました。
| 構成 | 8K 初回生成 / 生成速度 | 32K 初回生成 / 生成速度 |
|---|---|---|
| llama.cpp・B200×1 | 22.33秒 / 63.57 tokens/s | 84.15秒 / 61.72 tokens/s |
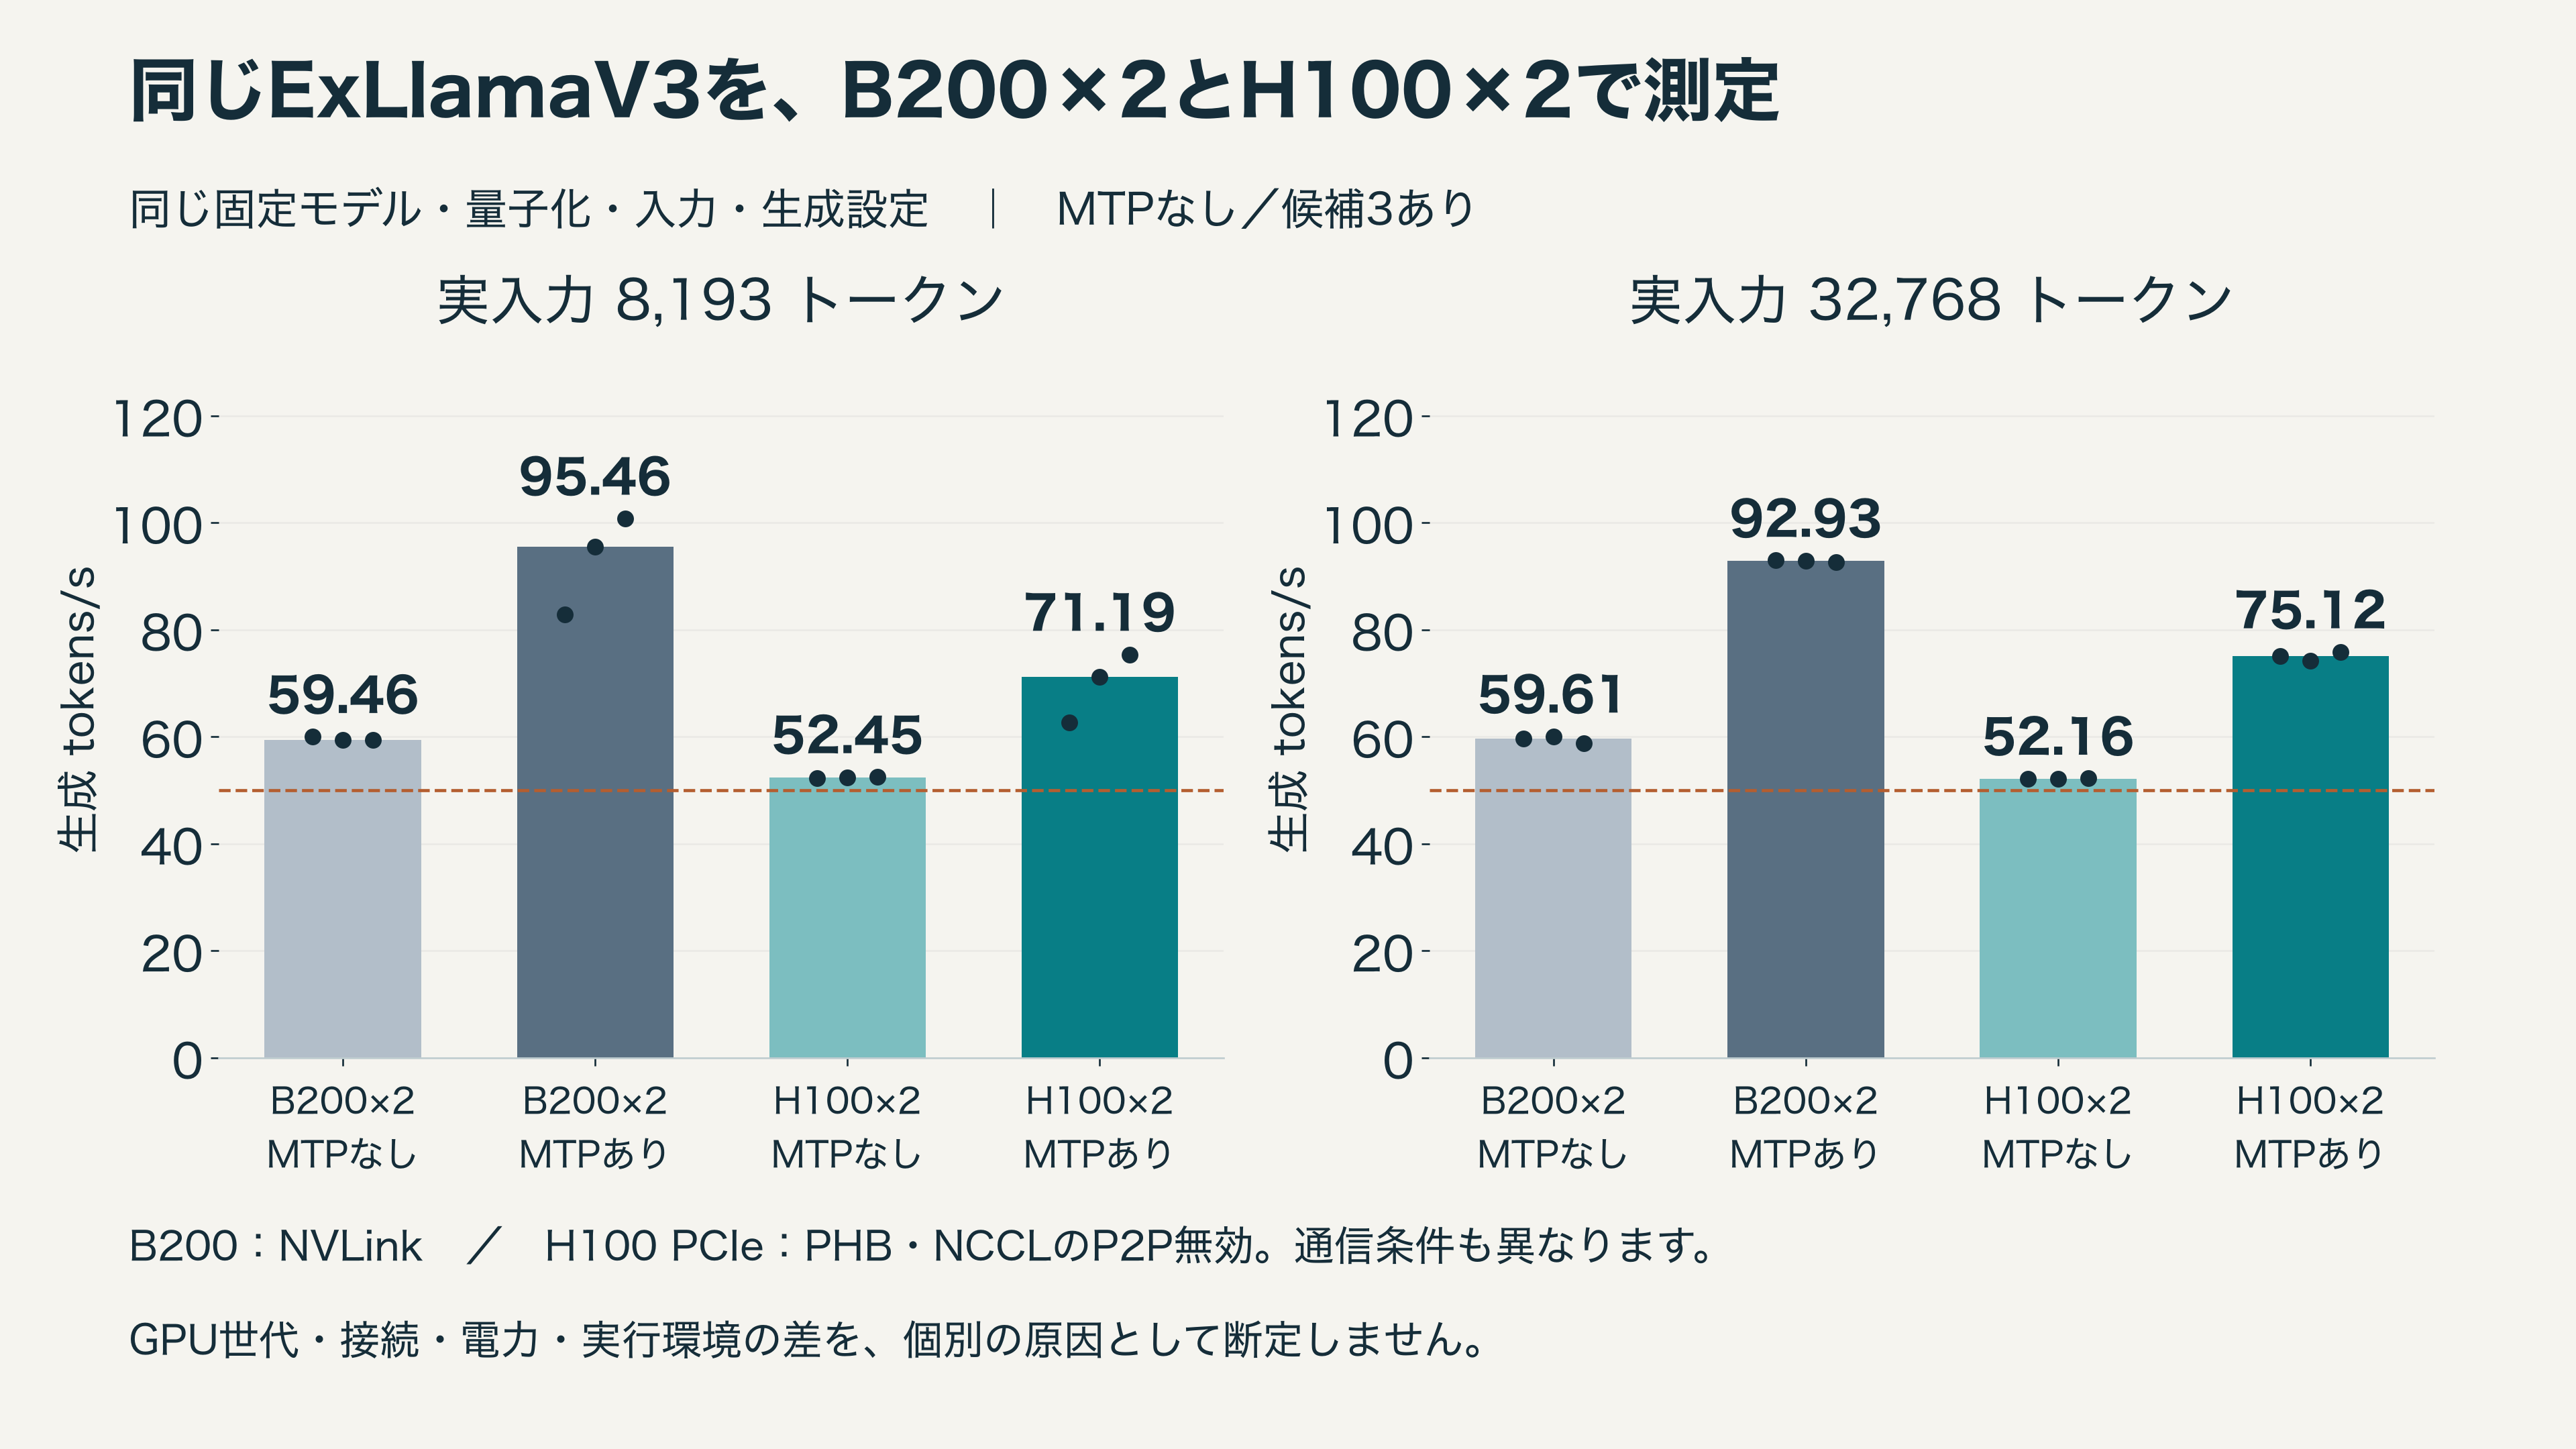
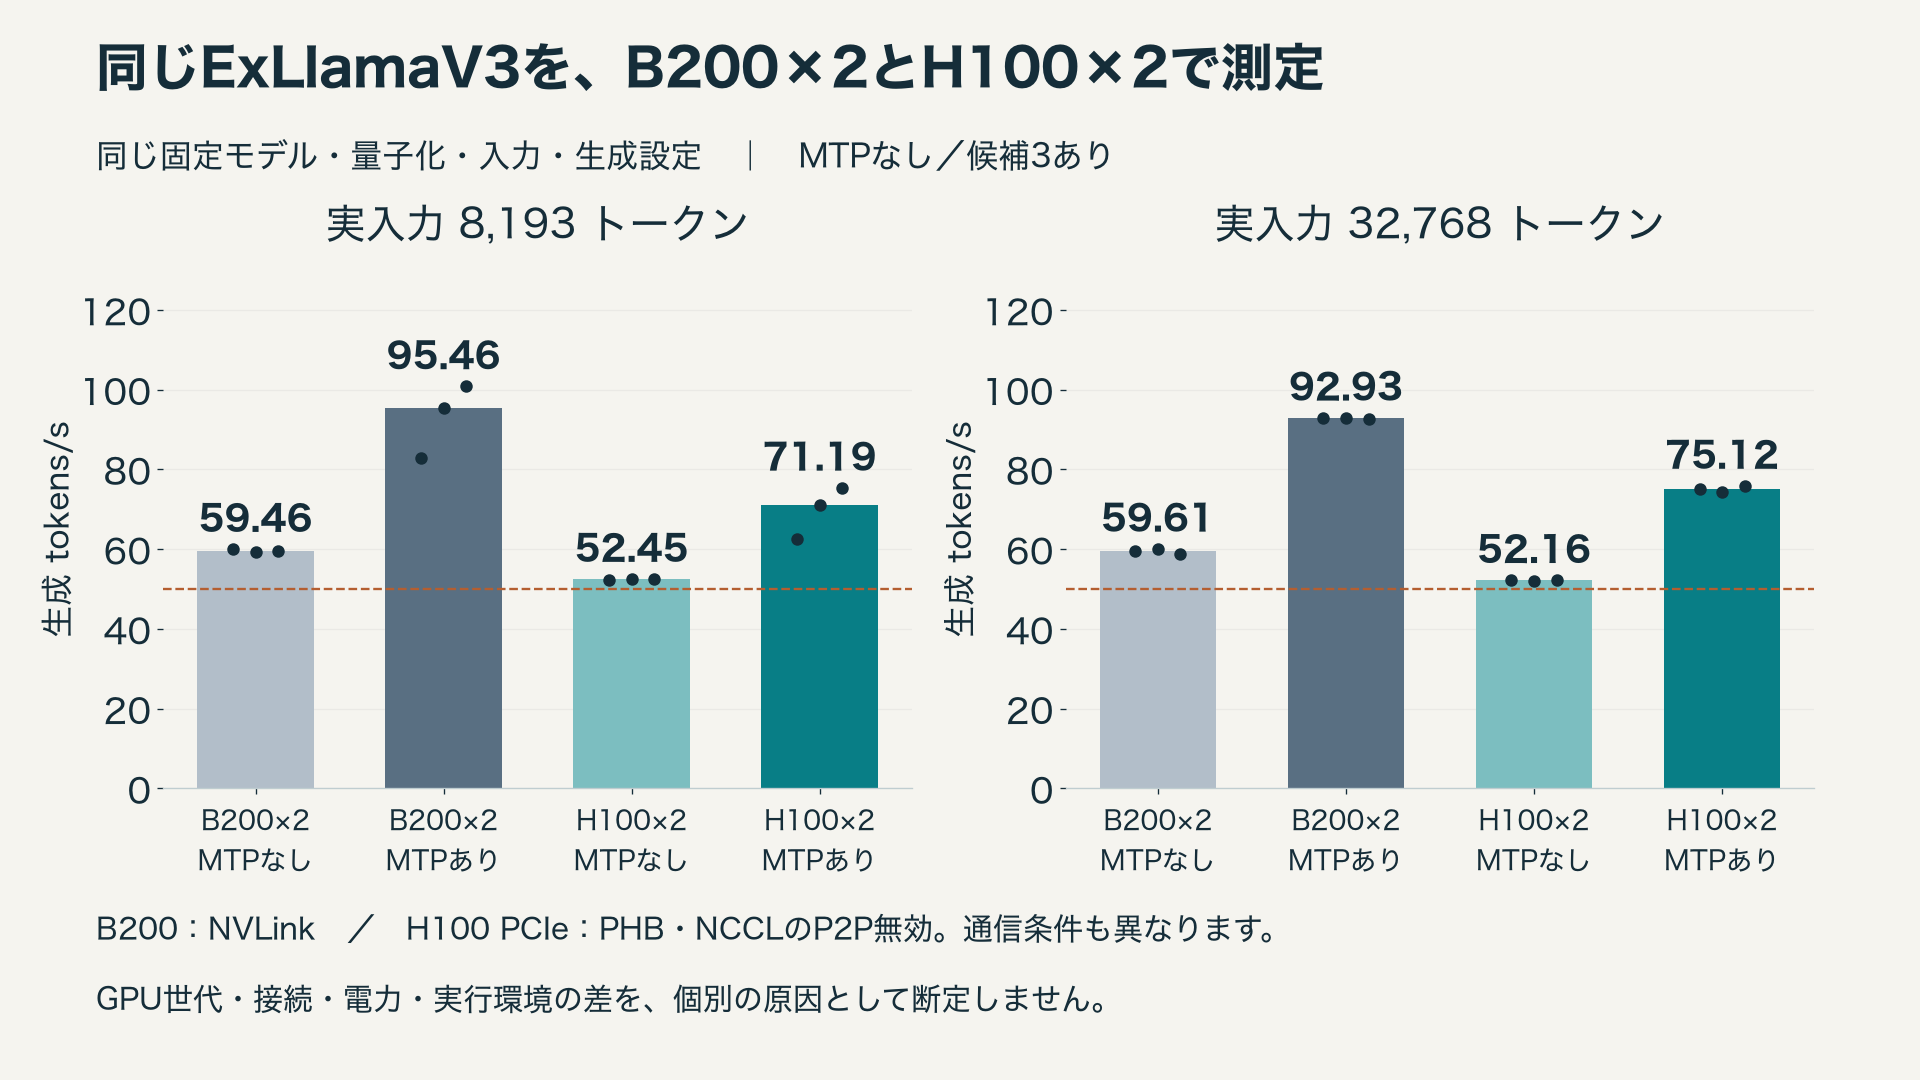
| ExLlamaV3・B200×2・MTPなし | 2.11秒 / 59.46 tokens/s | 8.28秒 / 59.61 tokens/s |
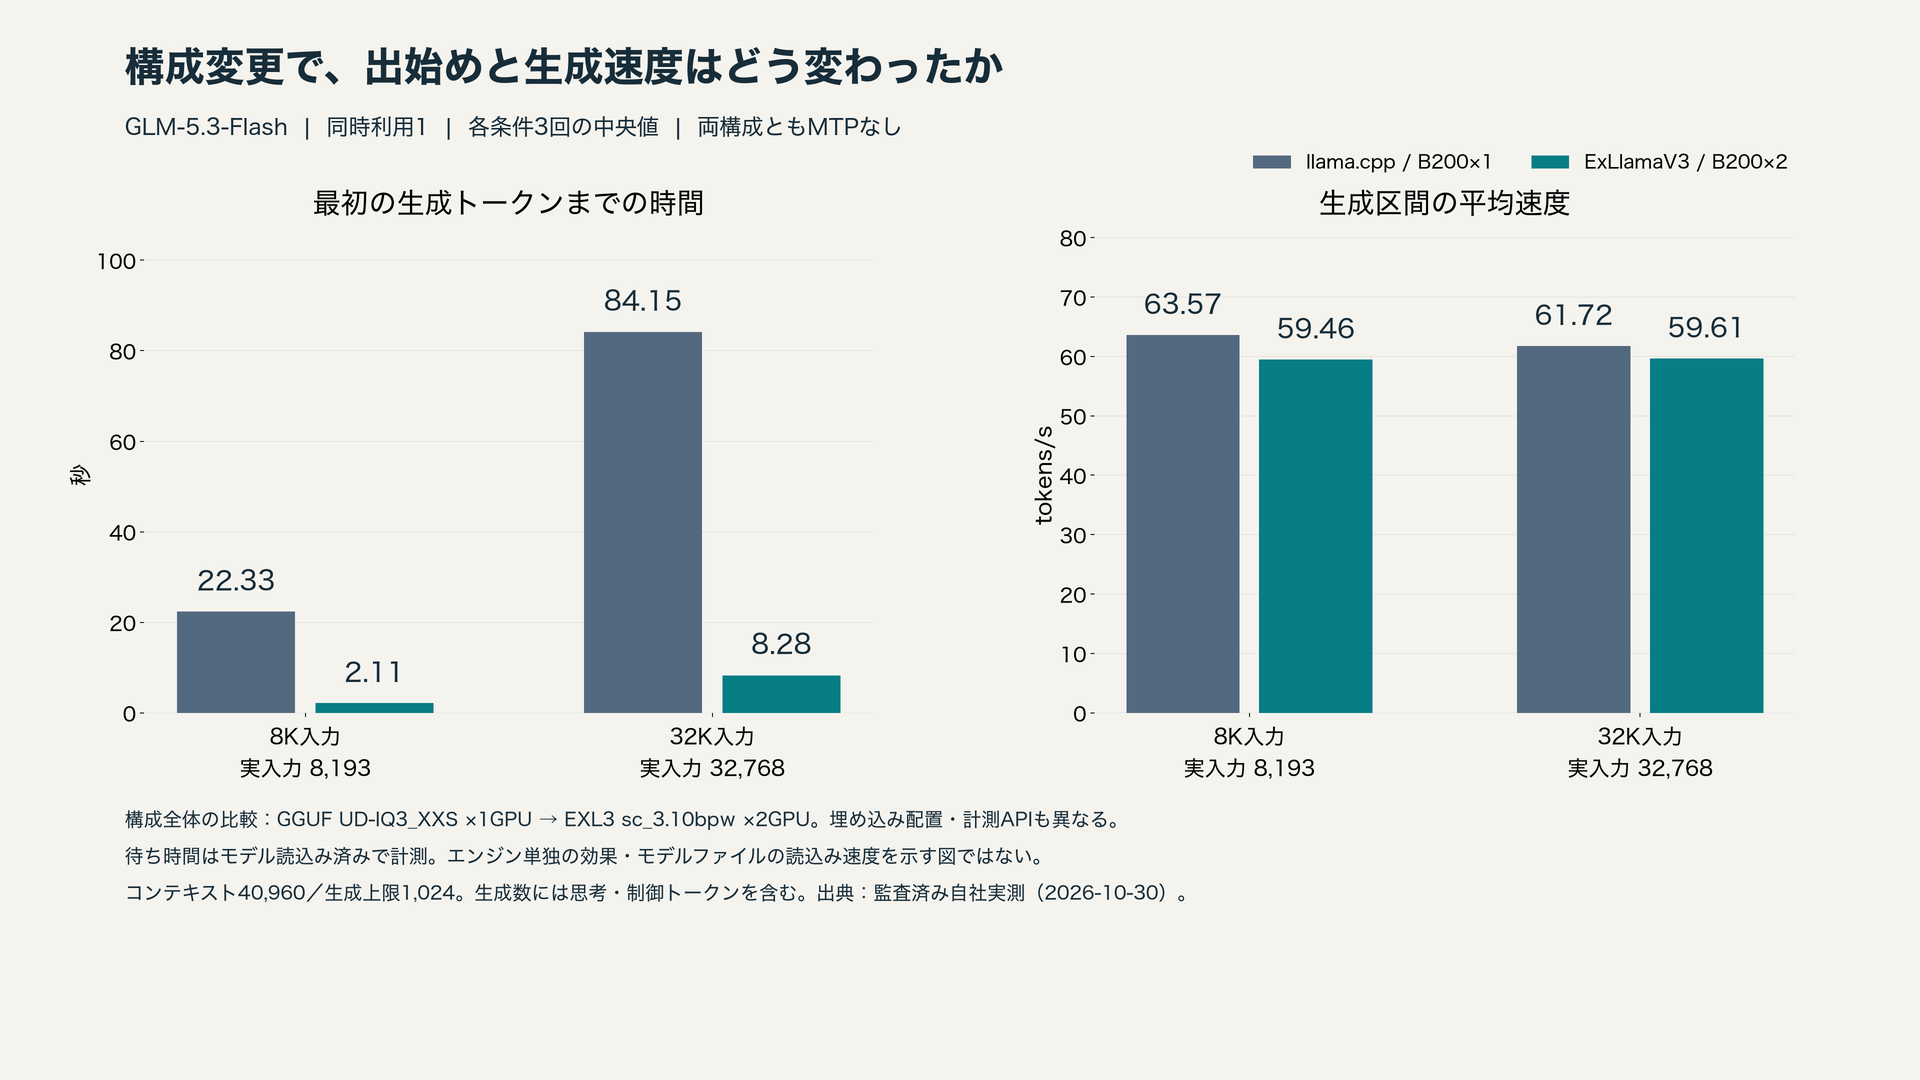
待ち時間はこの構成比較で約10分の1でしたが、生成速度の改善は確認できません。ここは「エンジンを変えればすべてが速くなる」とは書けない結果です。
比較には条件差があります。llama.cpp側はGGUFのUD-IQ3_XXSと1GPU、ExLlamaV3側はEXL3のsc_3.10bpwと2GPUです。さらに埋め込みの配置と計測インターフェースも異なります。旧構成はHTTP、新構成はプロセス内APIです。したがって、待ち時間の差は構成全体の実測差であり、エンジン単独の効果や純粋な入力処理の10倍高速化を示すものではありません。
次にMTPだけの有無を比較
MTPはMulti-Token Predictionの略です。今回の使い方では、先のトークン候補を予測し、本体モデルで検証しながら採用することで、生成処理を速くすることを狙います。候補が採用される割合と検証の負担によって効果は変わります。3トークン先を予測する設定だから3倍になる、という意味ではありません。
MTP比較では、同じモデル・量子化・ExLlamaV3の版・B200×2・入力・サンプリング設定を固定し、3トークンのドラフトと必要な追加キャッシュを有効にしました。
| 実入力トークン | MTPなし | MTPあり | 中央値の速度比 |
|---|---|---|---|
| 8,193 | 59.46 | 95.46 | 1.61倍 |
| 32,768 | 59.61 | 92.93 | 1.56倍 |
単位はtokens/s、各3回の中央値です。
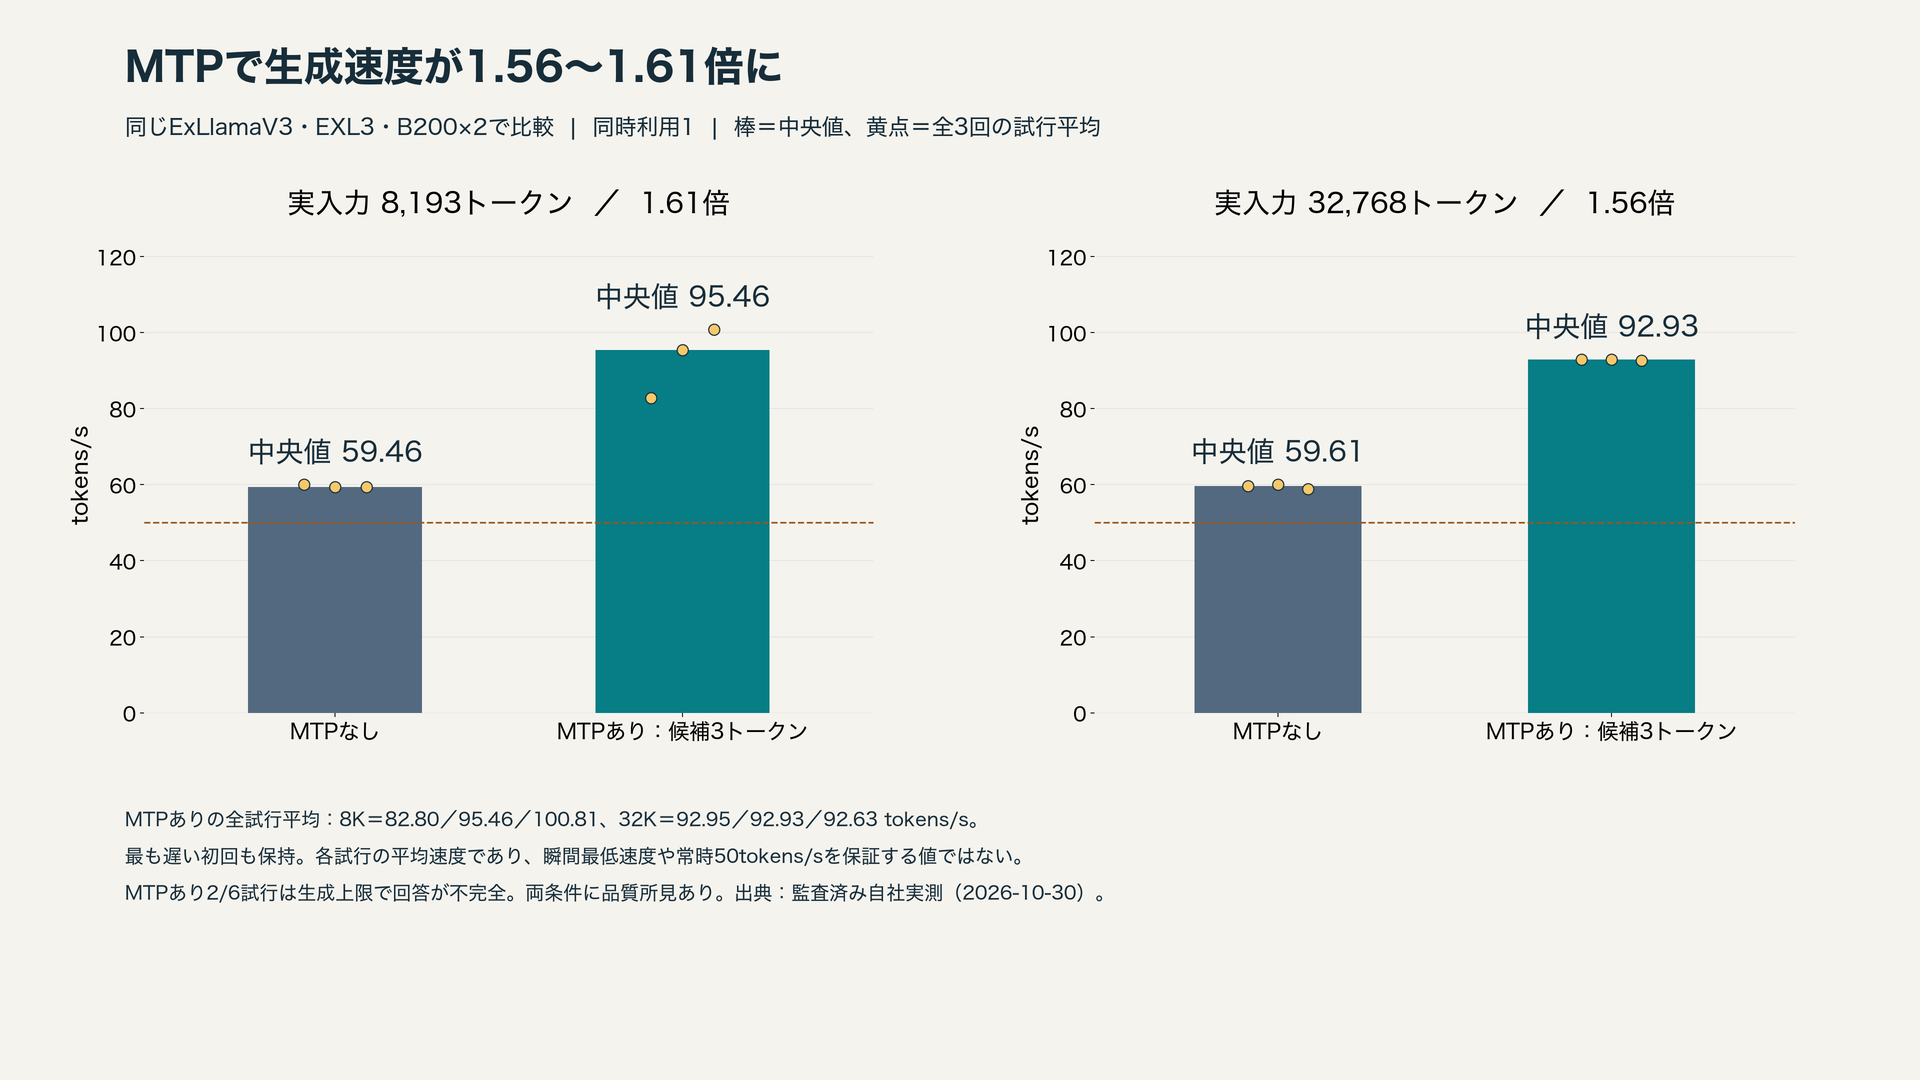
MTPありの全6試行の平均生成速度は50tokens/sを超えました。8Kの3回は82.80、95.46、100.81tokens/s、32Kの3回は92.95、92.93、92.63tokens/sです。最も遅かった最初の8K試行も除外していません。主モデルのウォームアップは行っていますが、各本測定プロセス内で別途MTP生成をしてから計時したわけではなく、初回特有の負担が残った可能性はあります。原因は断定しません。
MTPが速くしたのは生成区間
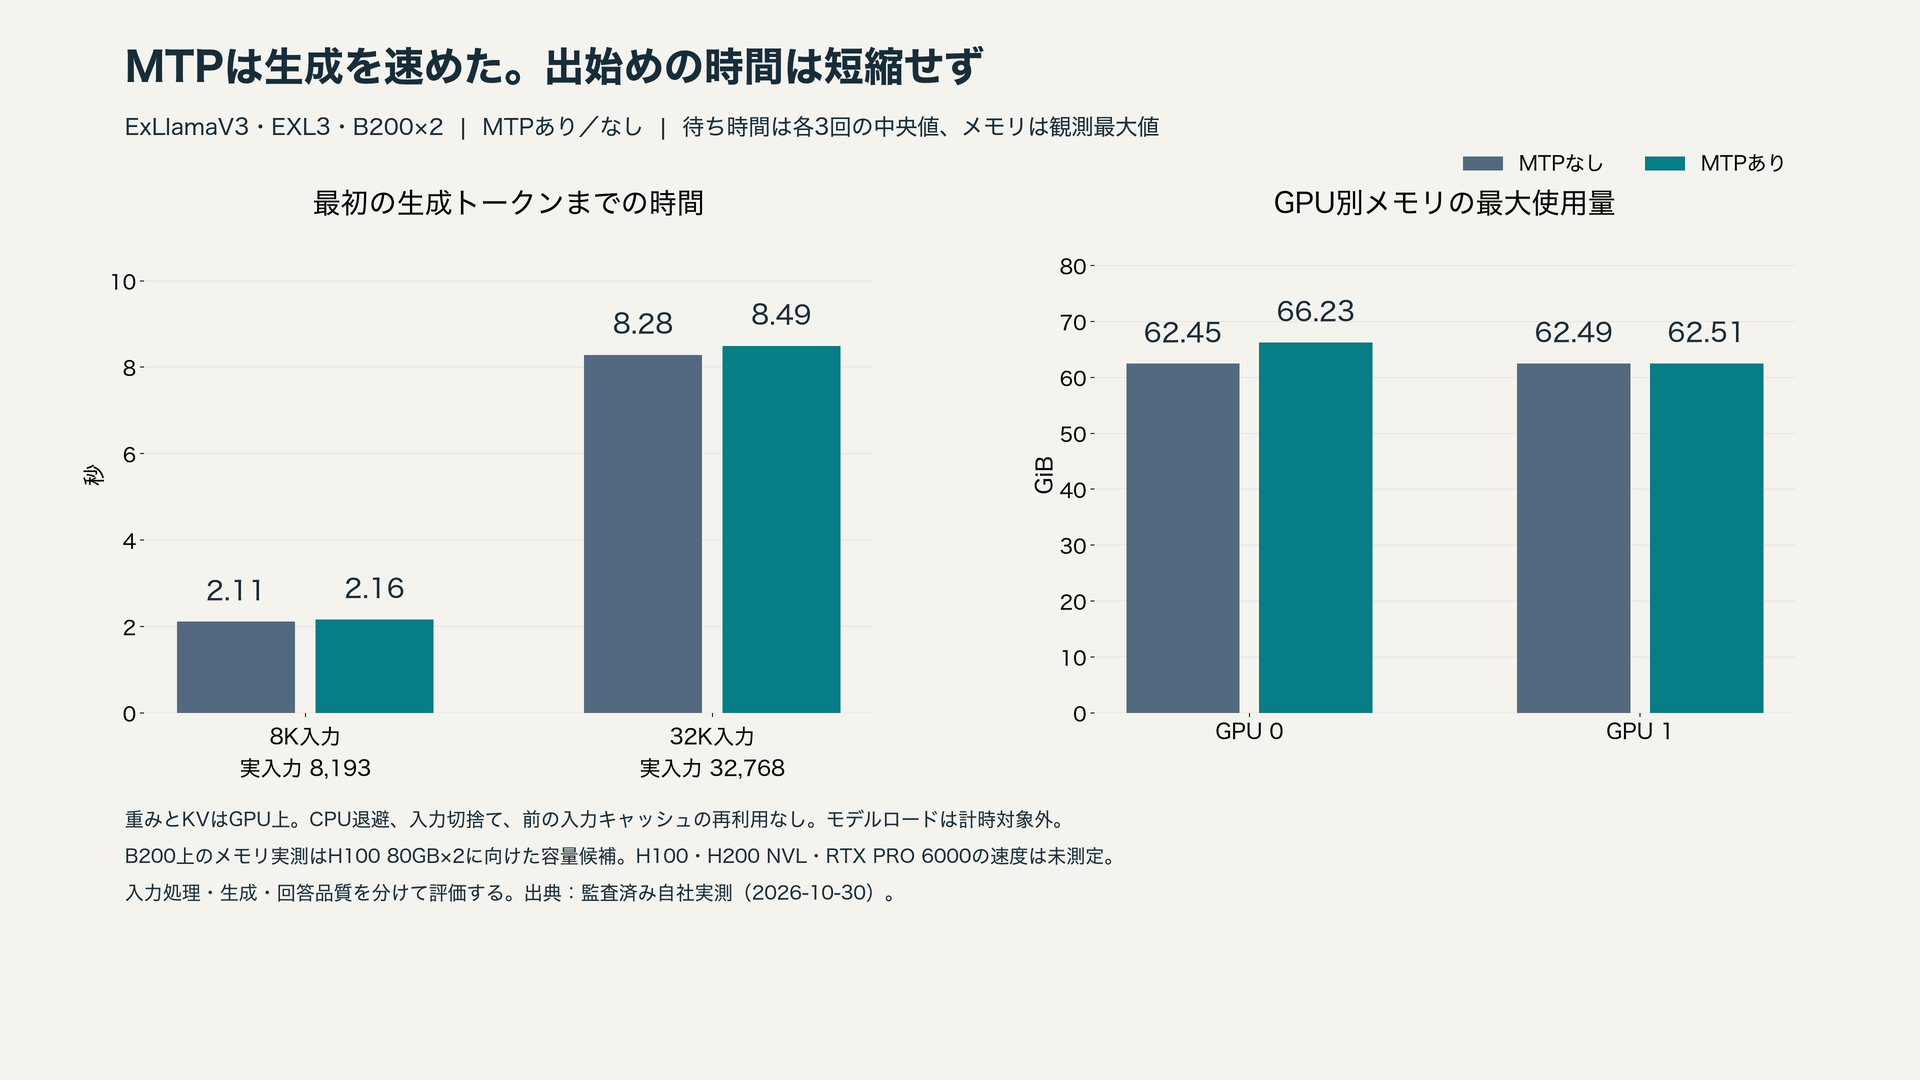
最初の生成トークンまでの時間は、8Kで2.11秒から2.16秒、32Kで8.28秒から8.49秒となり、短縮しませんでした。MTPは今回、回答の出始めより、その後の生成速度を改善しました。思考が終わった後の最初の可視回答も別に計測し、MTPありの中央値は約2.16秒と8.49秒でした。
GPU別のメモリ最大使用量は、MTPなしで約62.45/62.49GiB、MTPありで約66.23/62.51GiB。重みとKVはGPU上に置き、CPU退避、入力の切り捨て、前の入力キャッシュの再利用は行っていません。埋め込みもGPUに置くため、隔離した実行環境に適用した変更を再現情報として記録しています。
速度が測れたことと、回答が合格したこと
短い決定的な確認問題4問では、MTPの有無で同じ正答が得られました。ただし長い日本語タスクの全文を確認すると、MTPなし・ありの双方に数値や指標説明の誤りがあります。MTPありの2試行は生成上限の1,024トークンに達し、回答が途中で終わりました。すべての出力を保存し、速い結果だけを選び直してはいません。
同じ乱数seedでもサンプリング経路が違うと出力は一致しないため、この小規模試験でMTPによる品質向上・劣化を断定しません。6回の平均が50tokens/sを超えたことも、常時50tokens/sや業務用途での品質保証とは分けて扱います。
llama.cppでもMTPを検証:同じGGUF・2GPUでの比較
追加試験では、GLM-5.3-FlashのGGUF UD-IQ3_XXSと同じllama.cpp版を使い、B200×2でMTPなし/ありを比較しました。両条件ともlayer分割1:1、埋め込みをGPUへ配置し、入力・生成上限・サンプリング・同時利用1を固定しています。MTPありはdraft-mtp、候補上限3、probabilistic samplingです。
| 実入力トークン | MTPなし | MTPあり | 中央値の速度比 |
|---|---|---|---|
| 8,193 | 62.43 | 79.83 | 1.28倍 |
| 32,768 | 60.67 | 72.78 | 1.20倍 |
単位はtokens/s、各3回の中央値です。
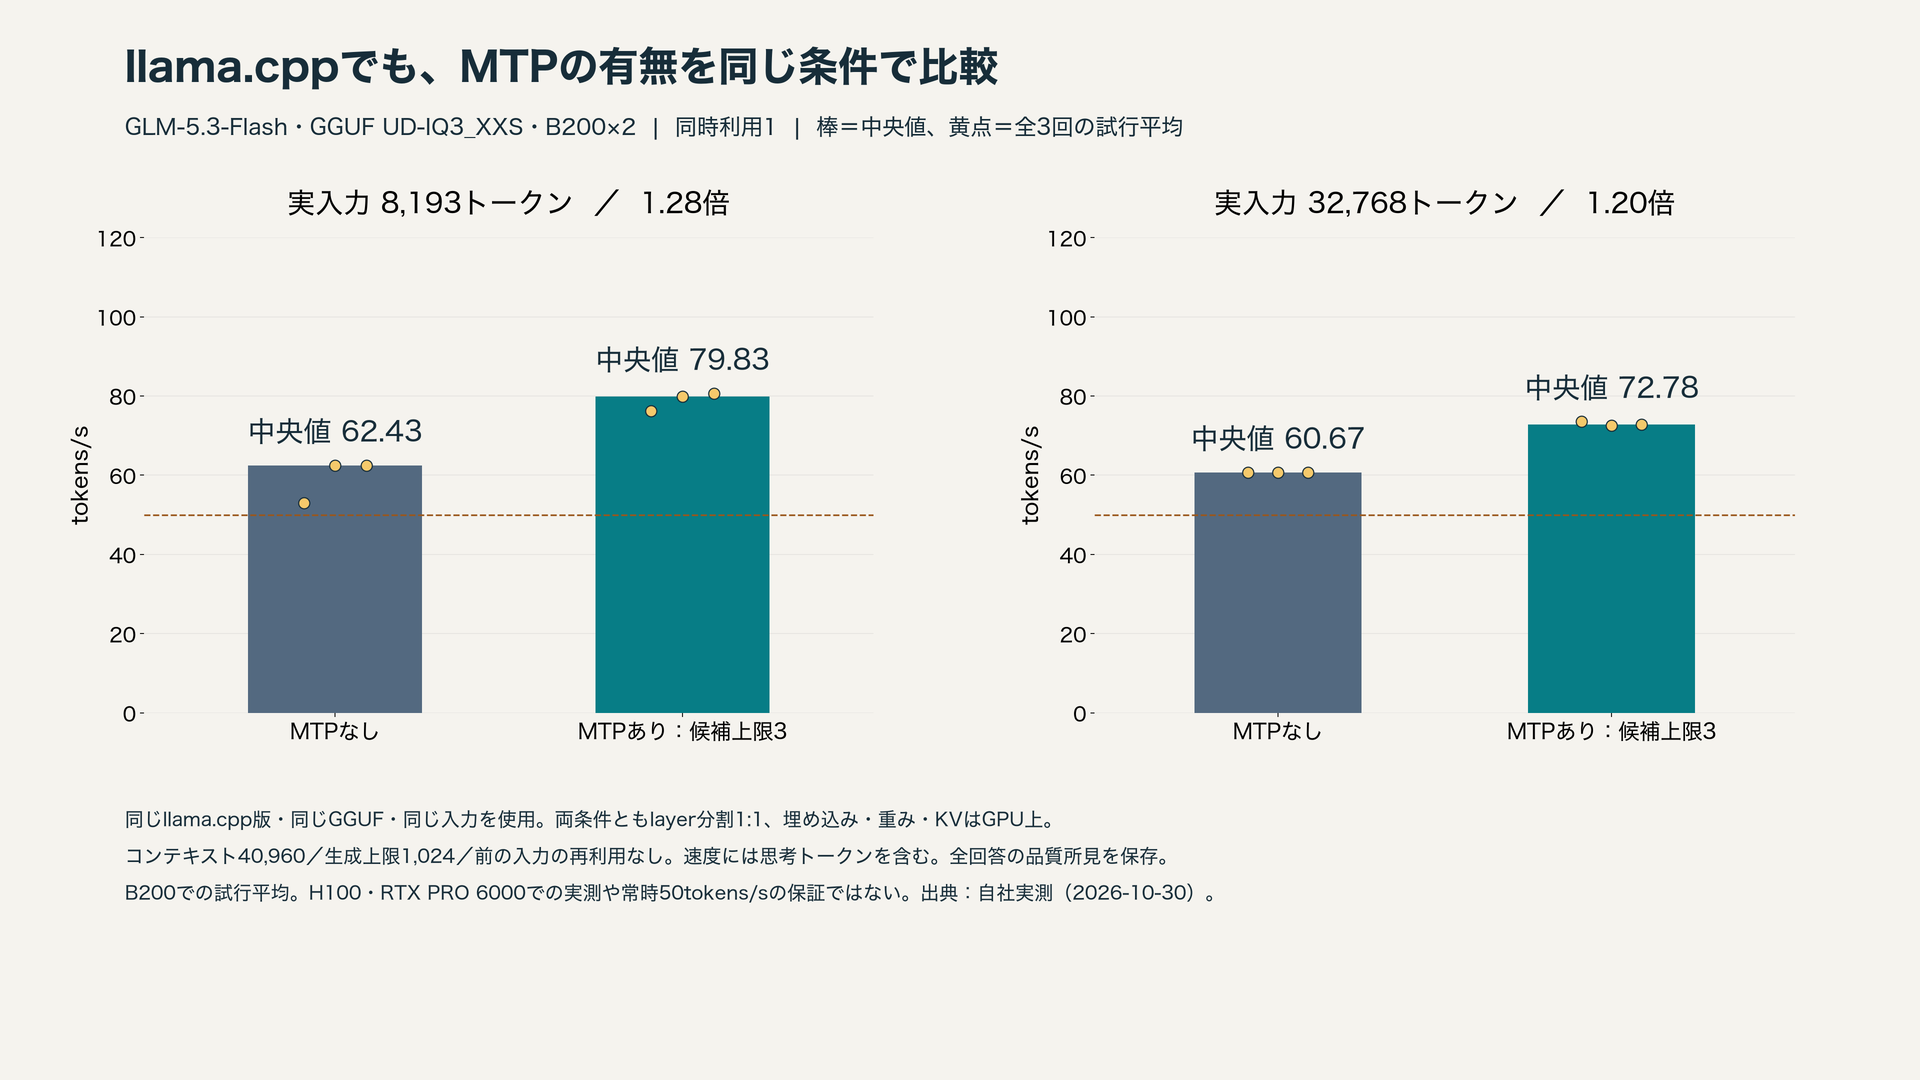
全試行も保持しています。
実入力8,193、MTPなし:53.01/62.43/62.51 tokens/s。
実入力8,193、MTPあり:76.23/79.83/80.60 tokens/s。
実入力32,768、MTPなし:60.64/60.67/60.70 tokens/s。
実入力32,768、MTPあり:73.52/72.59/72.78 tokens/s。
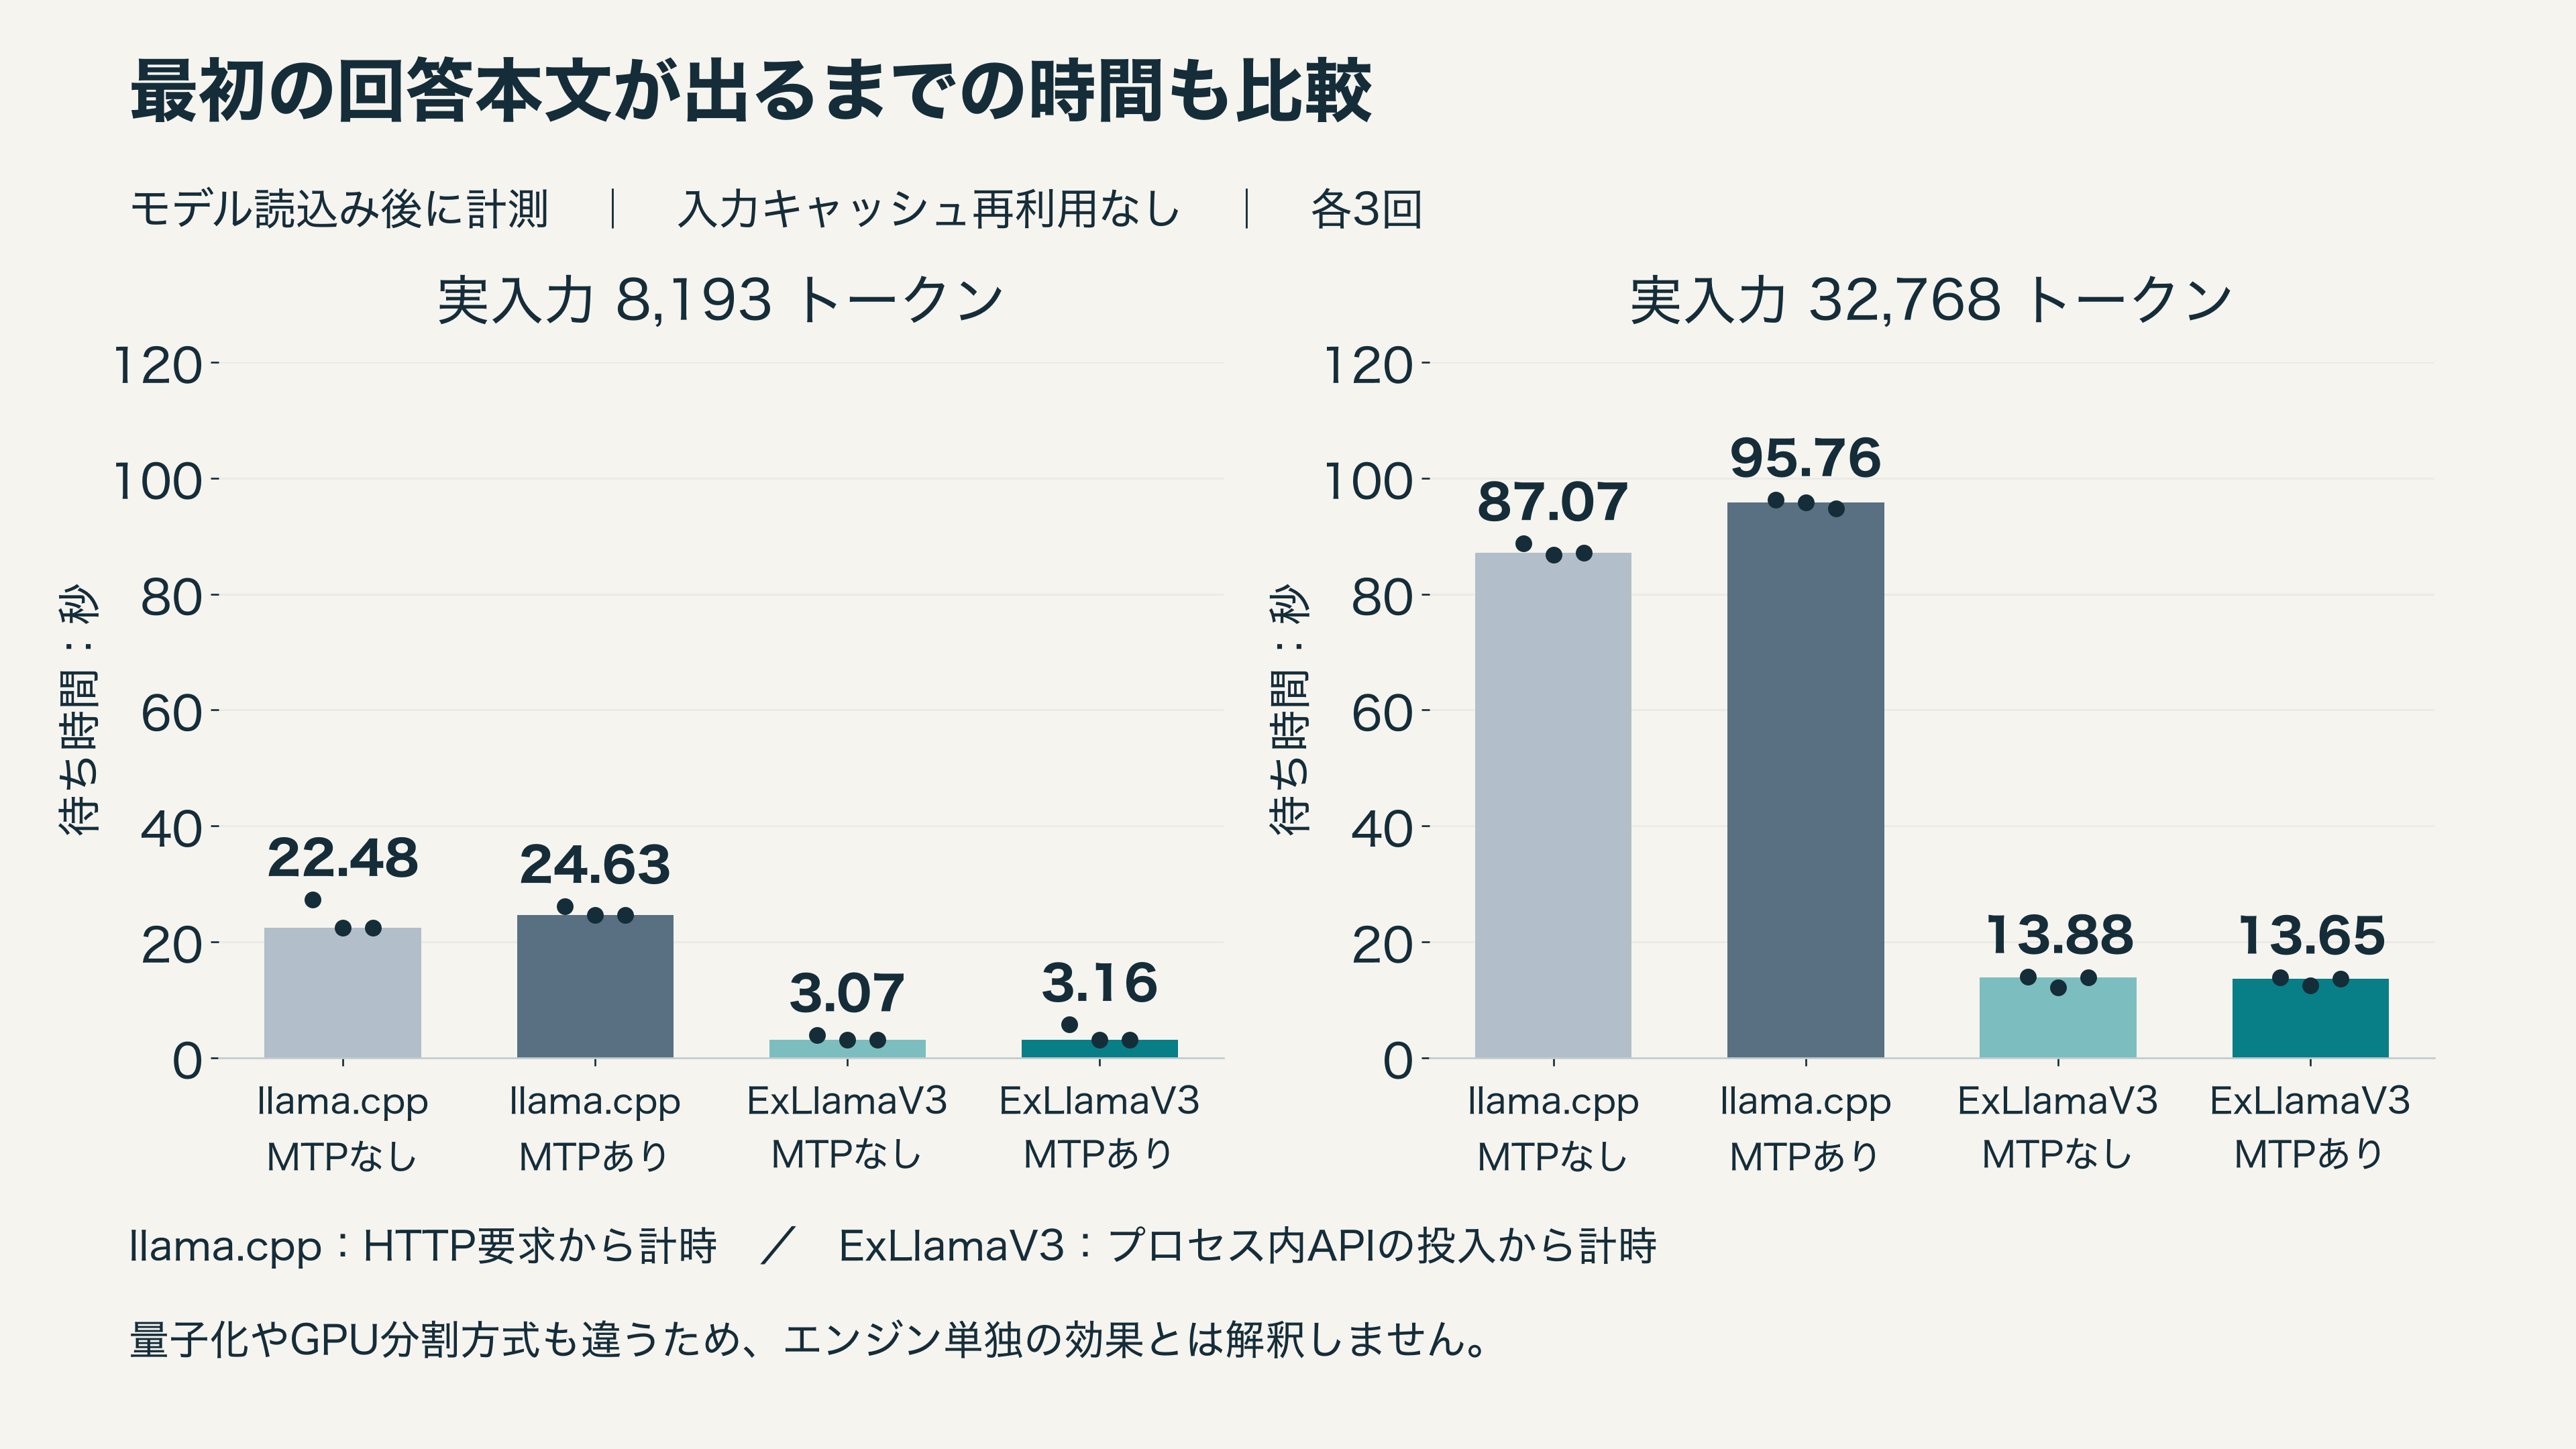
最初のストリーミング生成テキストが返るまでの中央値は、8K入力で15.28秒→16.87秒、32K入力で58.56秒→64.47秒でした。これはモデルロード時間ではなく、入力送信からの時間です。思考を除く最初の回答テキストは別に測定し、MTPありではそれぞれ16.87秒/65.02秒でした。
入力処理時間と最初の応答を、生成tokens/sとは別に掲載します。MTPによる生成速度の変化を、そのまま応答開始時間の改善と解釈しません。
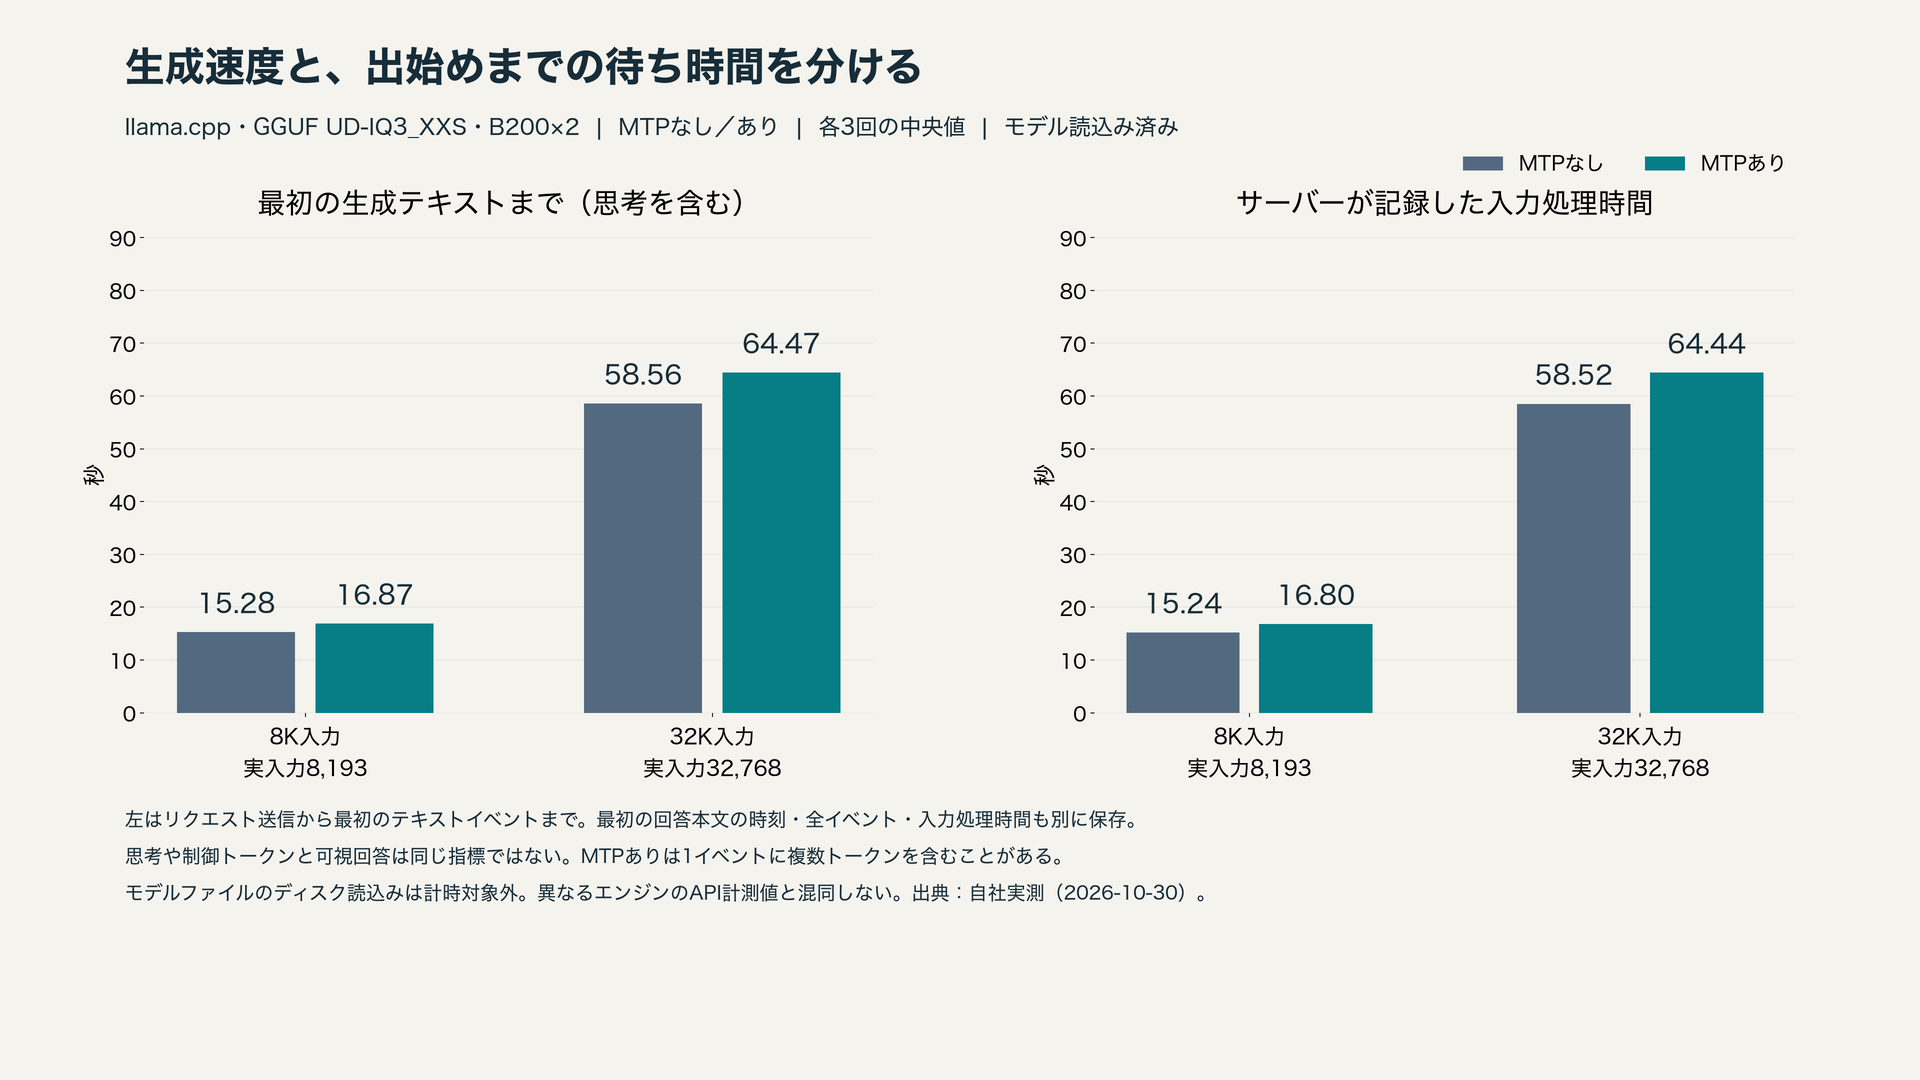
GPU別ピークは、MTPなし56.85/55.36GiB、MTPあり57.09/58.45GiBでした。重み・KVはGPU上にあり、CPU退避、入力切捨て、コンテキストの自動縮小、前の入力の再利用はありません。
生成上限で終了した試行はMTPなし0/6、あり1/6です。回答全文は別途確認し、数値・計算・因果関係の説明などに所見があるため、速度測定の成立を回答品質の合格とは扱いません。同じseedでも投機的サンプリングにより文章は変わり得ます。
この節の結果はB200×2の実測です。続いて同じ固定モデル・llama.cppをH100 80GB×2でも検証し、結果を次節に掲載しました。RTX PRO 6000 Blackwell×2は未測定です。実測した試行の平均速度と、常時の速度保証を区別します。
旧llama.cpp・1GPU比較はGPU数と埋め込み配置が異なる別条件です。ExLlamaV3との比較も量子化・分割・APIが異なり、各エンジン内のMTPあり/なしを主比較とします。
実装の一次資料:https://github.com/ggml-org/llama.cpp/pull/29928
固定モデル・ランタイム・全入力・全出力・ログ・SHA256回収照合・品質所見を共通データに保存しています。
H100 80GB×2でGLM-5.3-Flashは単一利用50 tokens/sを超えたか
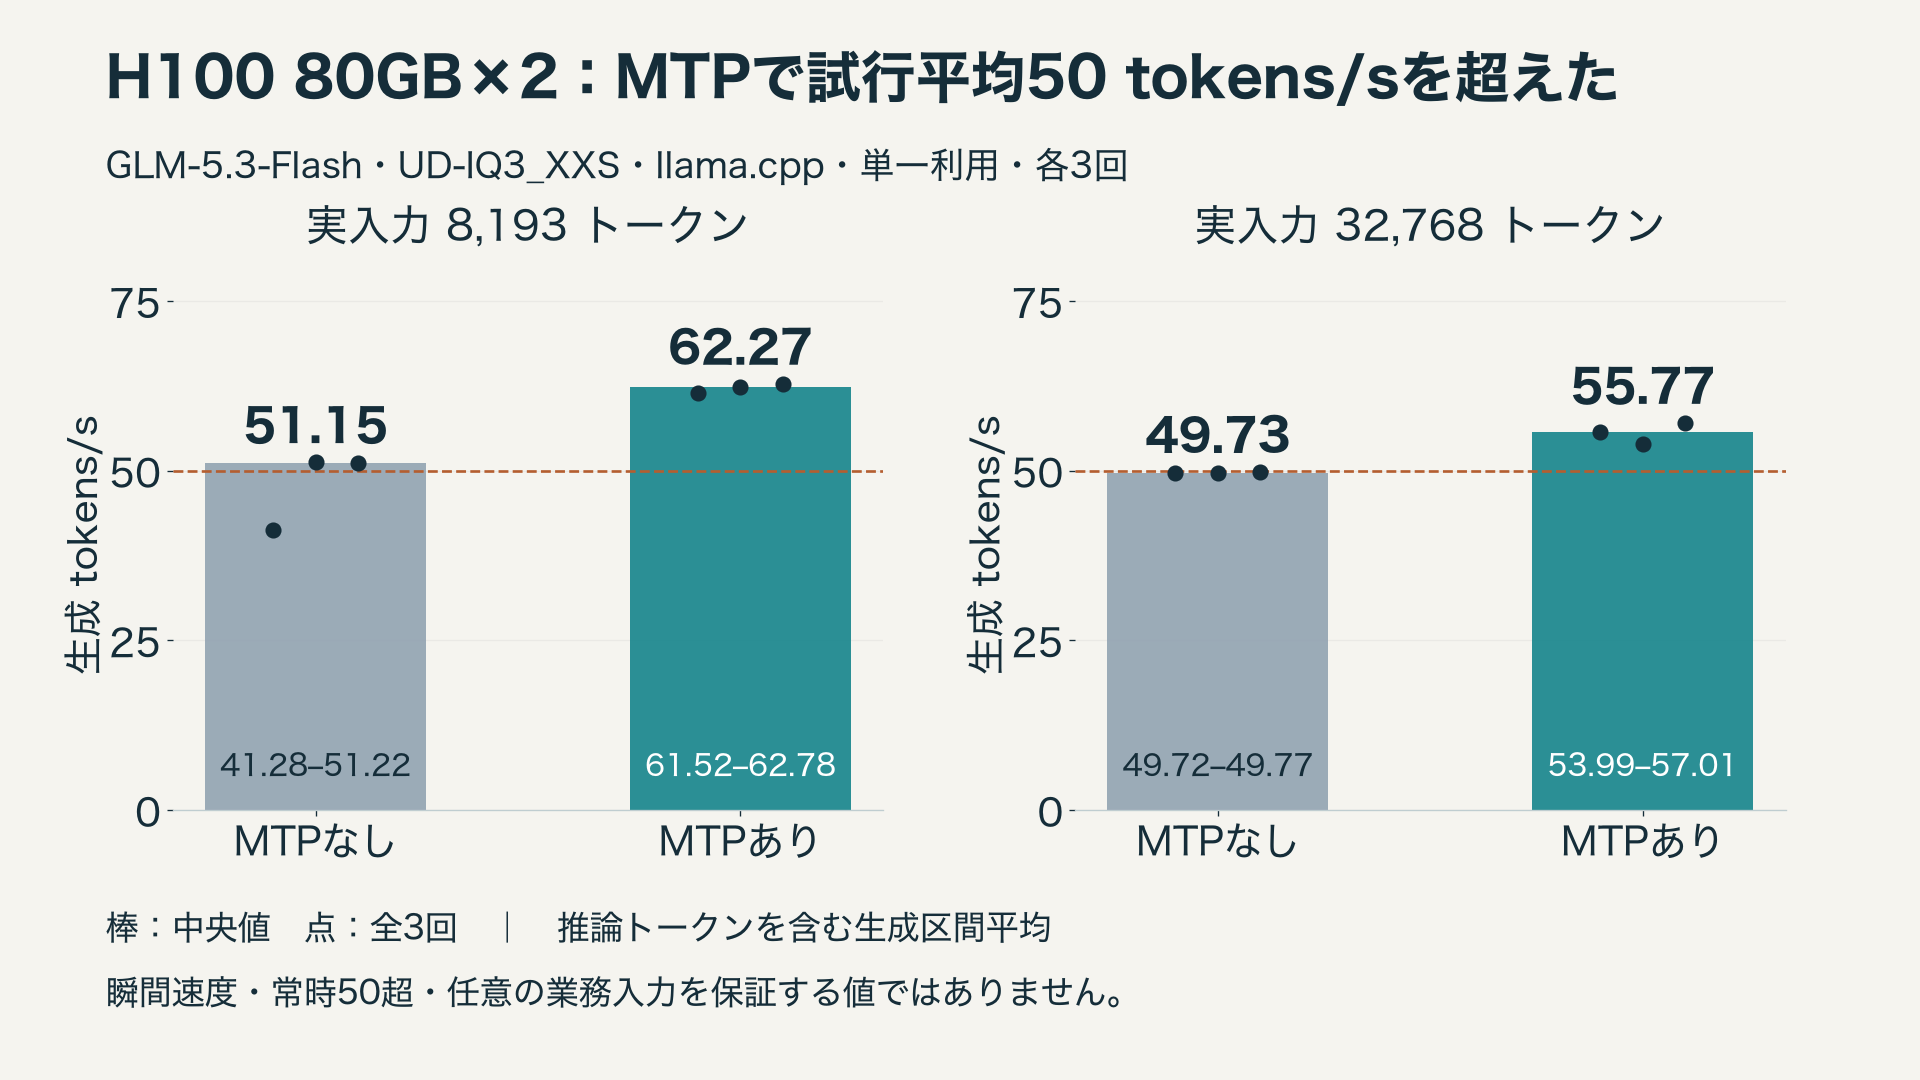
実測では、llama.cppと約3bitのUD-IQ3_XXSを使い、MTP候補3を有効にすると、8K入力・32K入力の各3回、合計6回すべてで試行平均の生成速度が50 tokens/sを超えました。生成速度には推論トークンも含みます。
入力8,193トークン:MTPなし41.28 / 51.22 / 51.15、中央値51.15 tokens/s。MTPあり61.52 / 62.27 / 62.78、中央値62.27 tokens/s。中央値は約21.7%増。
入力32,768トークン:MTPなし49.72 / 49.73 / 49.77、中央値49.73 tokens/s。MTPあり55.77 / 53.99 / 57.01、中央値55.77 tokens/s。中央値は約12.2%増。
生成開始前の入力処理は速くなっていません。最初のストリーム文字(思考を含む)までの中央値は8Kで22.48→24.63秒、32Kで86.55→94.36秒。最初の回答本文までの中央値は8Kで22.48→24.63秒、32Kで87.07→95.76秒でした。モデル読込み時間とは別の指標です。
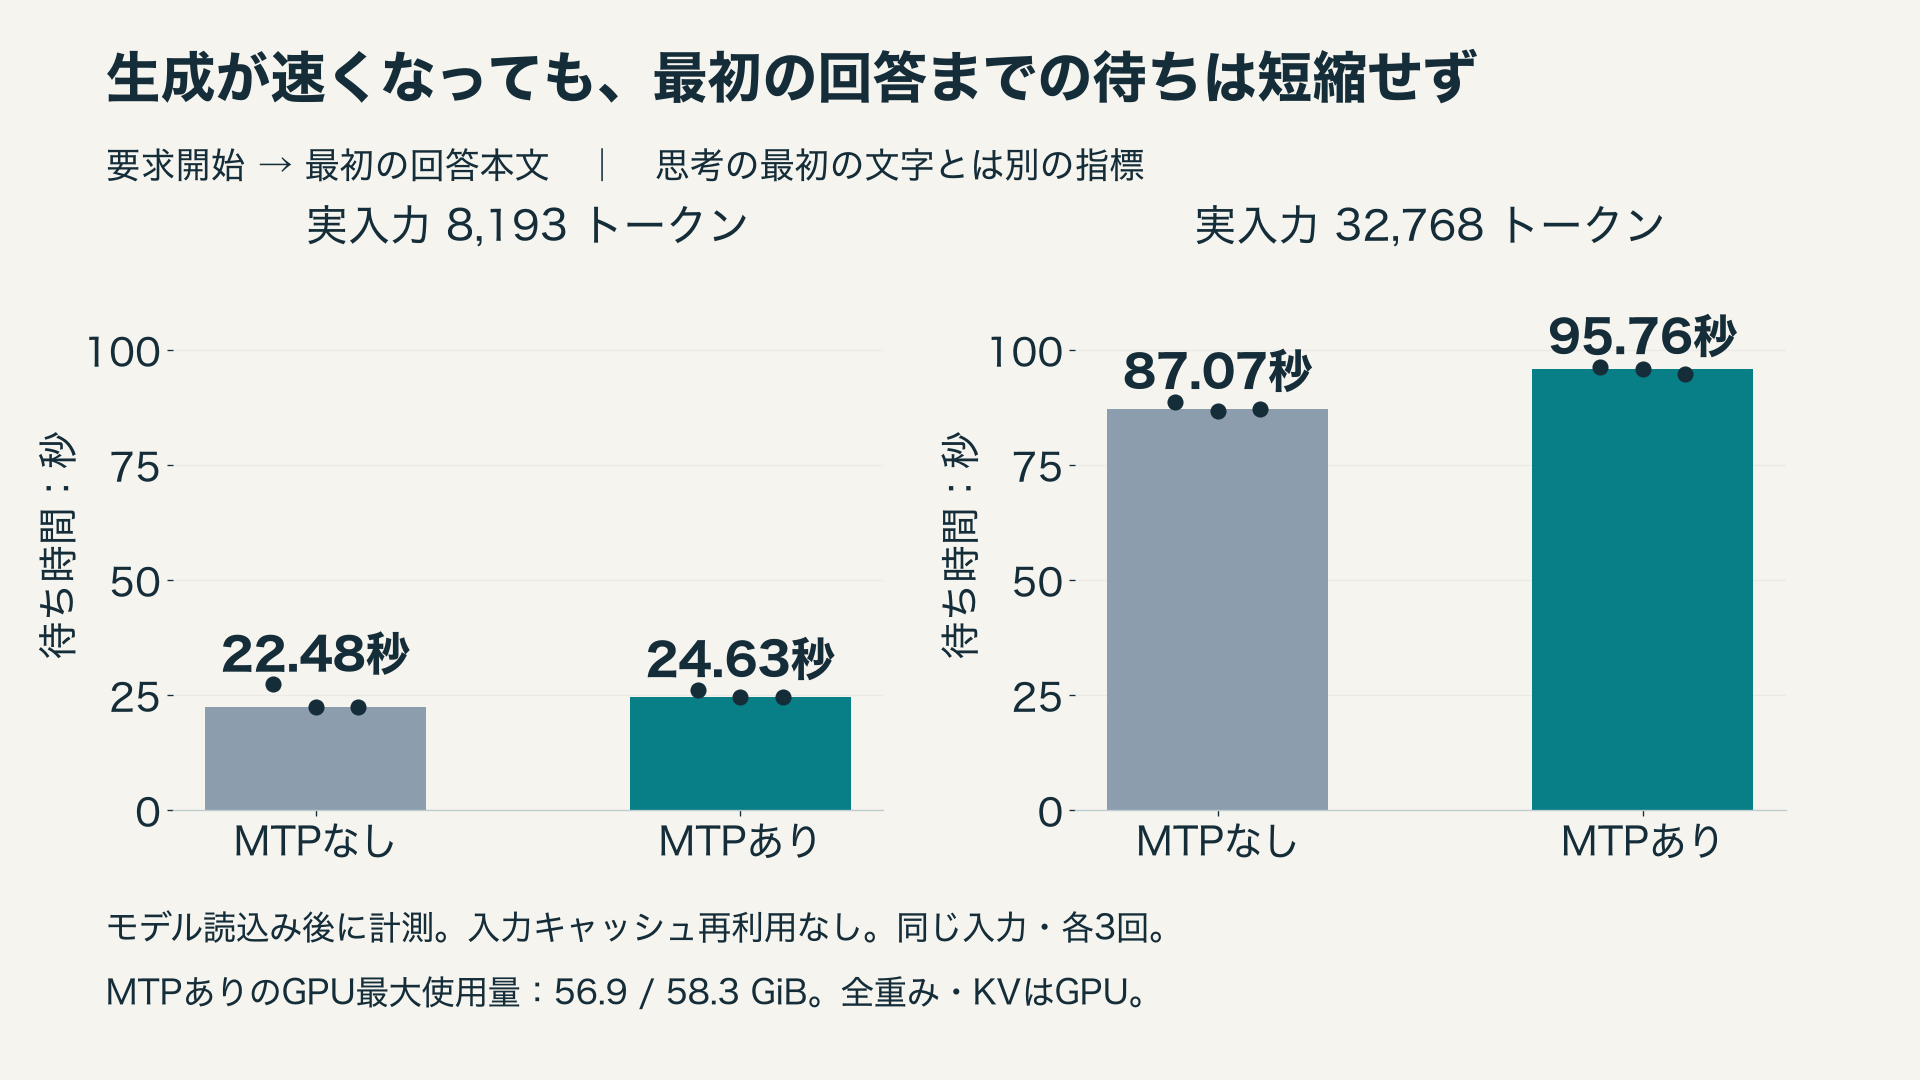
MTPありのGPU最大使用量はGPU0が58,273 MiB、GPU1が59,667 MiBで、各75 GiBの検証上限以内でした。全重みとKVをGPUへ配置し、CPUへの退避なし。同時利用1、コンテキスト容量40,960、生成上限1,024、固定したモデル4シャード・llama.cpp版・入力・サンプリングで比較しています。MTP採用率の中央値は8Kで53.7%、32Kで51.3%でした。
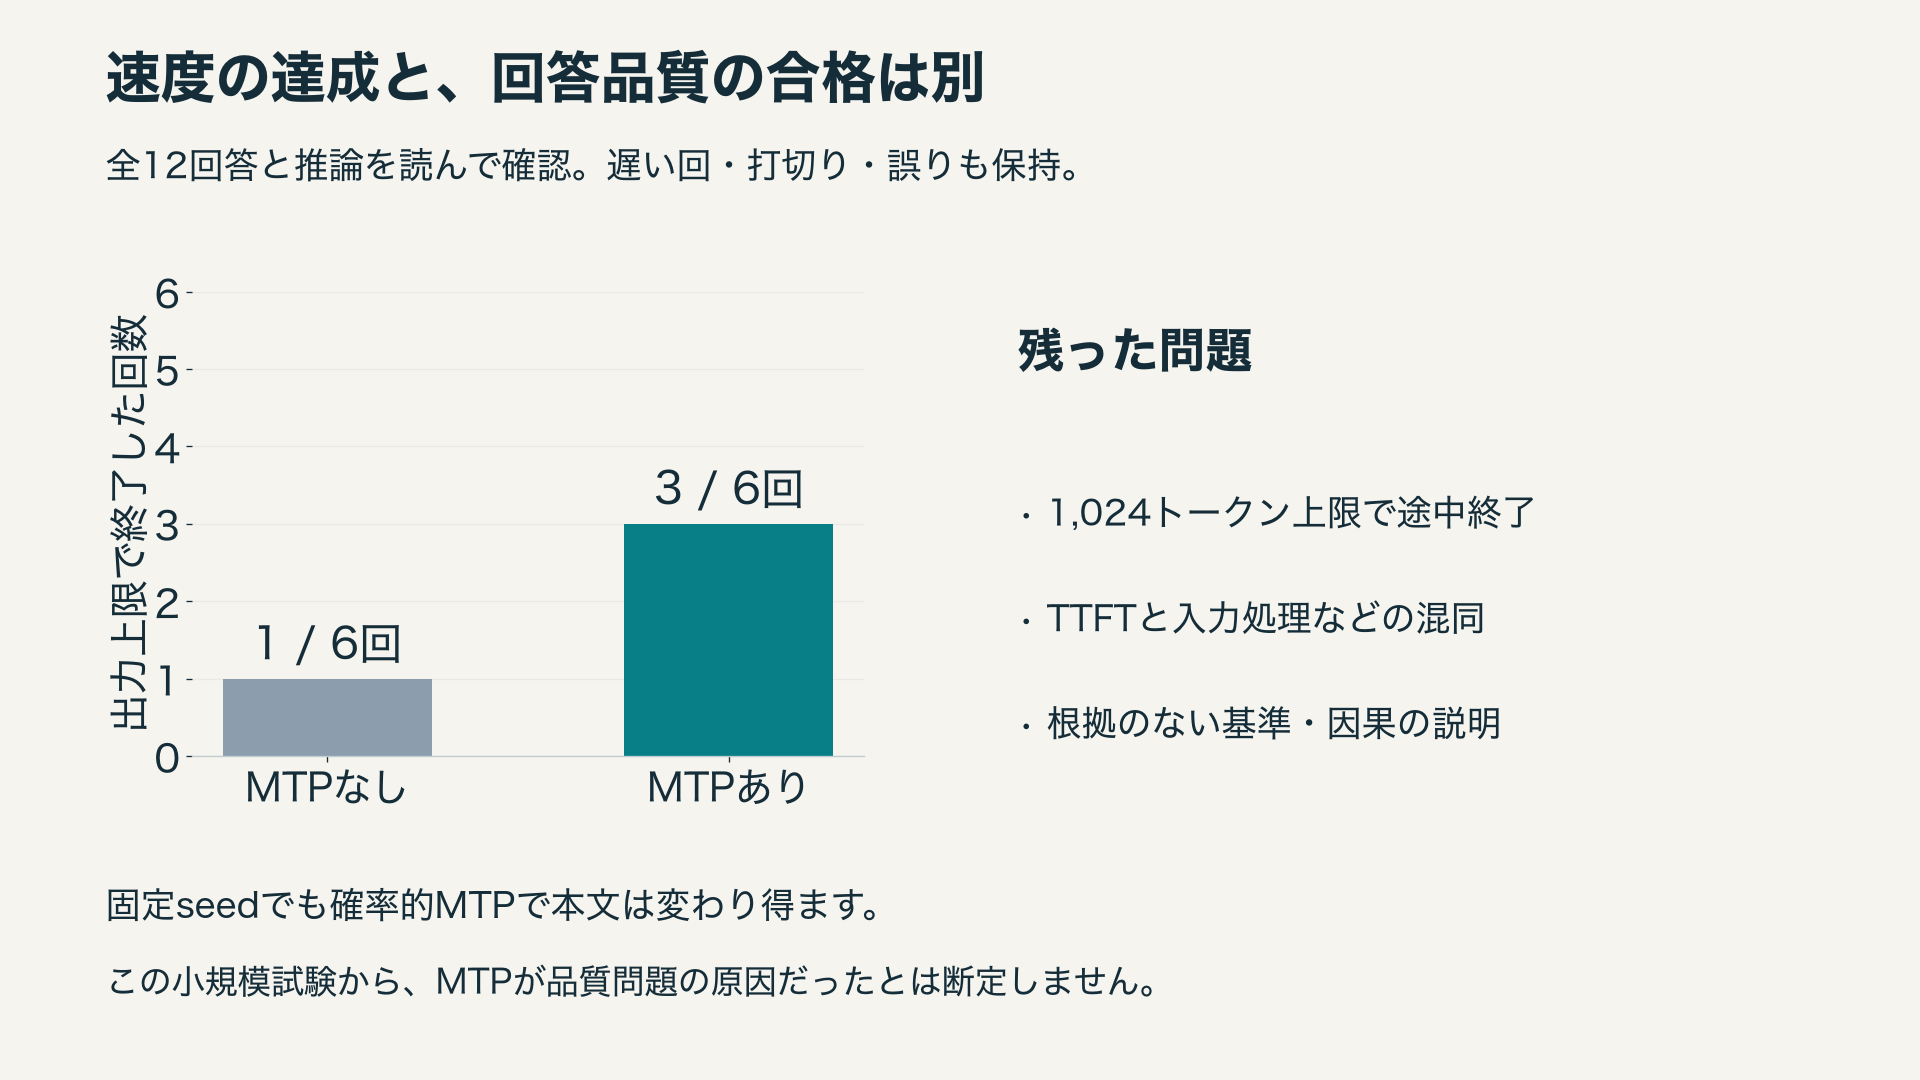
速度の成立と回答品質の合格は別です。MTPなしでは6回中1回、ありでは6回中3回が1,024トークン上限で打ち切られました。全12回答を読み、TTFTと入力処理の混同、根拠のない判定基準や因果推論などの問題を保存しています。MTPは確率的な生成で、固定seedでも出力本文は変わり得ます。MTPが品質問題の原因だったという結論ではありません。
今回の6回で試行平均が50を超えたことは、全瞬間で50以上、任意の業務入力や長時間運用でも50以上という保証ではありません。お客様への提案では、この入力長・モデル・量子化・MTP条件での実測候補として提示し、実業務の回答品質と応答待ち時間を別途確認するのが適切です。RTX PRO 6000の実測値には流用しません。
H100×2でExLlamaV3も追加検証(2026年10月31日)
H100×2のExLlamaV3では、MTPありの中央値は8Kで71.19、32Kで75.12 tokens/sでした。MTPありの全6回で試行平均50 tokens/s超を確認しました。MTPなしも、今回の全6回で50を超えています。前節のllama.cppの結果とは分けて掲載します。いずれも常時速度や任意の業務入力への保証ではありません。
B200と同じGLM-5.3-Flash EXL3 sc_3.10bpw、固定リビジョンb570edf655a2bb00beca23e18d3b98724bfc2db5、ExLlamaV3 1.6.5、PyTorch 2.10.0+cu128を使いました。埋め込みをGPUに置いた同じ実装、テンソル並列2GPU、MTPなし/候補3ありで比較しています。実入力8,193/32,768、コンテキスト40,960、生成上限1,024、同時利用1、各3回です。入力本文・チャットテンプレート・生成設定・seedをB200と照合しました。
起動時の停止と、今回採用した通信設定
最初はモデル読み込み前のGPU間通信で停止しました。6要素の小さなNCCL all-reduceでも通常設定とcuMem無効設定はタイムアウトし、NCCL_P2P_DISABLE=1では2GPU・3サイズ・2データ型すべてで同期後の正解を確認しました。この回避策を今回の両MTP条件に固定しています。停止した試行は削除せず保持し、速度測定本数には含めません。
この設定ではGPU間通信に共有ホストメモリを使います。重みやKVキャッシュをCPUへ退避する設定とは別で、実際の重み・KVがGPU上にあることを確認しました。H100はPCIe・PHB接続、B200はNVLink接続です。通信設定、OS、Pythonのパッチ版なども異なるため、GPU世代だけの差とは解釈しません。停止の根本原因を特定したという主張でもありません。
モデル読み込み後にはTriton用Cコンパイラーの不足も検出し、専用コンテナイメージへ追加しました。ホストOS、ドライバー、既存環境は変更していません。条件の説明はNVIDIA NCCL 2.27.5の公式資料も参照できます。
生成速度と待ち時間
| 実入力tokens | MTP | 生成tokens/s 全3回 | 中央値 | 入力処理 秒 | 最初の生成 秒 | 最初の回答本文 秒 |
|---|---|---|---|---|---|---|
| 8,193 | なし | 52.25 / 52.45 / 52.51 | 52.45 | 3.03 | 3.06 | 3.07 |
| 8,193 | 候補3あり | 62.61 / 71.19 / 75.39 | 71.19 | 3.12 | 3.16 | 3.16 |
| 32,768 | なし | 52.16 / 52.13 / 52.22 | 52.16 | 12.06 | 12.08 | 13.88 |
| 32,768 | 候補3あり | 75.12 / 74.25 / 75.85 | 75.12 | 12.41 | 12.45 | 13.65 |
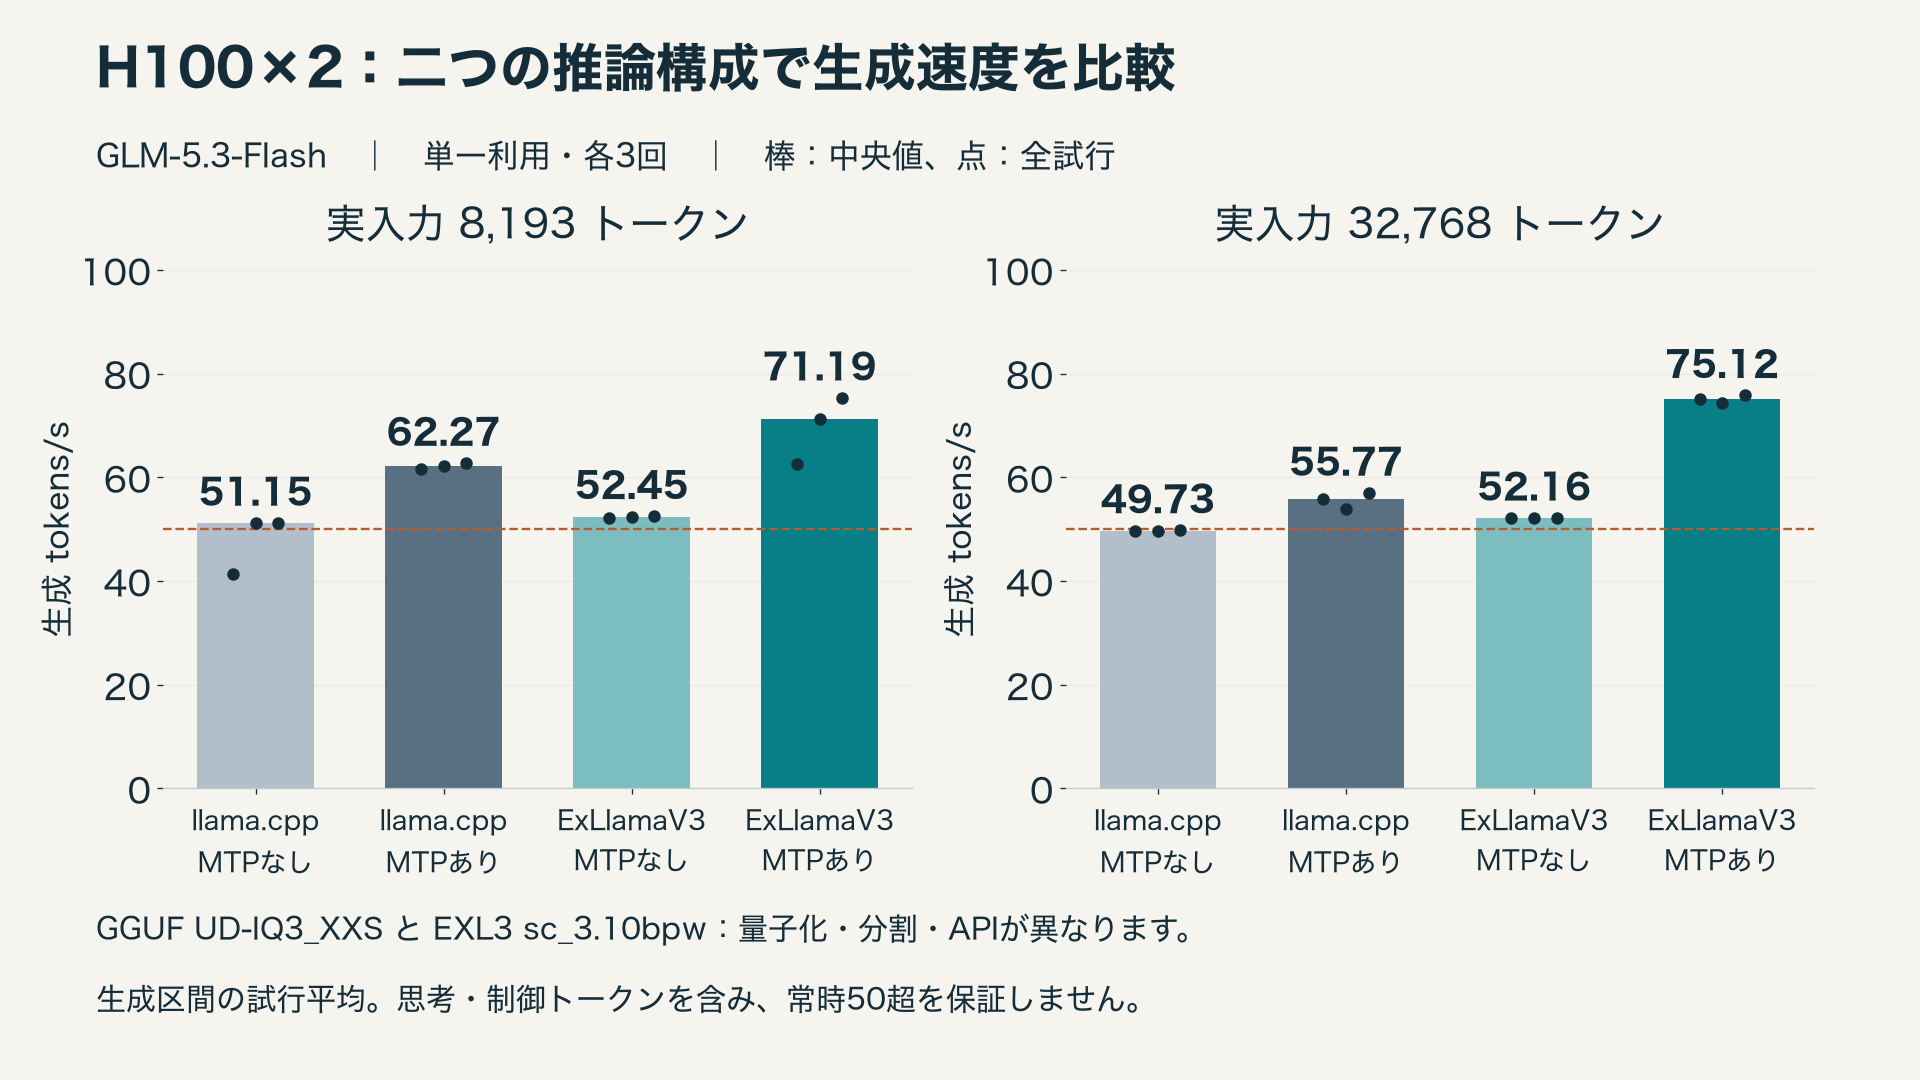
ExLlamaV3内でのMTPあり/なしの中央値比は、8Kが1.36倍、32Kが1.44倍です。生成速度の主指標は最初の1トークンを除く保守的な計算値で、ネイティブ集計値も公開JSONに残しています。思考・制御トークンを含み、表示される日本語文字数毎秒ではありません。
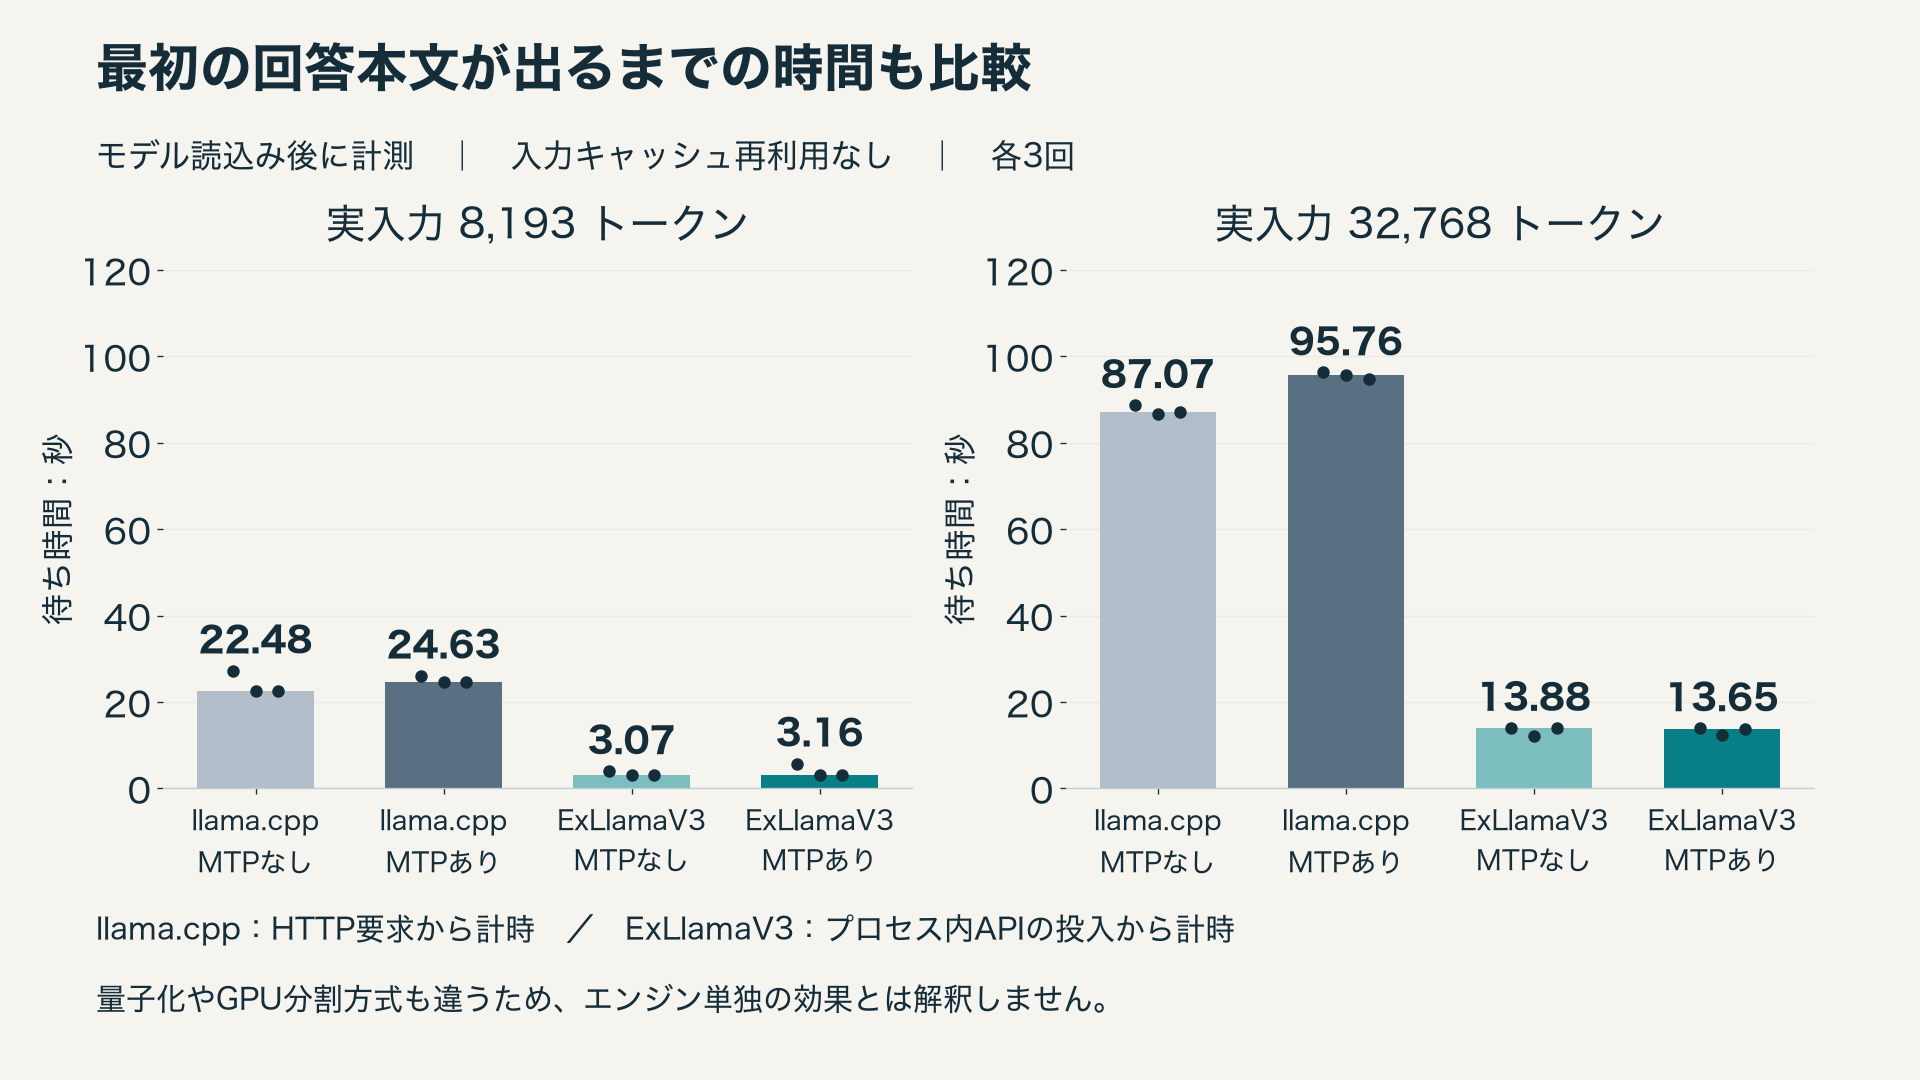
最初の生成、思考を含む最初の表示、思考を除く最初の回答本文を別々に記録しました。モデルは事前に読み込み済みです。ExLlamaV3はプロセス内呼び出し、llama.cppはHTTPストリームであり、量子化形式とGPU分割方法も違う構成比較です。入力処理時間とTTFTも同じ指標ではありません。
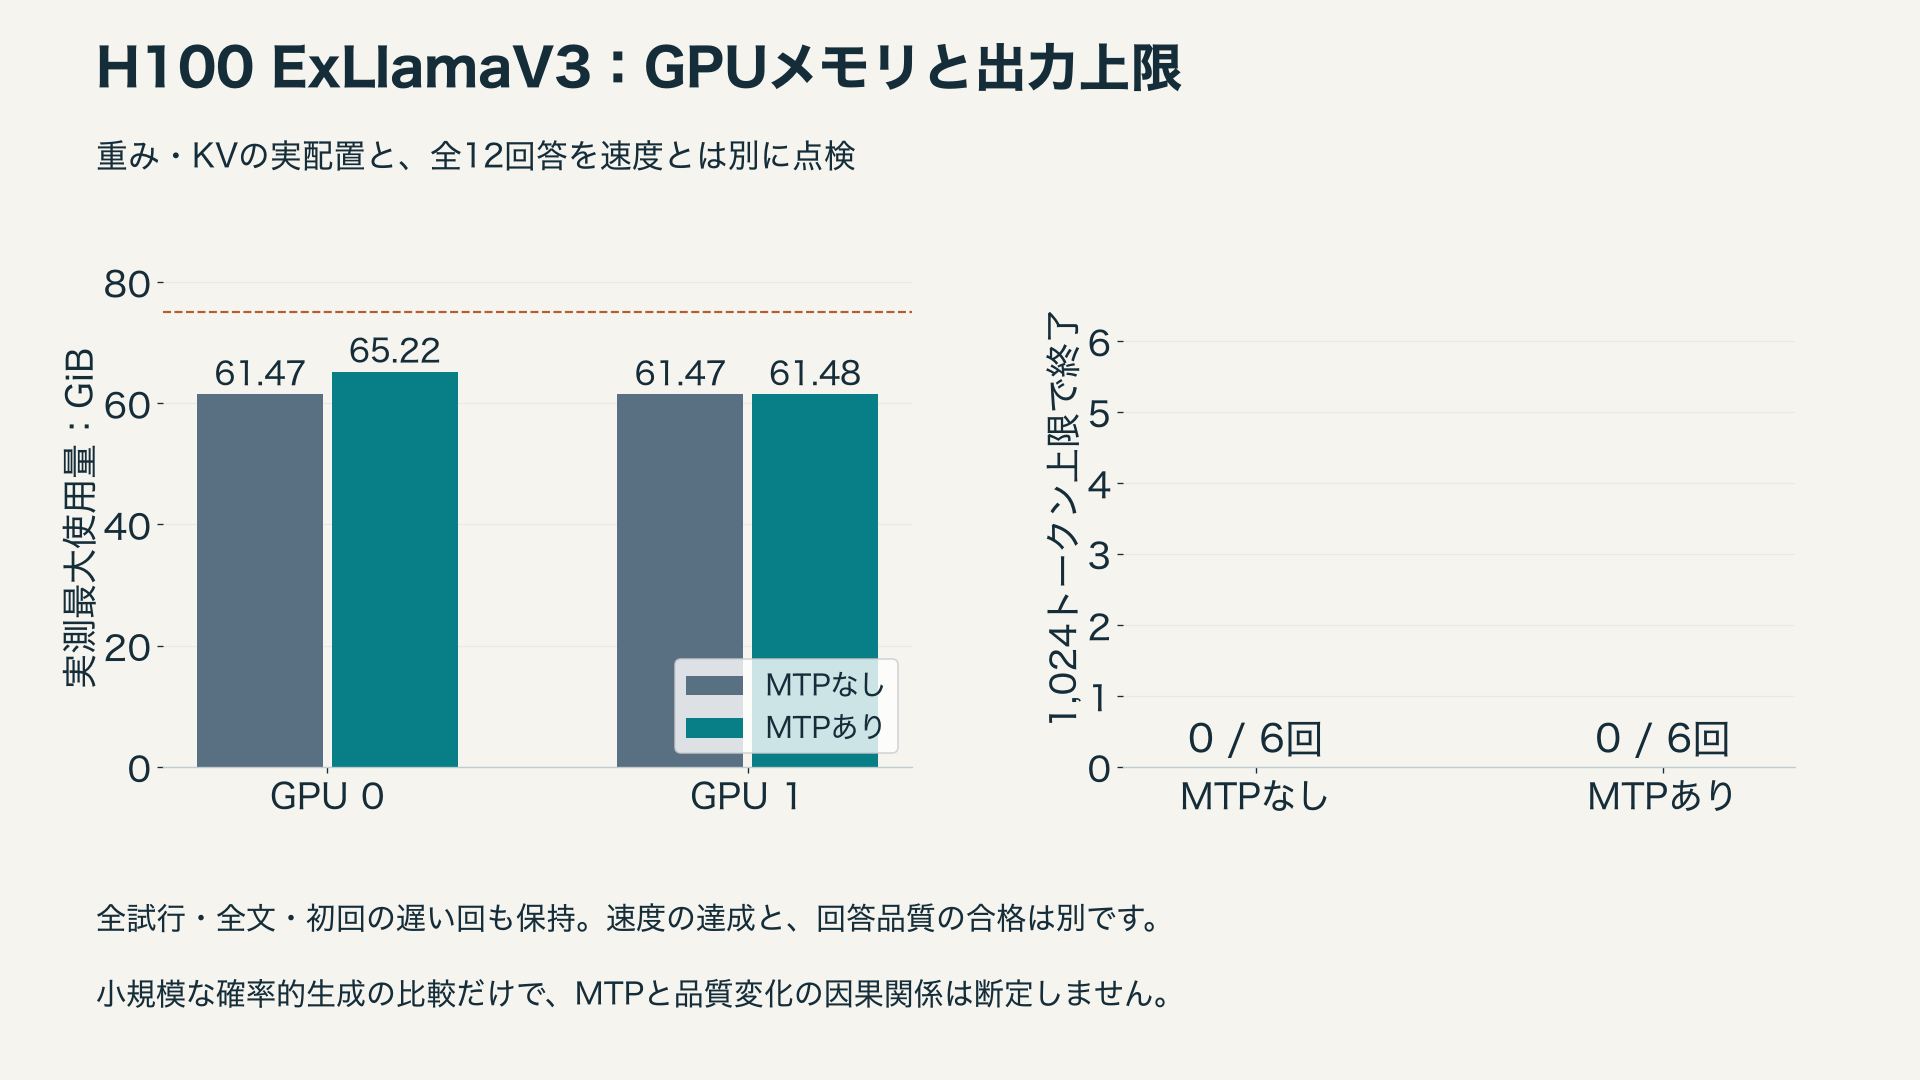
GPU配置・上限終了・回答品質
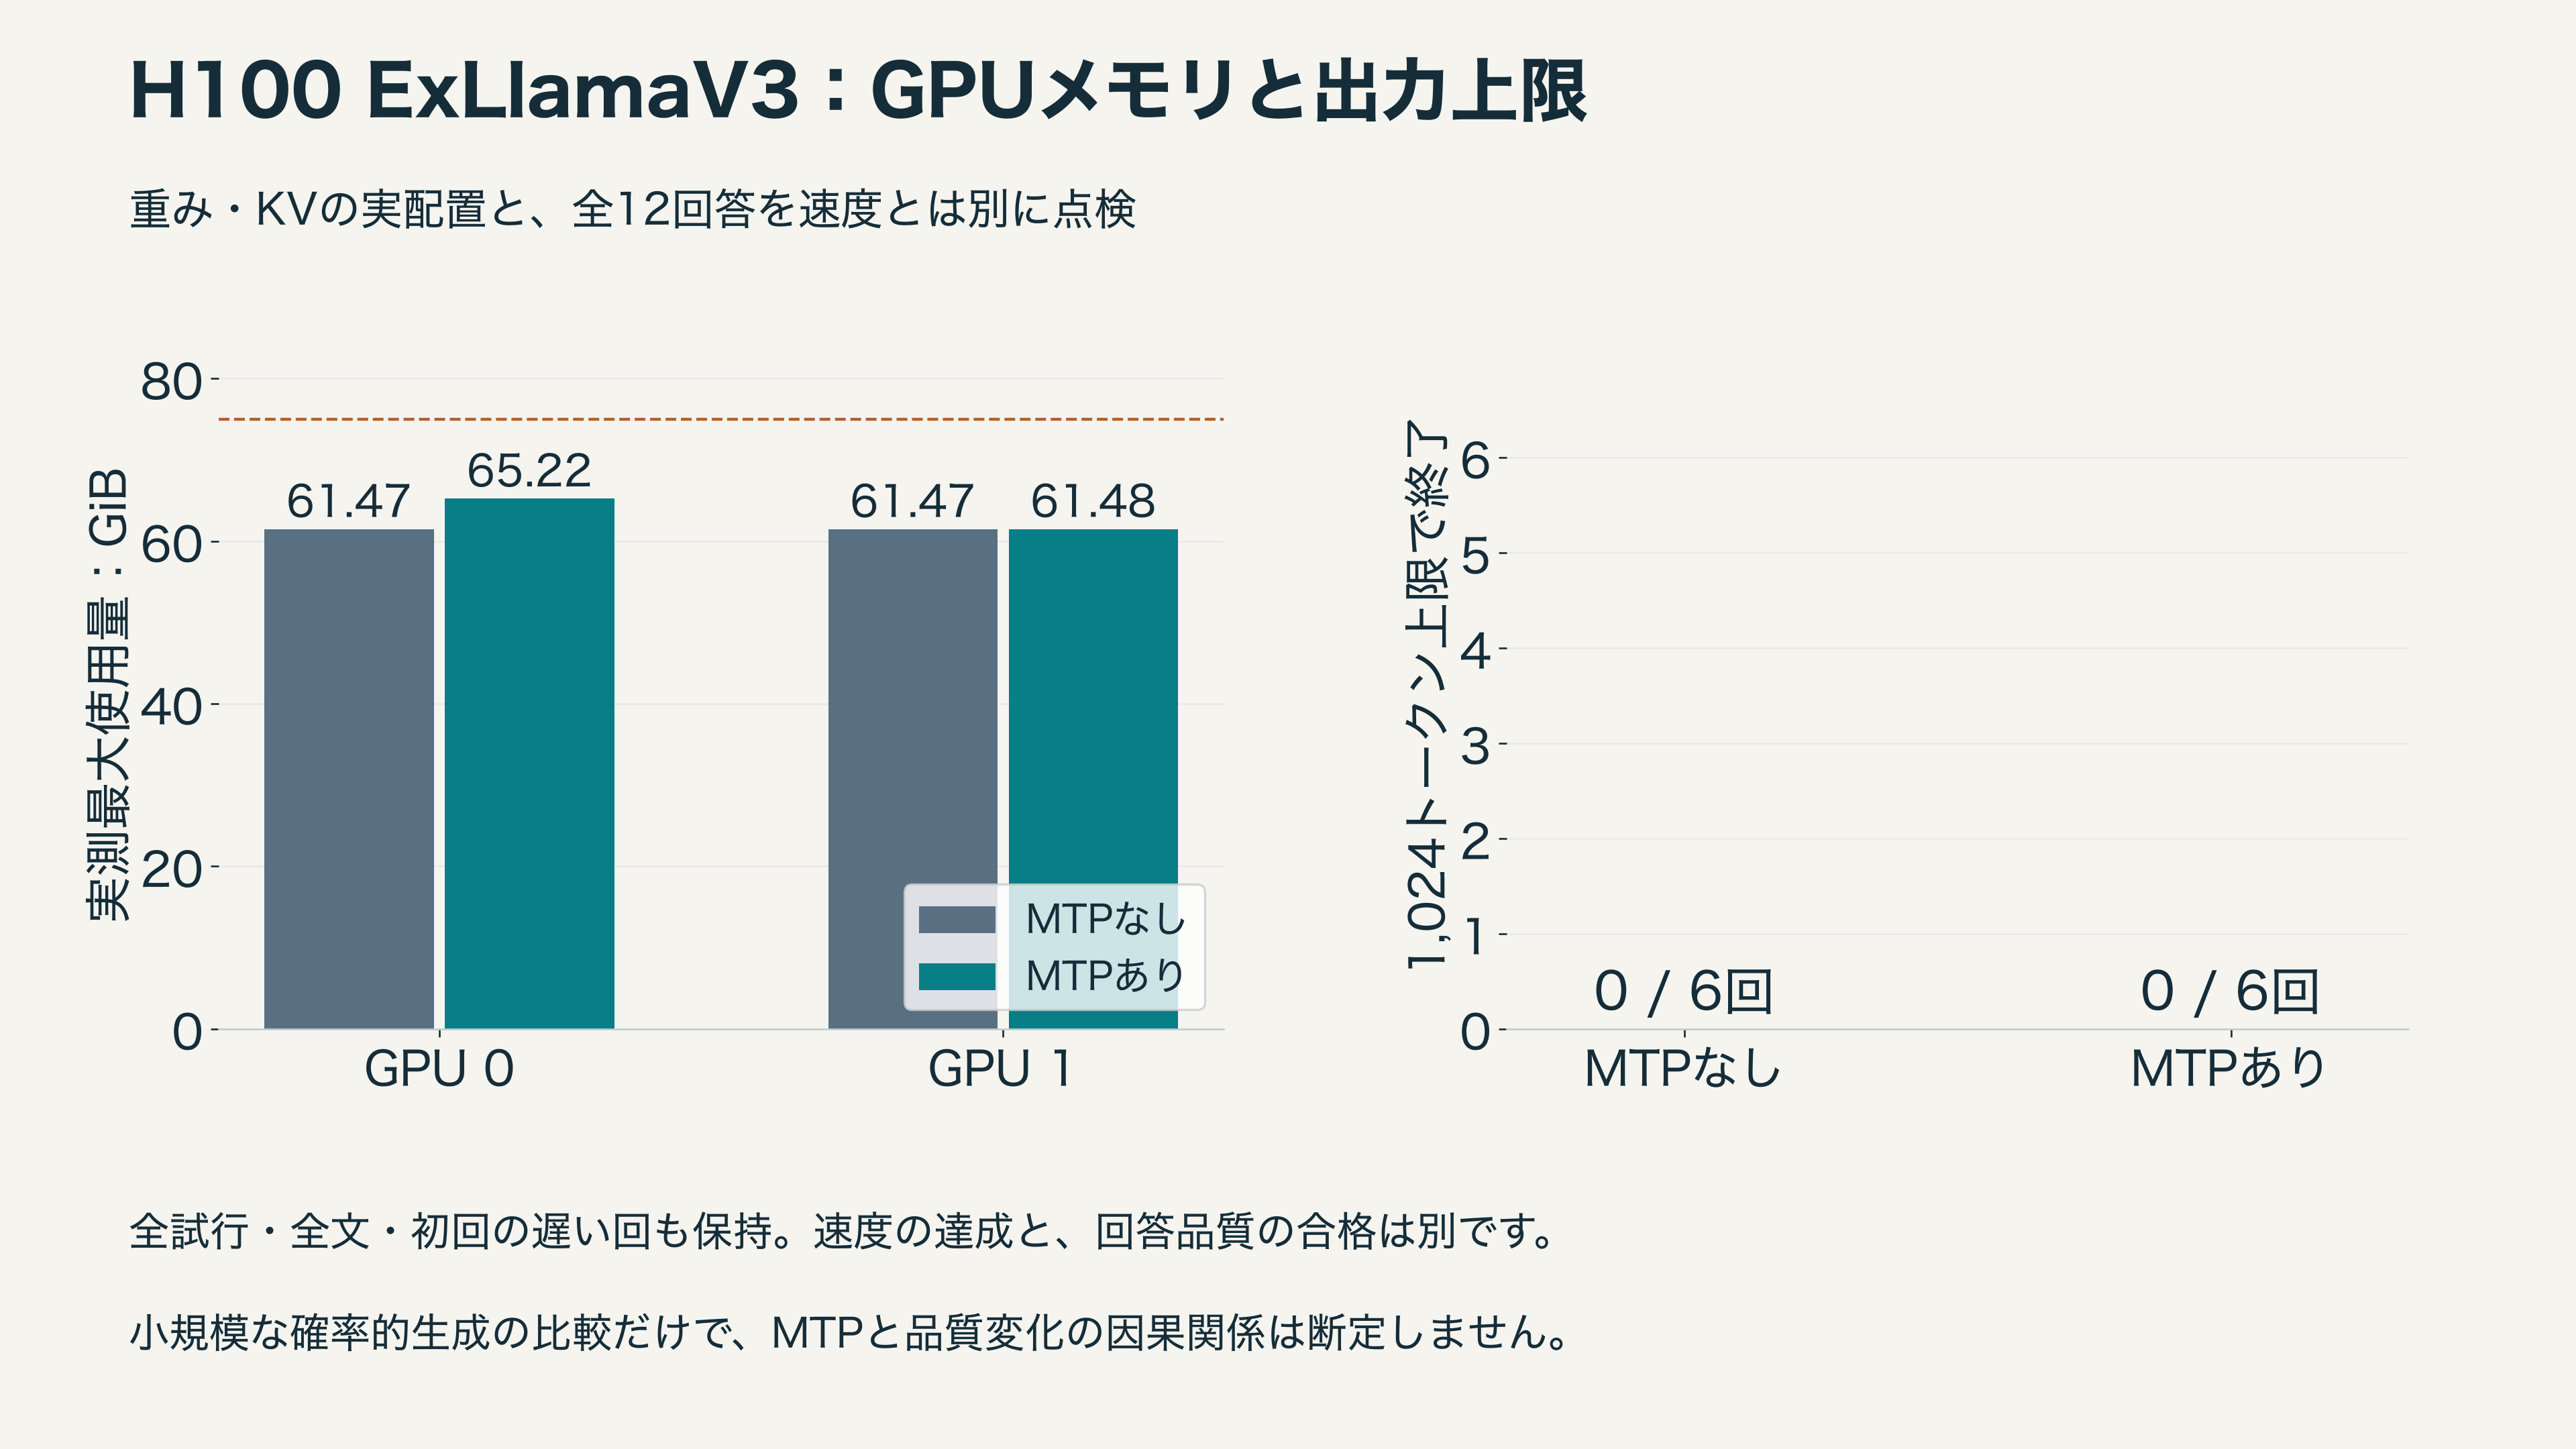
GPU0/GPU1の実測ピークはMTPなし61.47 / 61.47 GiB、あり65.22 / 61.48 GiBでした。各GPU75 GiBの確認上限以内です。全重み・KVはGPU上にあり、CPU上に残る4バイトの整数は量子化形式を示す制御情報です。入力切捨て、コンテキスト縮小、入力キャッシュ再利用はありません。
短問4問ではMTPあり/なしの正答が一致し、候補の実採用も確認しました。本測定で生成上限に達したのはMTPなし0/6回、あり0/6回です。全12回答に、入力記録の数値誤り、TTFTと入力処理時間の混同、根拠の不足する判定などの要確認点がありました。MTPありの1回答にはtokens/sの計算式を逆数にする誤りもあります。日本語の手順を出力できても、そのまま業務手順として採用できる品質の合格とはしていません。 速度測定の成立を回答品質の合格とは扱いません。全12回答の点検はCodexによるもので、人間による全文確認・試聴の完了とは扱っていません。
最初の遅い試行も保持しました。MTPなし/ありは順番に測定したブロックで、ランダム化比較ではありません。固定seedでも投機的サンプリングによって回答本文や長さは変わり得ます。同一出力長の所要時間比較、MTPによる品質の因果関係、RTX PRO 6000の性能保証には使いません。
H100 ExLlamaV3の全12試行・比較・品質所見(JSON)
従来の試験:MTPの回答品質と256K・1Mバッファ
以下は出力上限1,024で実施した600問の主試験・資料課題・速度確認の記録です。資料課題の出力上限を増やした最新結果は上に分けて掲載しています。
1Mバッファの確保と4K・32K入力での動作を確認しました。客観採点はMTPなし1664/1,800、あり1664/1,800。この固定問題集では、正答率差の片側95%信頼下限が−2ポイントを超え、事前に定めた非劣性の判定基準を満たしました。 MTPありだけ不正解となる回答もあり、個々の回答が常に同品質という意味ではありません。これは一般的な回答品質の同等性や、どの入力でも品質が落ちないことの証明ではありません。
別枠の4K・32K資料課題24問では、6項目すべて正答したのはMTPなし11問、あり11問でした。MTP間の差と、回答自体の実務上の正確さは分けて確認する必要があります。 内訳は4Kが両条件11/12問、32Kが両条件0/12問。32Kは1,024出力トークンでの打切りが大半を占め、実務品質の確認には至っていません。
40,960から、262,144と1,048,576へ
前回は40,960トークンのバッファでした。今回は同じGLM-5.3-Flash EXL3 sc_3.10bpwとExLlamaV3 1.6.5-gpuembed1(埋め込みをGPUへ配置する既存パッチ)を使い、確保容量を262,144と1,048,576に変更しました。モデル設定の最大長も1,048,576です。両GPUの重み・KVキャッシュがGPU上にあることを実配置から確認し、CPUへの重み・KV退避は使っていません。GPU間通信は前回と同じNCCL_P2P_DISABLE=1の設定で、ホストメモリを経由します。通信の経路と、重み・KVの保存場所は別の話です。
初回の1M試験は、GPU0が75GiBの確認上限を超えたため停止しました。OOMではありません。MTPの補助モデルをGPU0に置く分を考慮して配置を調整し、同じ75GiB上限のまま通過しました。初期停止と計測コードの修正前試行も保存し、成功例だけを残してはいません。
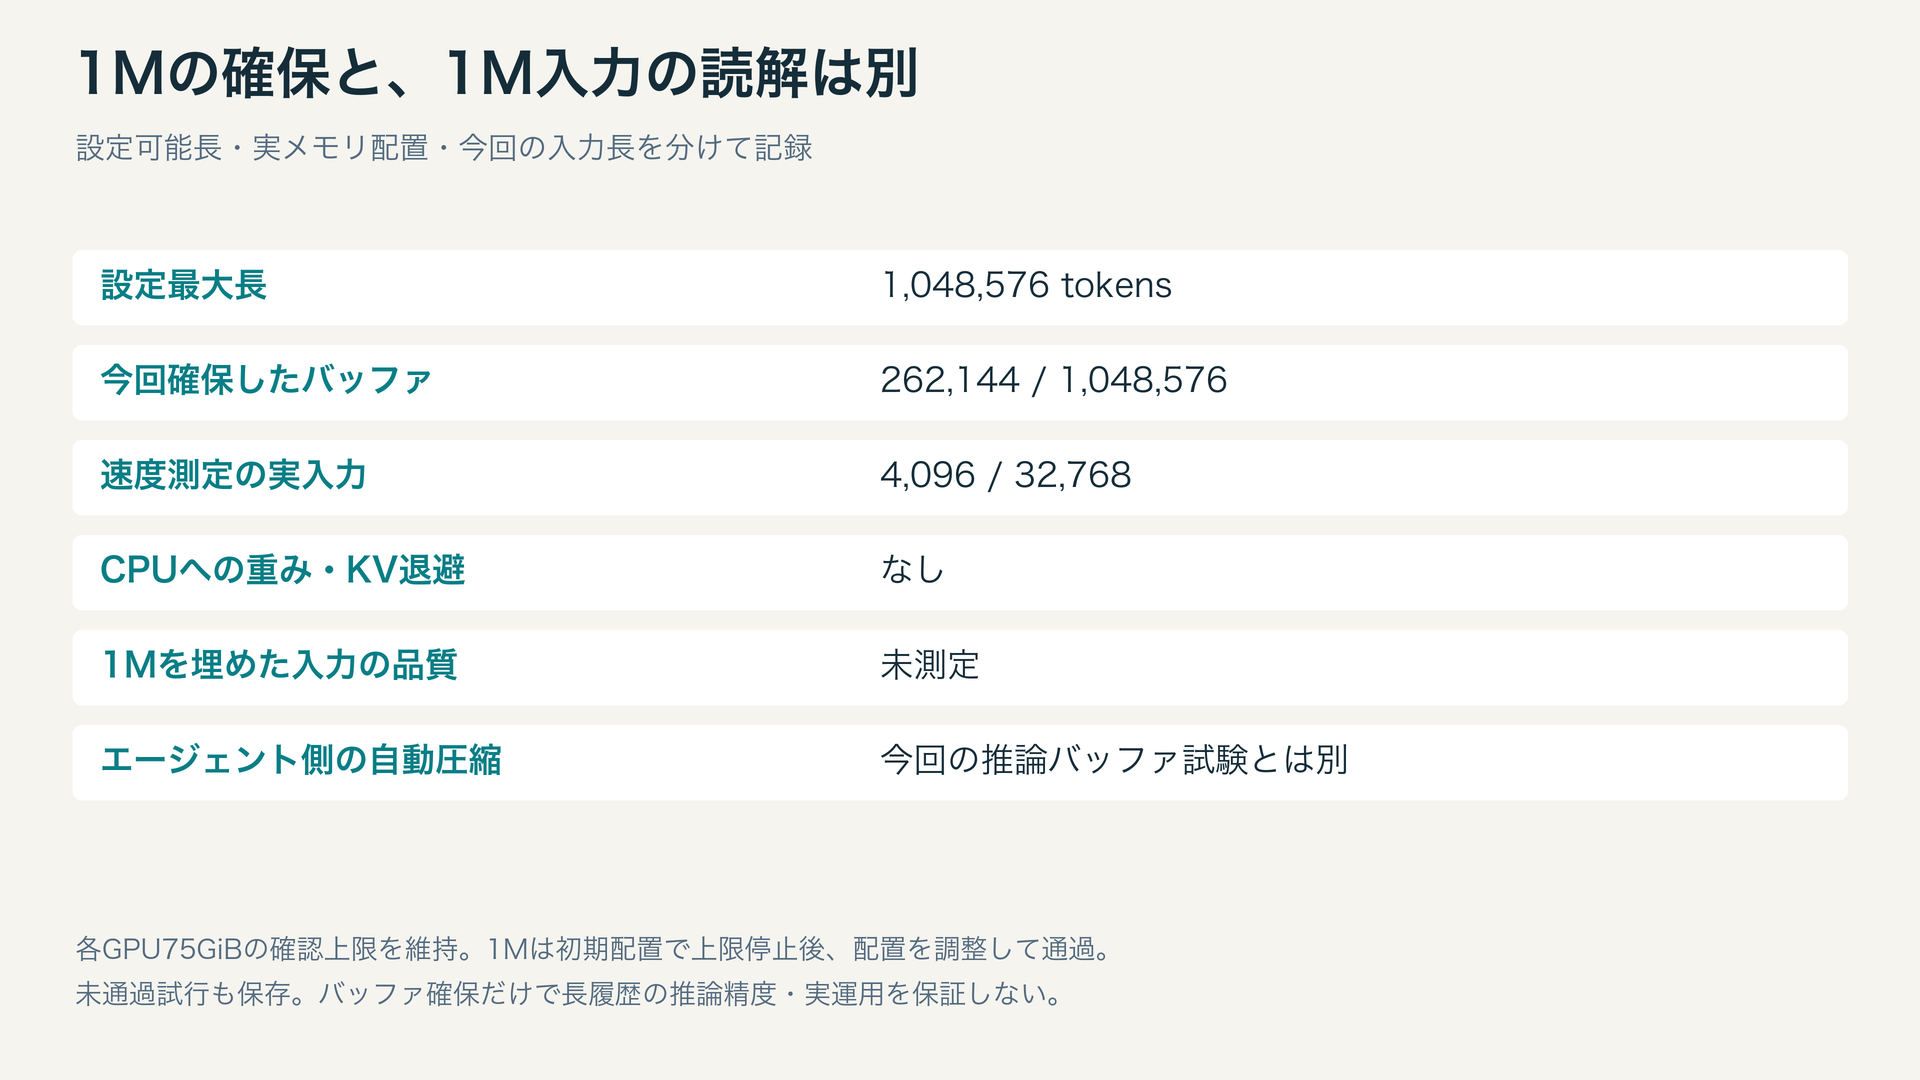
実入力はご要望どおり4Kと32Kです。250K・1Mまで履歴を埋めた場合の長文読解や、ツールを何度も使うエージェントの長時間動作は未検証です。クライアントやエージェントが持つコンテキスト上限、自動圧縮の発動基準、出力分の予約枠も別設定です。今回の結果だけで「圧縮が起きない」とは言えません。
回答が出始めるまでと、生成速度
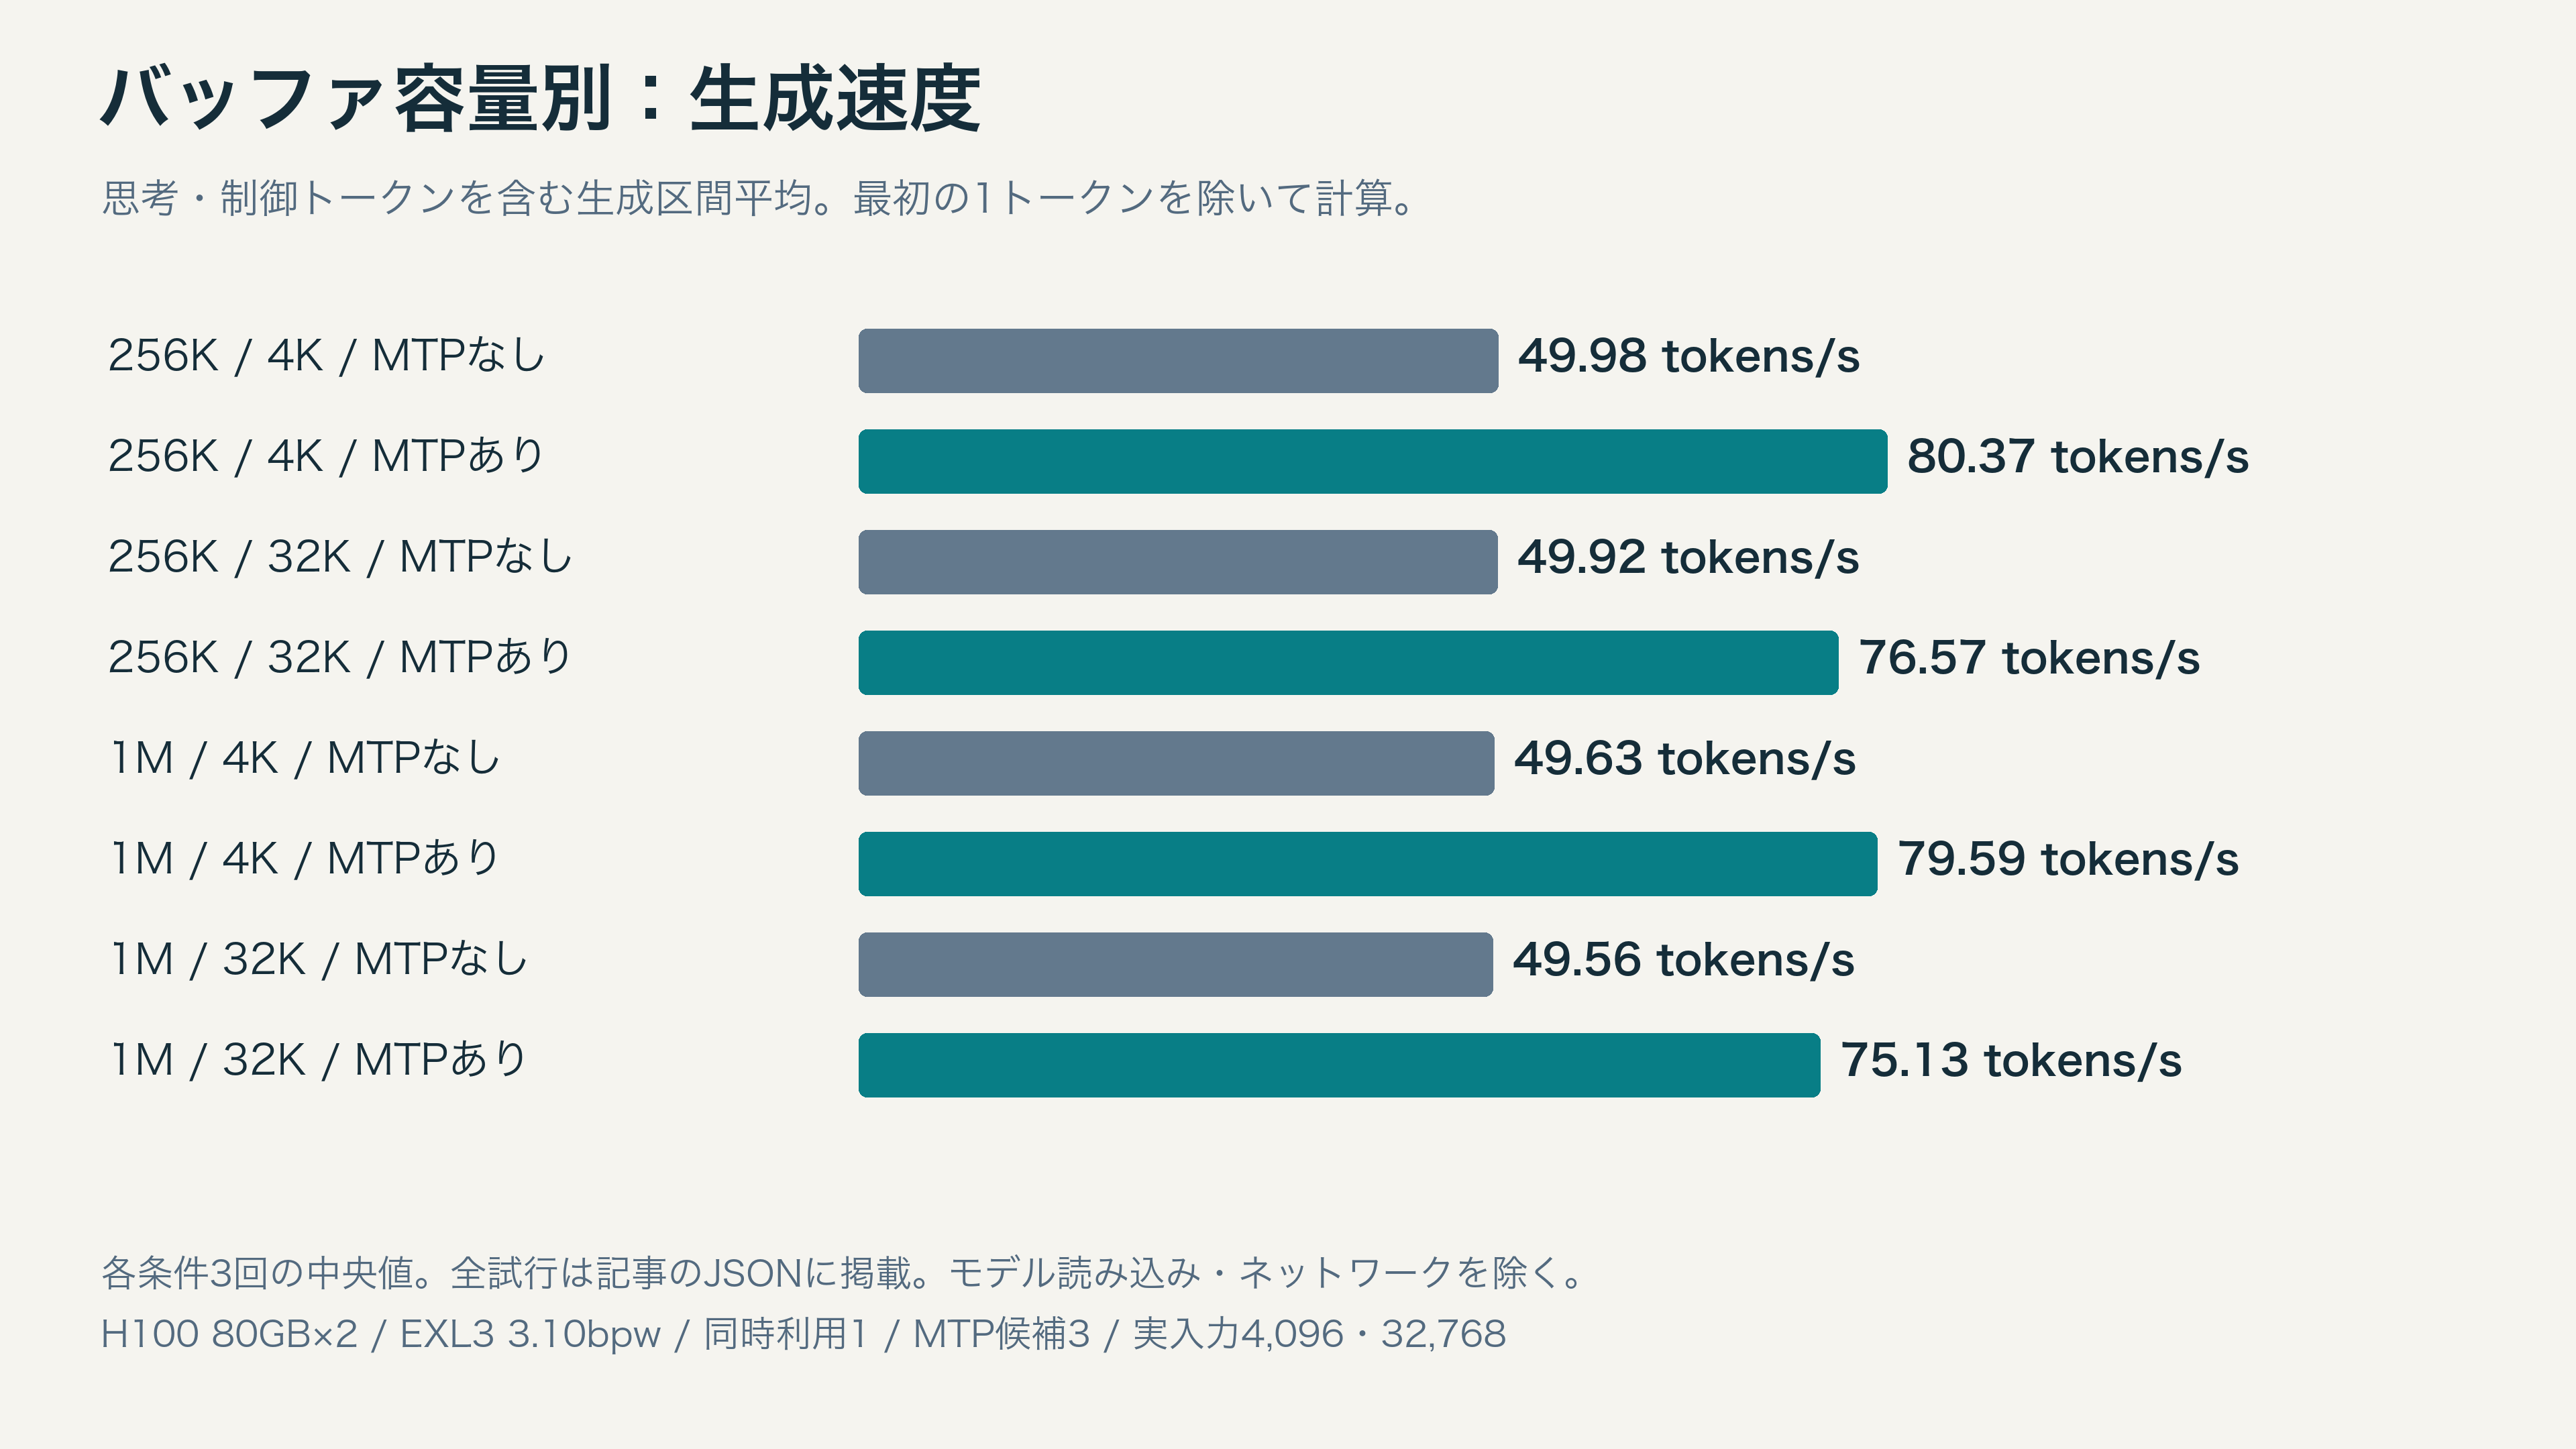
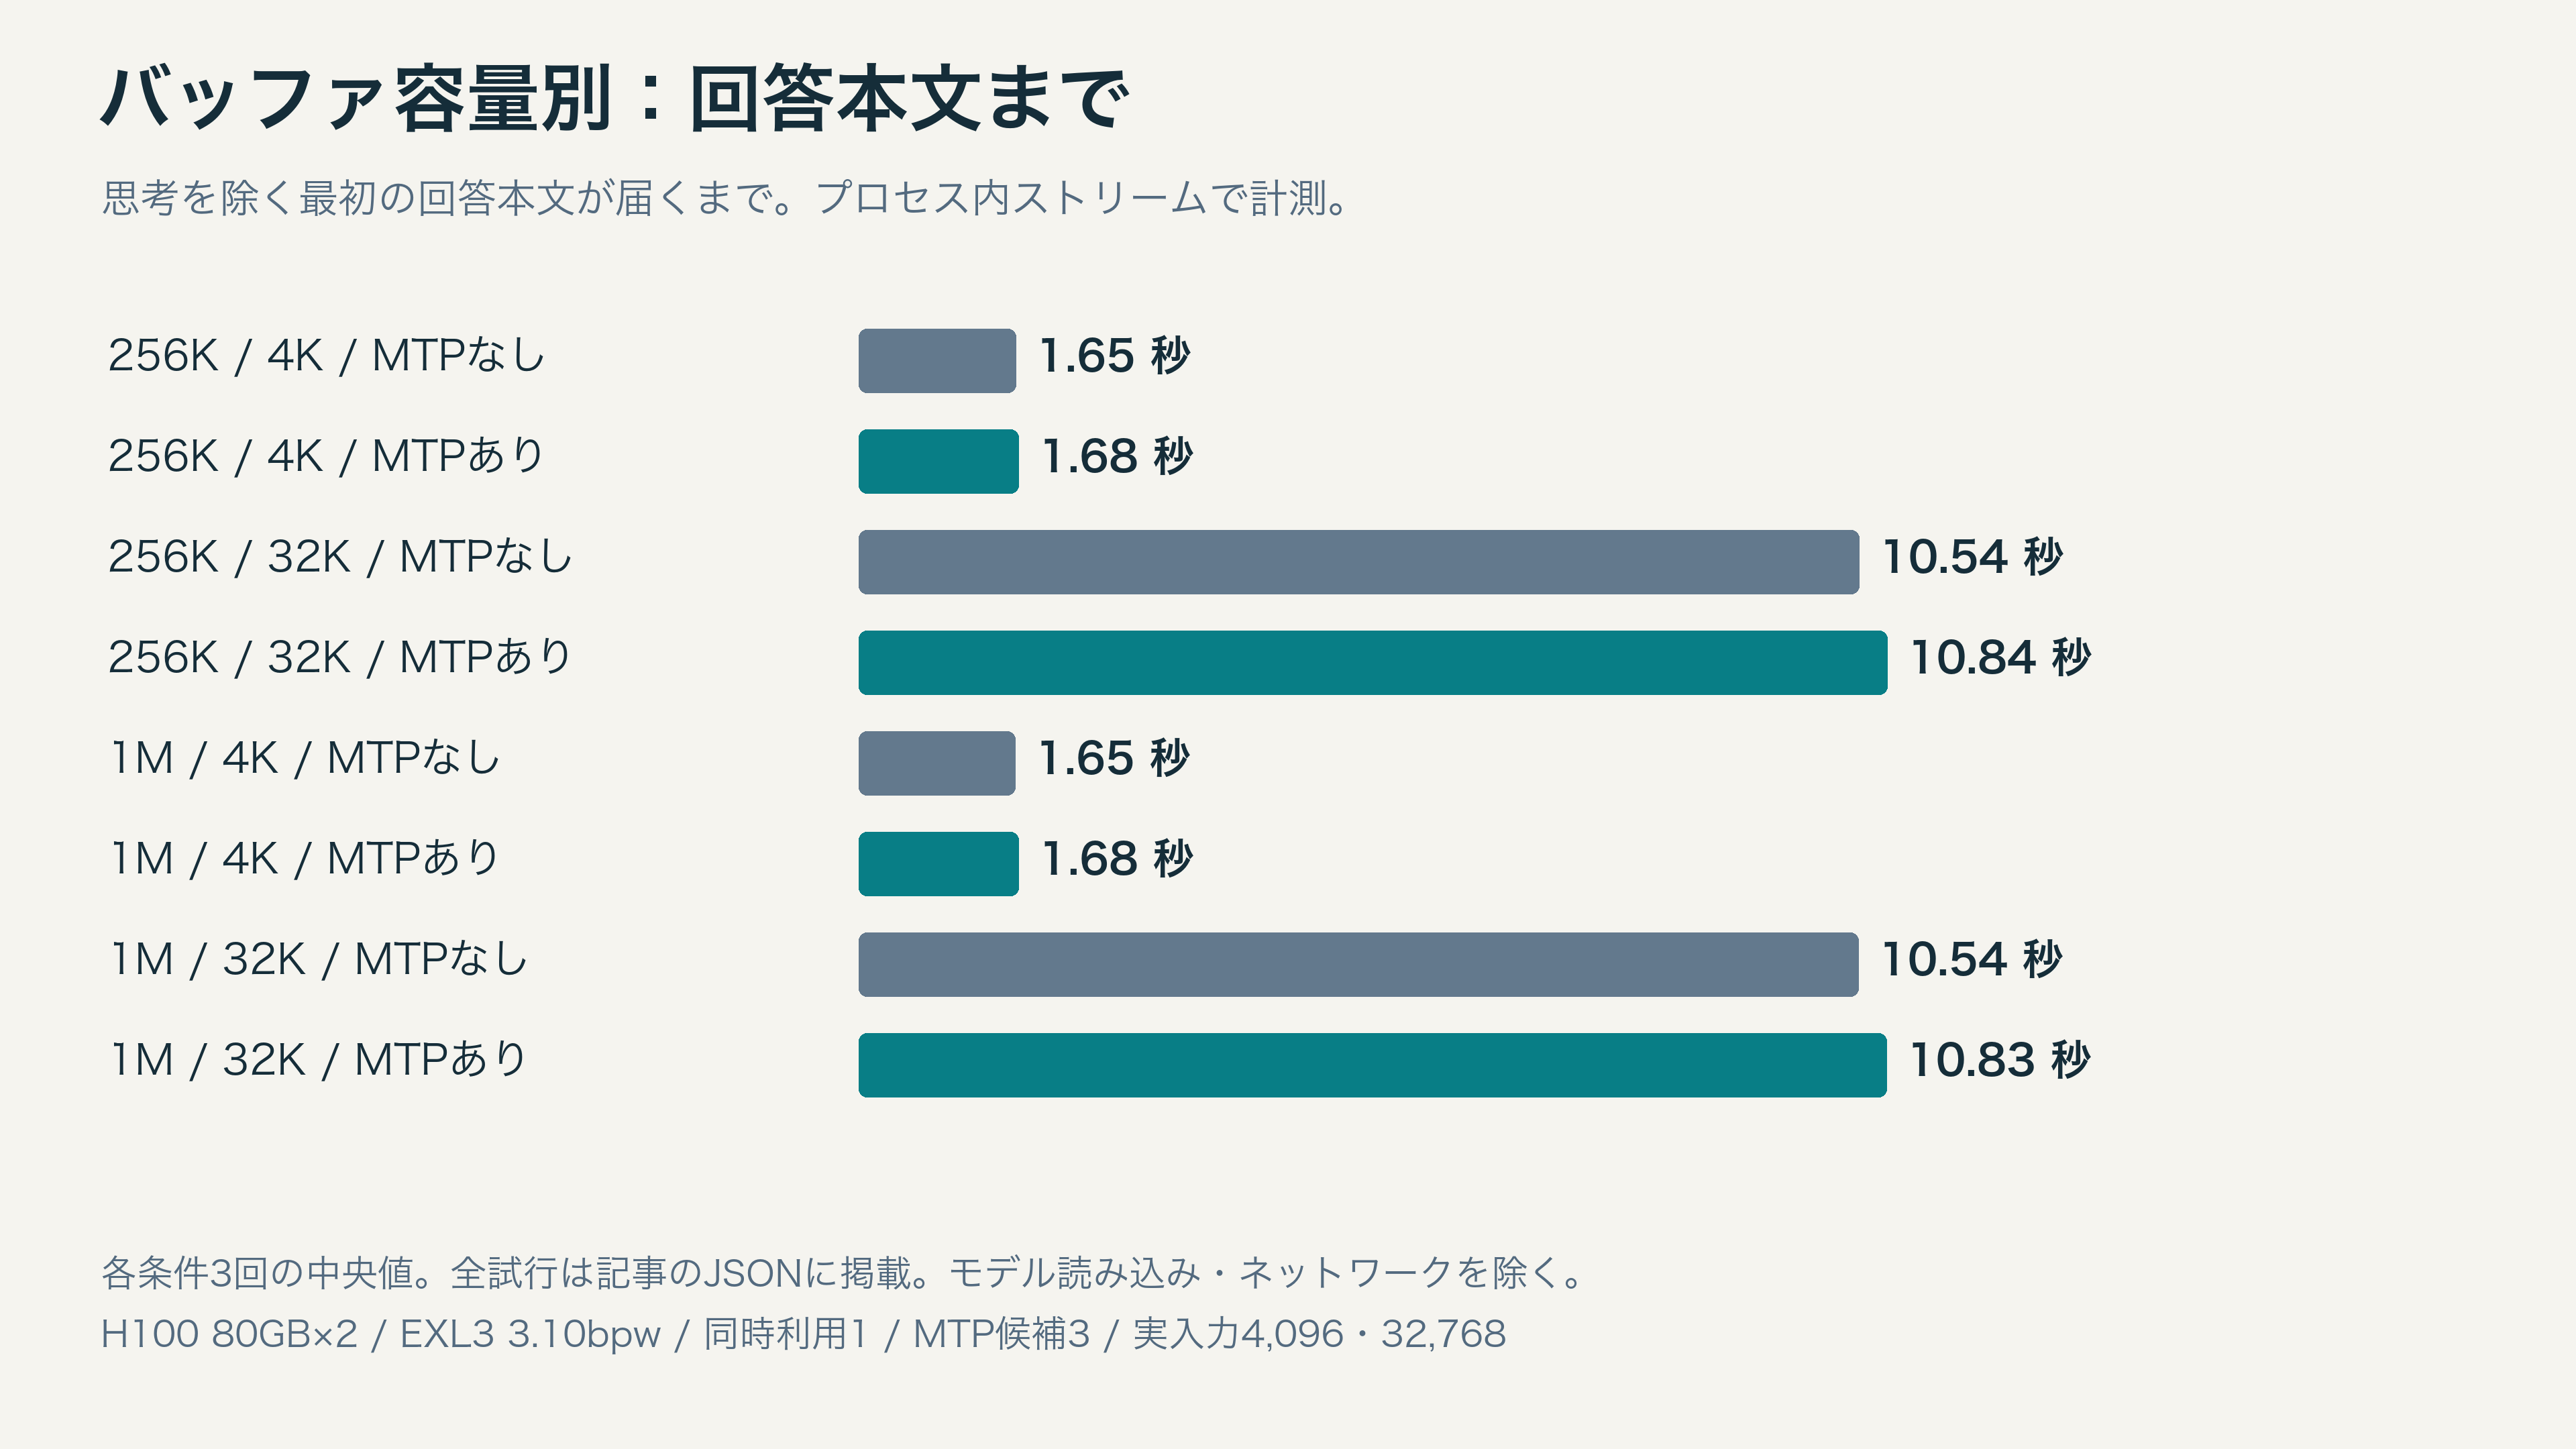
| 確保容量 | 実入力tokens | MTP | 最初の生成 秒 | 回答本文まで 秒 | 生成tokens/s 中央値 | 全3回tokens/s | 上限終了 |
|---|---|---|---|---|---|---|---|
| 256K | 4,096 | なし | 1.63 | 1.65 | 49.98 | 50.09 / 49.98 / 49.94 | 1/3 |
| 256K | 4,096 | あり | 1.68 | 1.68 | 80.37 | 80.37 / 73.74 / 80.76 | 0/3 |
| 256K | 32,768 | なし | 10.52 | 10.54 | 49.92 | 50.01 / 49.92 / 49.88 | 1/3 |
| 256K | 32,768 | あり | 10.84 | 10.84 | 76.57 | 74.06 / 83.64 / 76.57 | 0/3 |
| 1M | 4,096 | なし | 1.63 | 1.65 | 49.63 | 49.64 / 49.63 / 49.63 | 0/3 |
| 1M | 4,096 | あり | 1.68 | 1.68 | 79.59 | 82.48 / 79.59 / 78.34 | 0/3 |
| 1M | 32,768 | なし | 10.51 | 10.54 | 49.56 | 49.56 / 48.69 / 49.61 | 0/3 |
| 1M | 32,768 | あり | 10.83 | 10.83 | 75.13 | 74.83 / 77.12 / 75.13 | 0/3 |
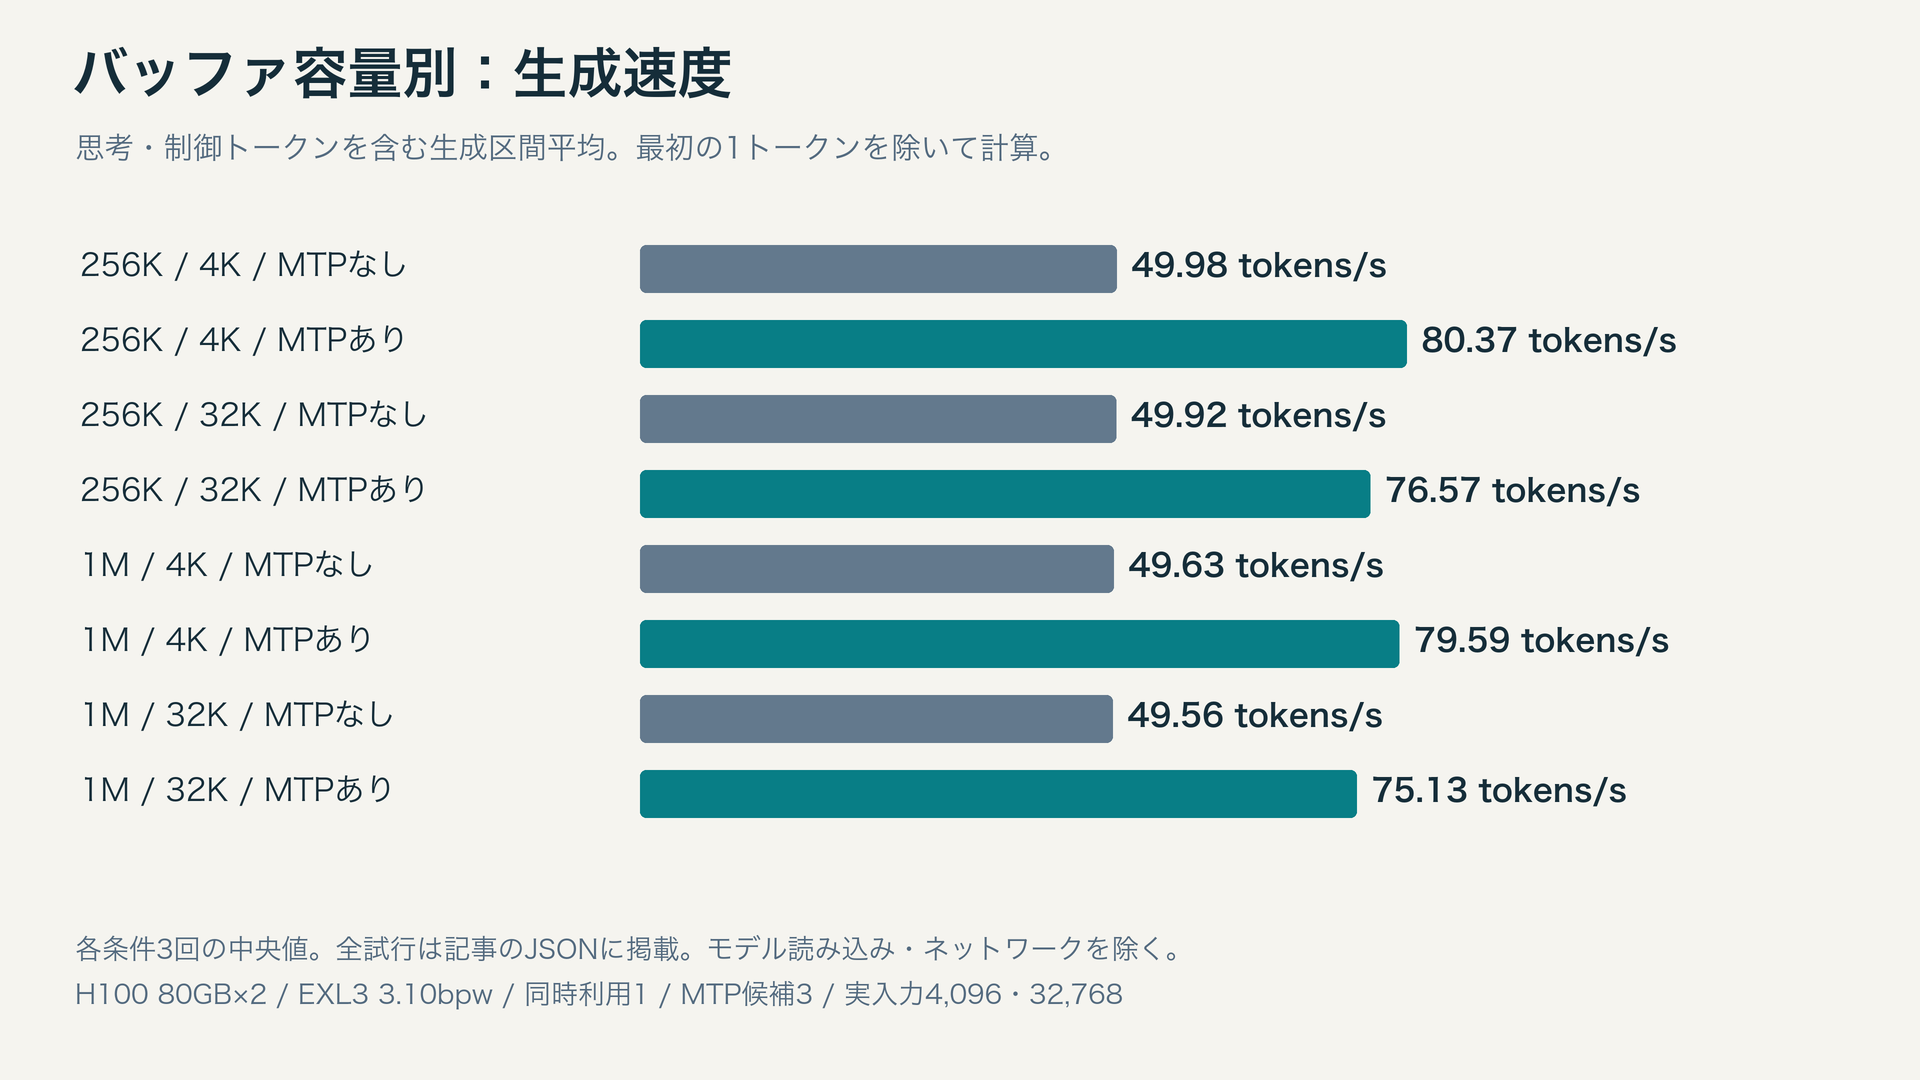
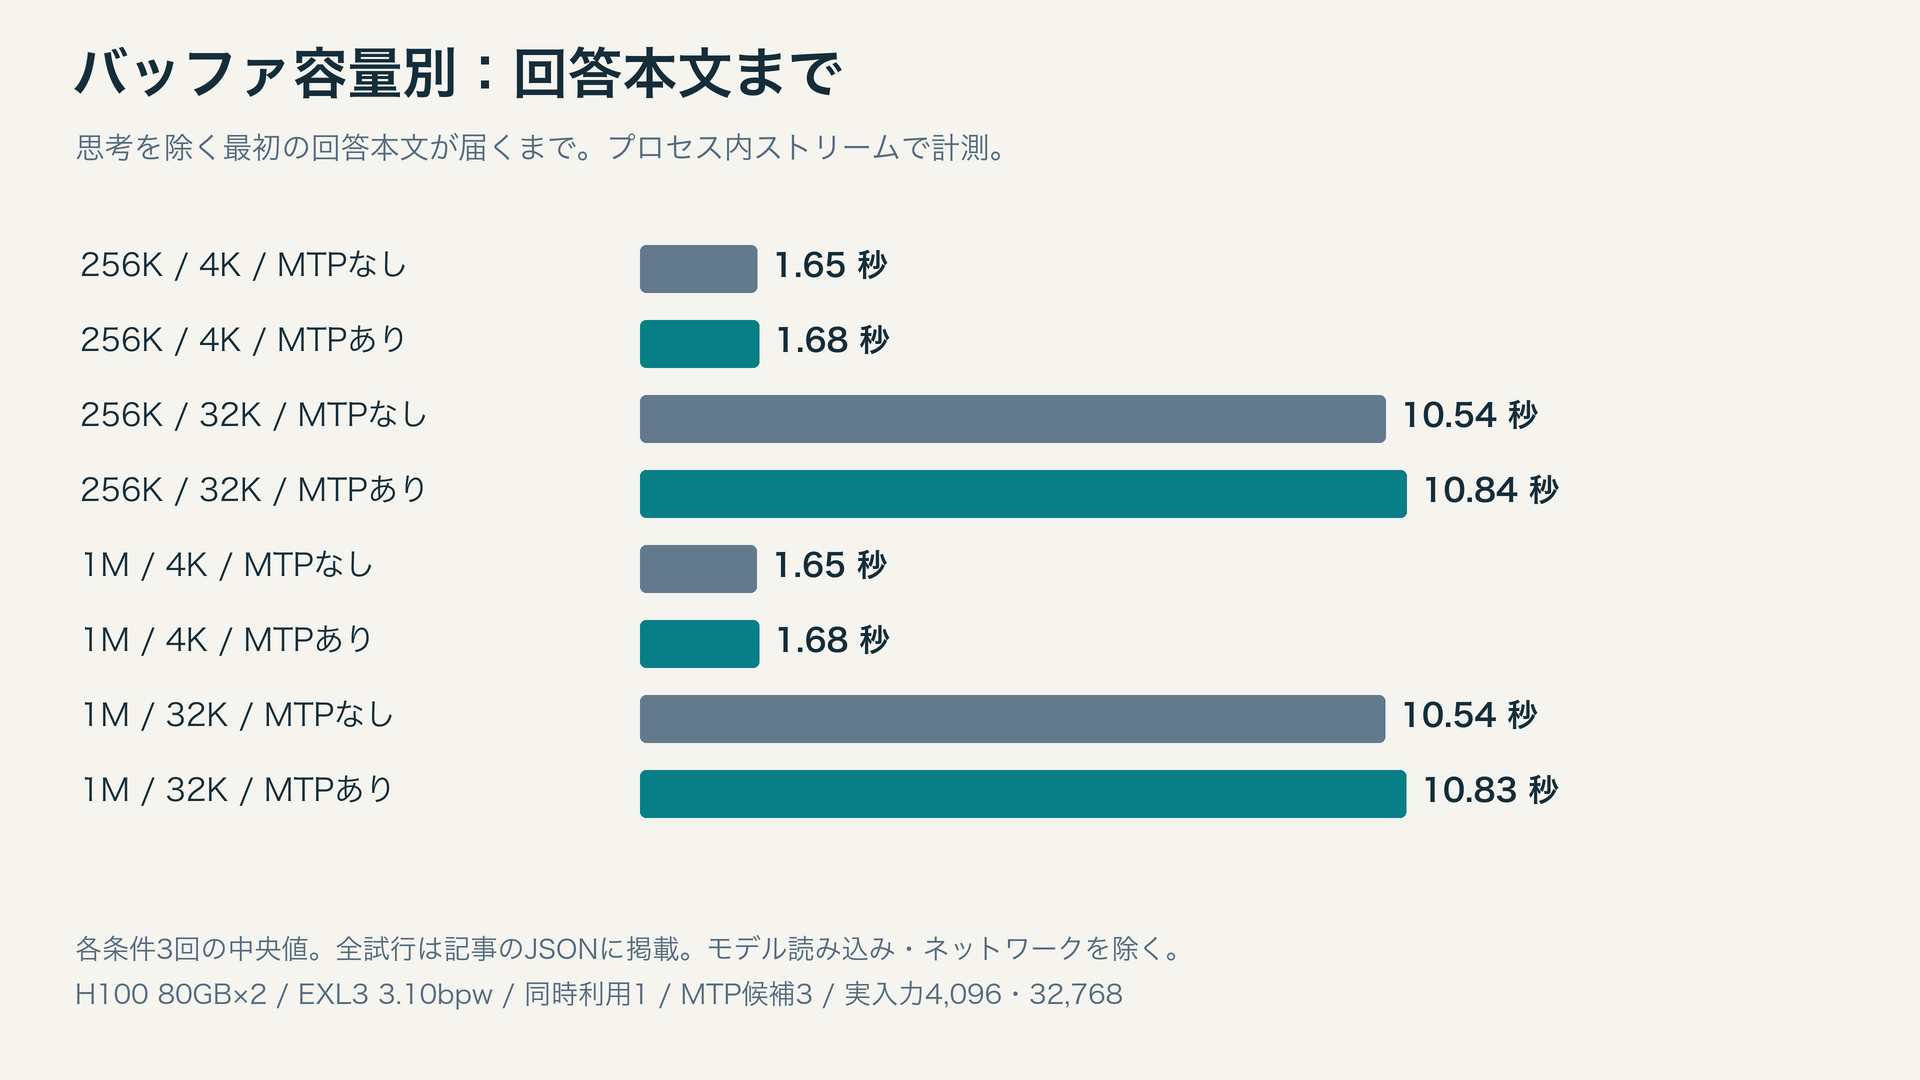
各条件3回。4条件の事前ウォームアップを各容量で別に実施し、計8回を除外して保存しました。本測定24回はすべて掲載しています。生成速度は最初の1トークンを除いた生成区間平均で、思考・制御トークンも含みます。日本語の文字数毎秒や、常時50tokens/sの保証ではありません。出力長が異なるため、同じ長さの回答を完了するまでの速度比とも違います。
時間は読み込み済みモデルへのプロセス内要求からストリームを観測したものです。モデル読み込み、初期ウォームアップ、トークン化、ネットワーク通信は除きます。入力キャッシュの再利用・入力切捨てはありません。速度測定の入力にも、長さを合わせるための参照外テキストを含みます。実際の入力全文を公開JSONに保存しました。MTPなしでも補助モデルとキャッシュは置いたままにし、主モデルの配置を固定してMTP使用だけを切り替えました。したがってMTPなしの最小メモリを測った結果ではありません。ただし256Kと1Mの容量間では、自動配置される層の割り当てが異なります。容量ごとの実用構成の比較であり、バッファ容量だけを変えた因果効果の測定ではありません。
| 確保容量 | GPU0ピーク GiB | GPU1ピーク GiB |
|---|---|---|
| 256K | 64.60 | 66.42 |
| 1M | 72.39 | 72.56 |
「品質が落ちない」を、どう検証したか
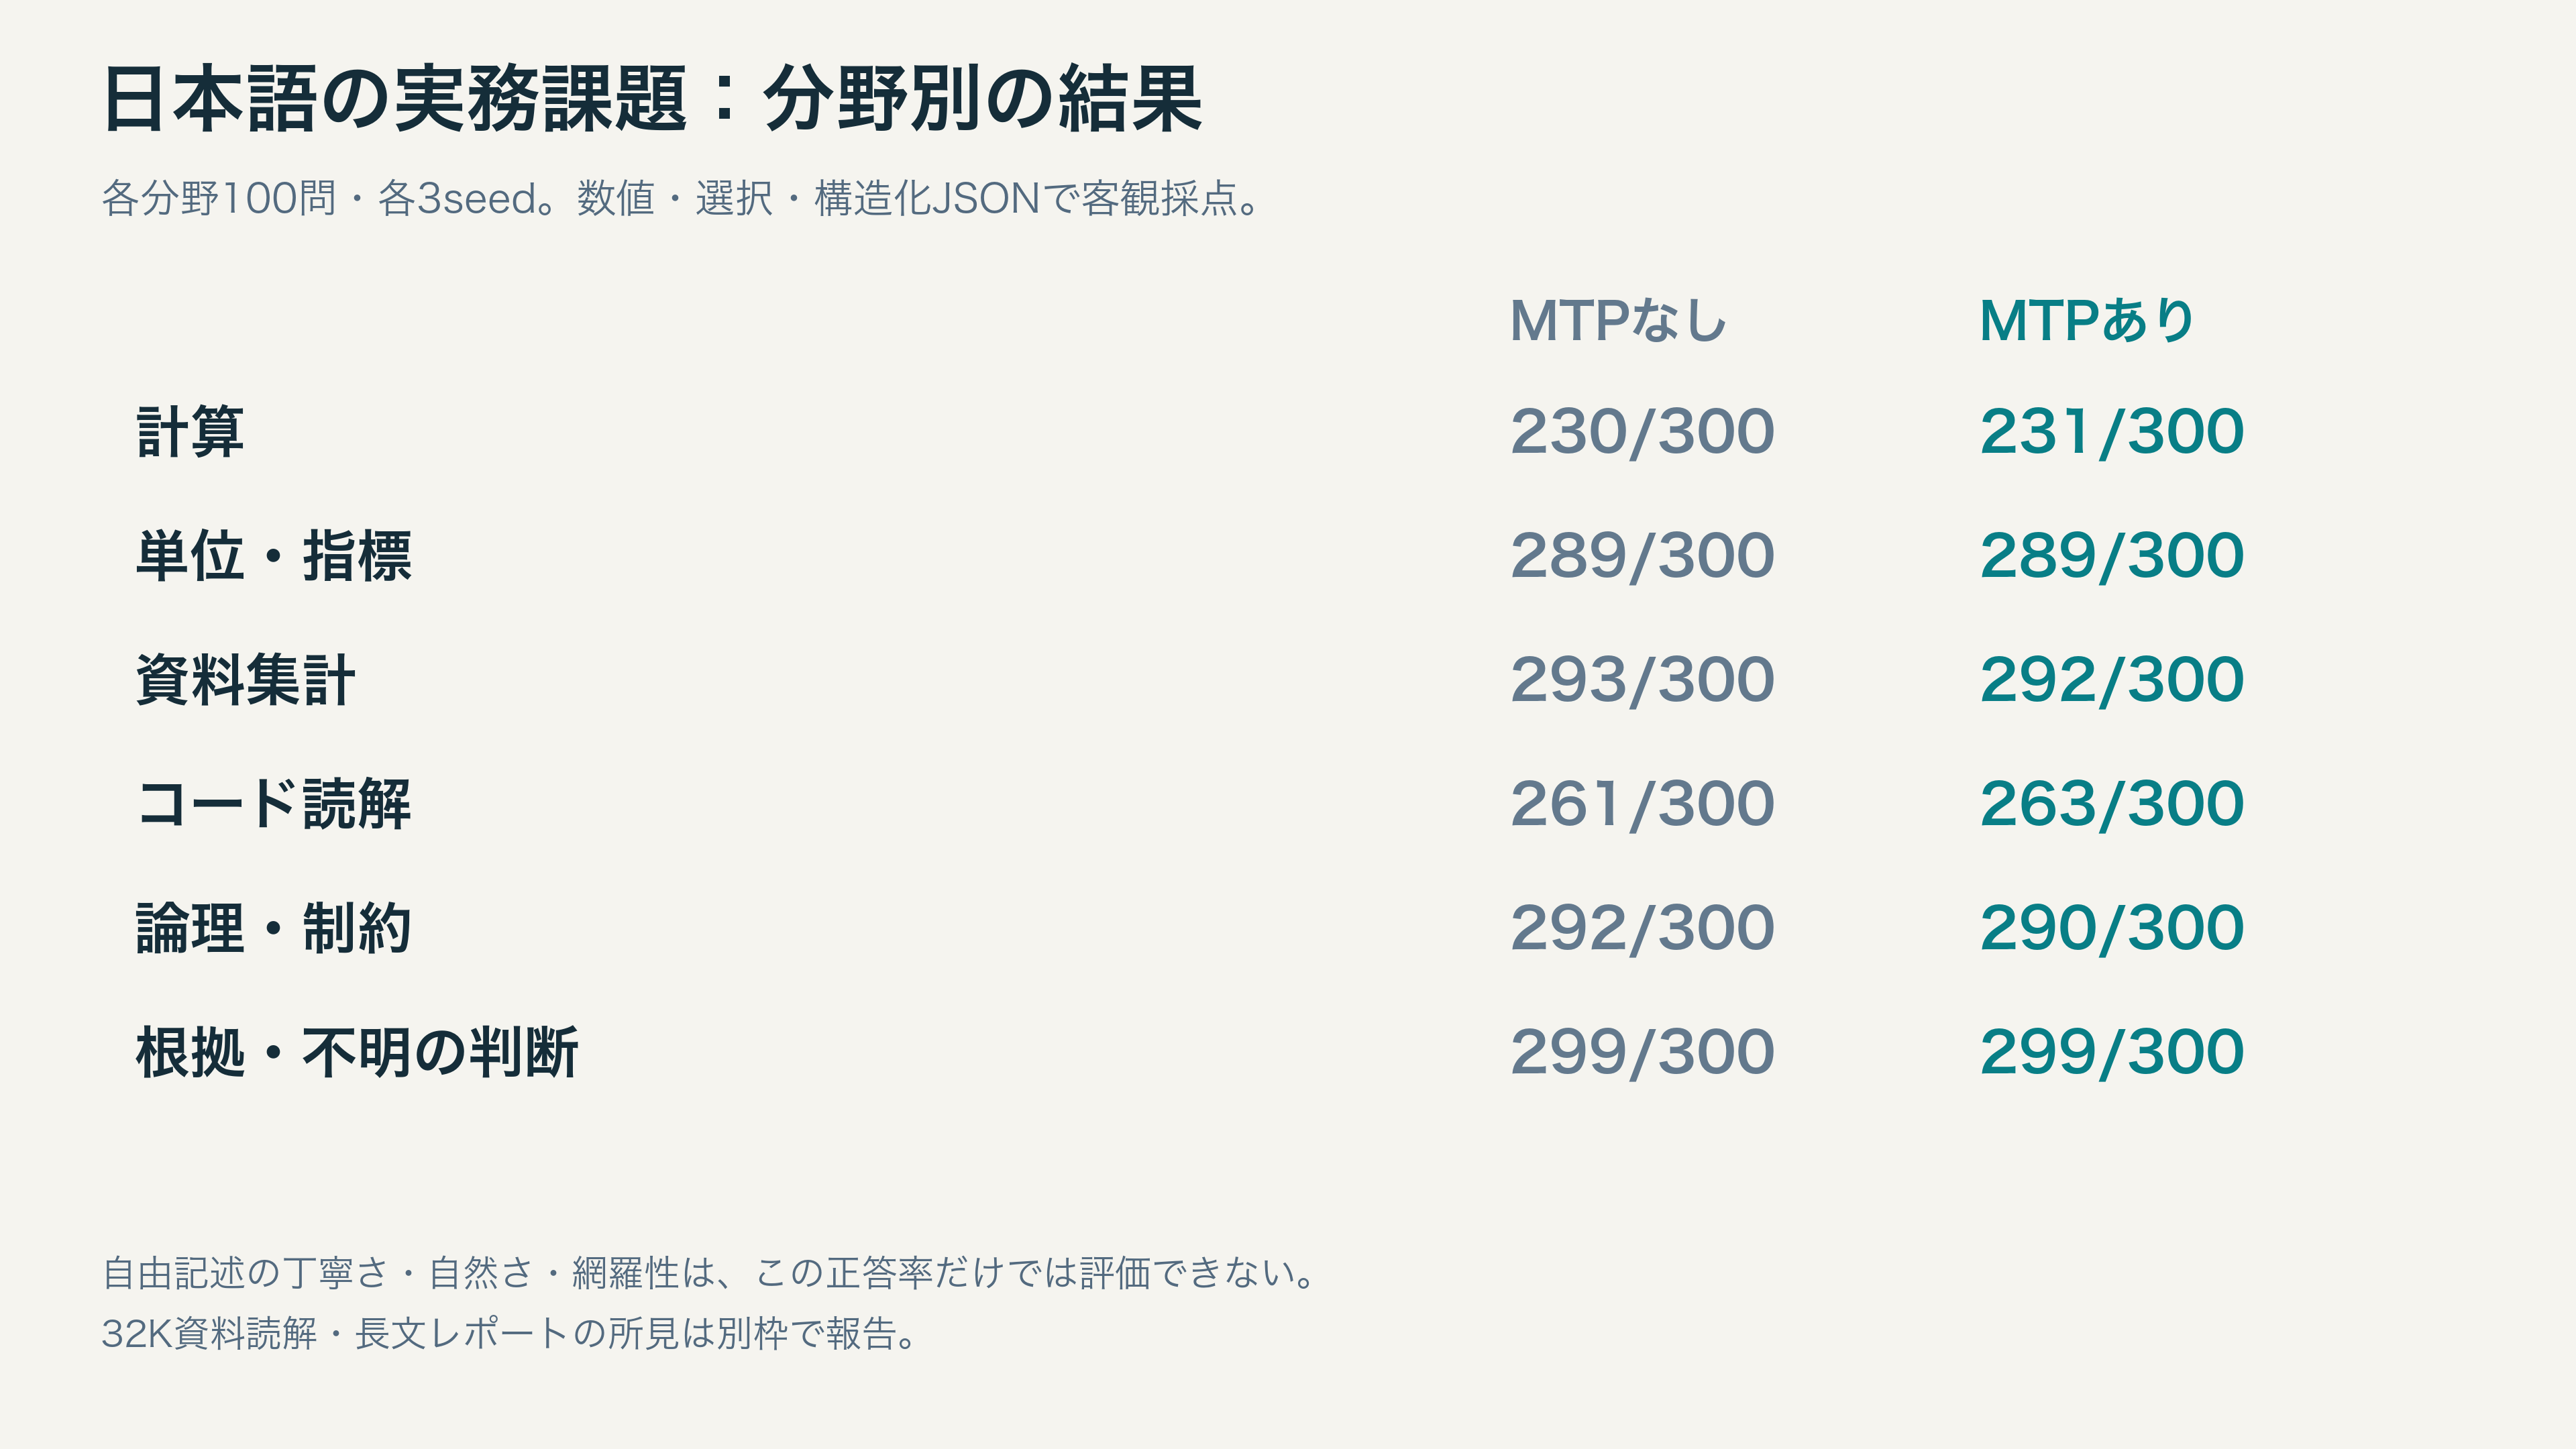
結果を見る前に600問と正解、採点方法、seed、MTPあり/なしの実行順、判定基準を固定しました。日本語の計算、単位・指標、資料集計、コード読解、論理・制約、根拠に基づく判断の6分野です。実務を想定して作成した合成課題で、顧客の実データではありません。各分野5テンプレートから100問を作り、合計30テンプレート・600問としています。600種類の異なる実務を網羅したという意味ではありません。
各問を3つのseedで繰り返し、MTPなし/候補3ありを対にして、計1,800組・3,600回答を得ました。実入力は4K、確保容量1M、最大生成1,024、同時利用1。temperature=1、top_p=0.95、top_k=0です。テンプレート設定はreasoning_effort=low、enable_thinking=trueです。モデルには電卓・検索・コード実行などのツールを与えず、生成した回答を比較しています。ツールを使うエージェント全体の業務成功率を測った試験ではありません。4Kへの長さ調整には計算対象外と明示した反復ログを使い、回答対象の質問を末尾に置いています。4K全体に重要情報が散在する業務文書の試験ではありません。JSON形式で客観採点し、正しい答えと自然終了の両方を求めました。形式不備、生成上限での打切り、不正解を除外しません。別の120組ではgreedy生成も確認しました。
主判定は「MTPあり−なしの正答率差」の片側95%信頼下限が−2ポイントを超えることです。2ポイントは本試験で事前に定めた許容差であり、お客様の業務で許される誤りの上限ではありません。同一問題の3seedを独立3問とは数えず、問題単位でまとめ、分野・テンプレートの30層内で20,000回bootstrapしました。有限の問題集に対する限定的な非劣性の検証で、完全一致の証明ではありません。問題集内で差が一度も観測されない場合、bootstrapの区間は0に縮むため、それだけで真の差が厳密に0だとは判断できません。悪化があった問題数の二項上限も感度分析として併記します。
正答率と、正誤が逆転した組
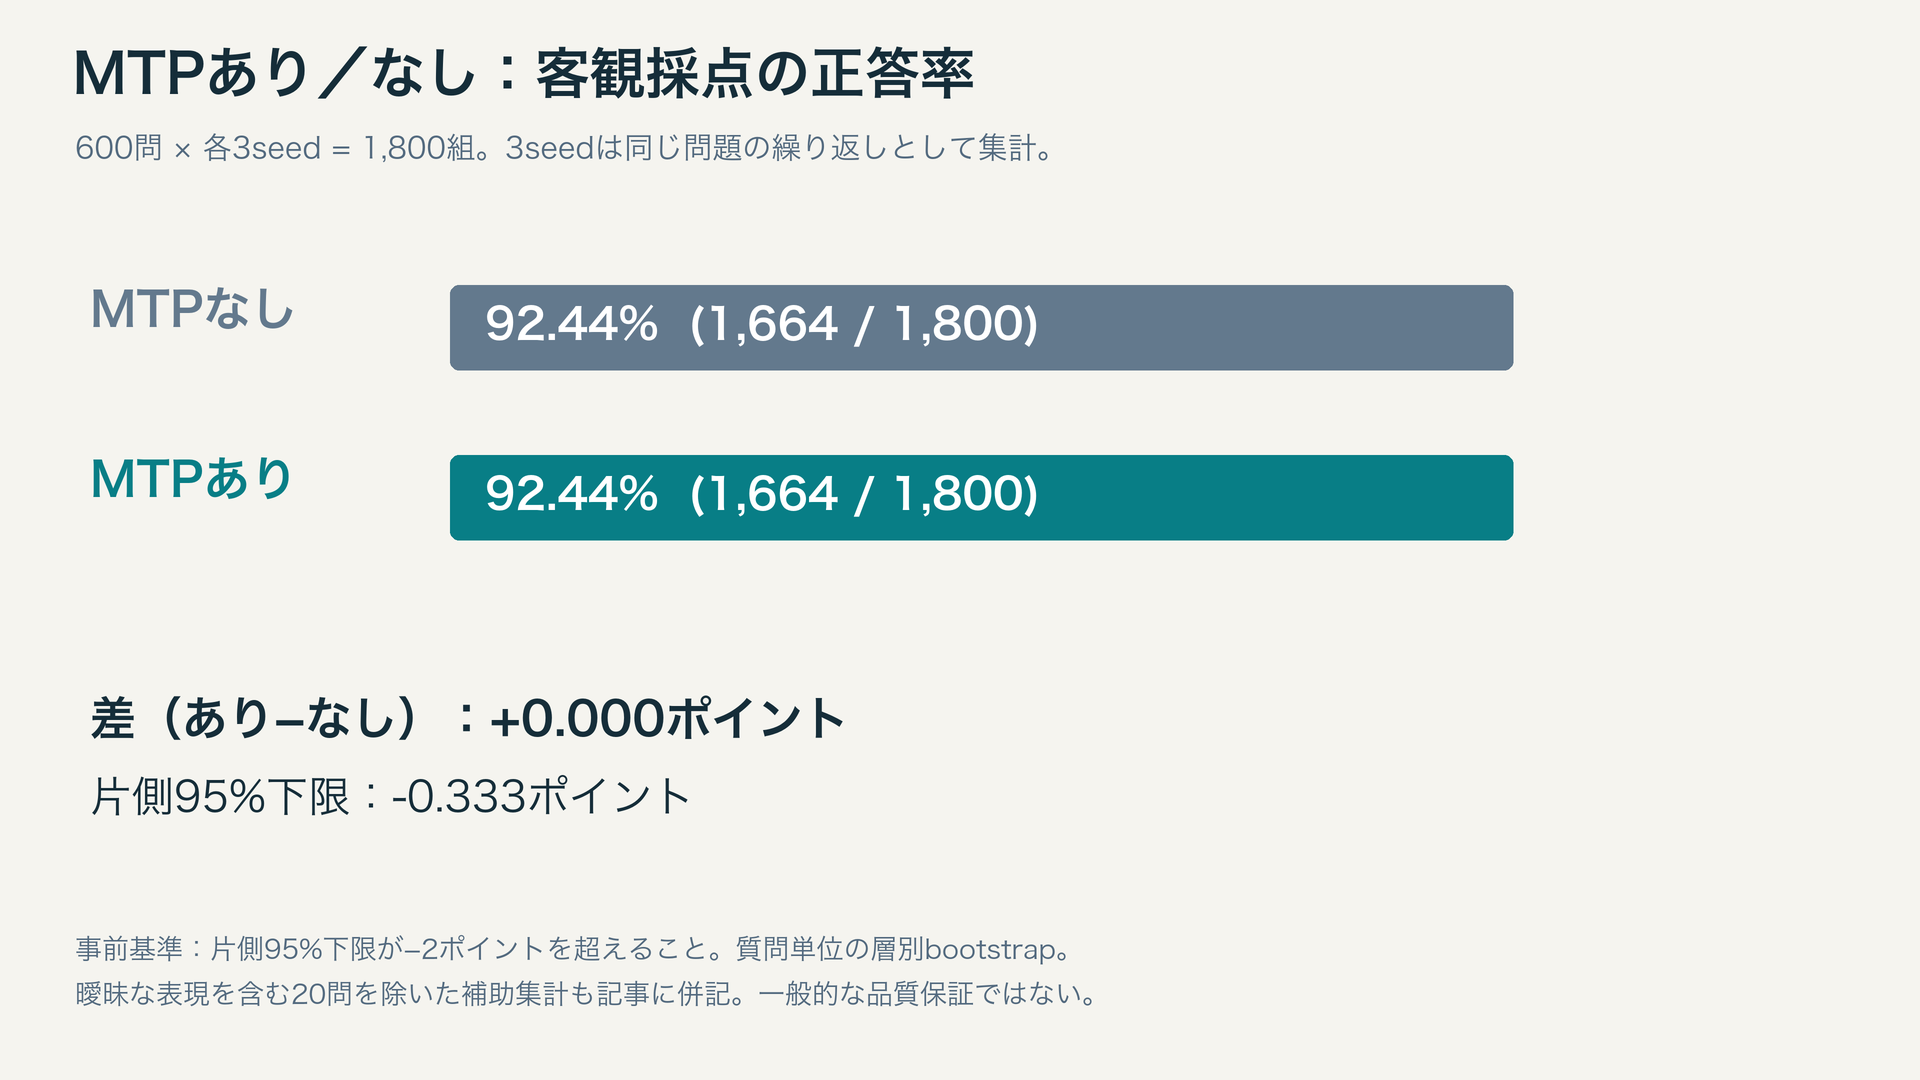
| 指標 | 結果 |
|---|---|
| MTPなし | 1664/1,800 (92.444%) |
| MTPあり | 1664/1,800 (92.444%) |
| 差 あり−なし | +0.000ポイント |
| 片側95%信頼下限 | -0.333ポイント |
| 両方正解 | 1653 |
| MTPありだけ正解 | 11 |
| MTPなしだけ正解 | 11 |
| 両方不正解 | 125 |
| 上限終了 なし/あり | 0 / 0 |
| JSON形式妥当 なし/あり | 1800 / 1799 |
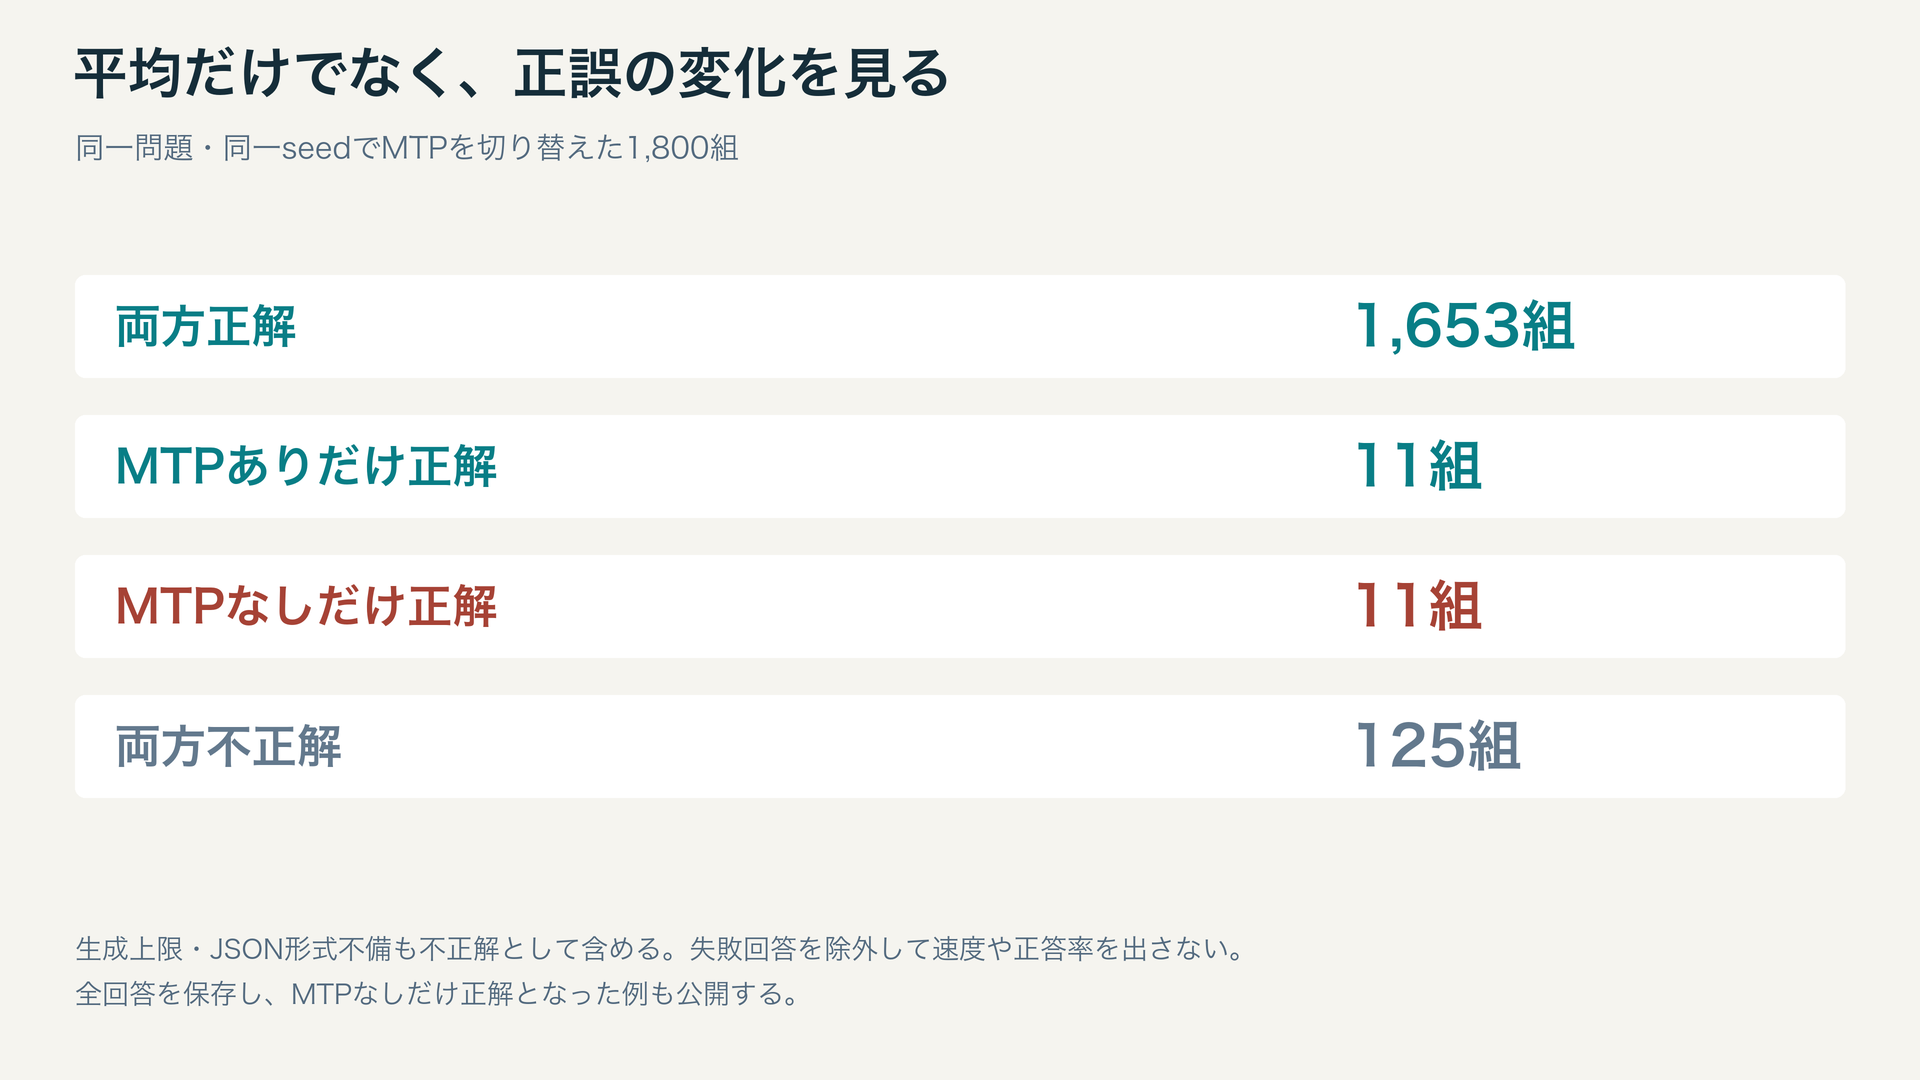
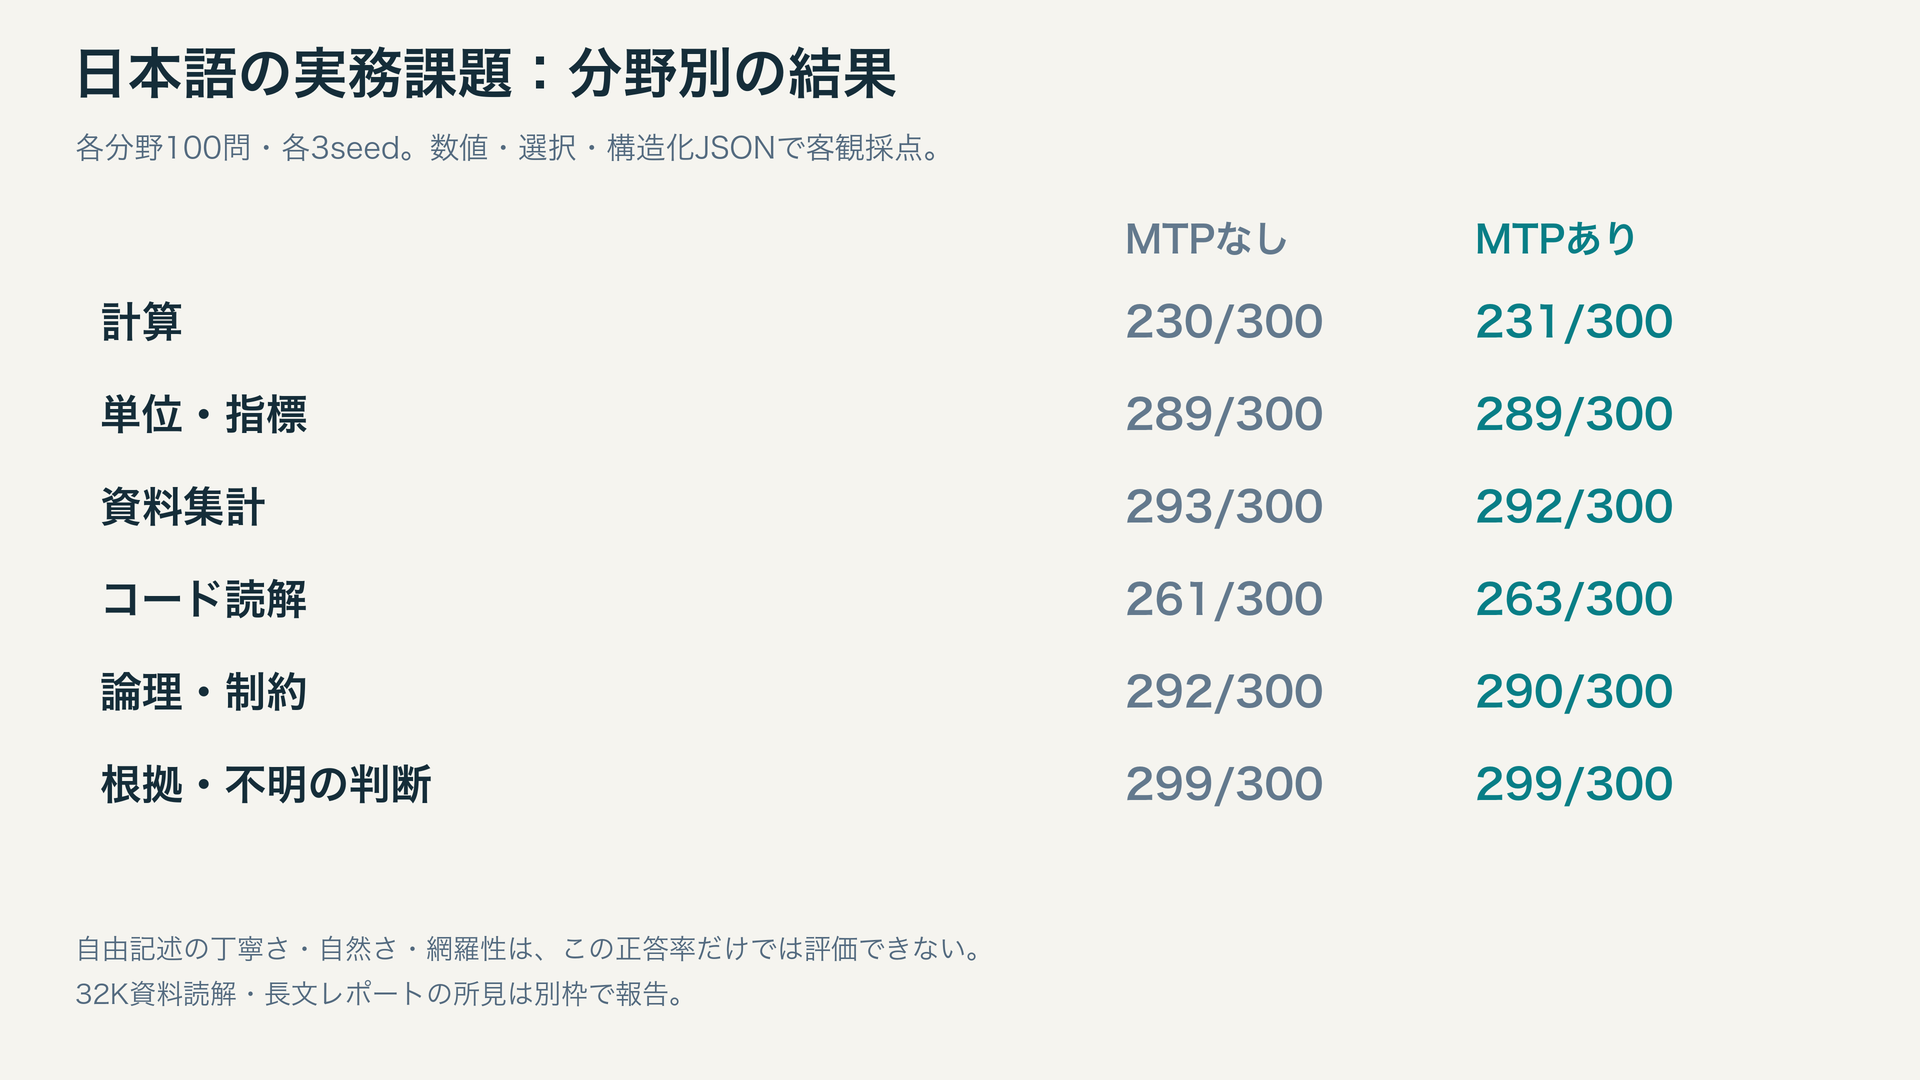
この固定問題集では、正答率差の片側95%信頼下限が−2ポイントを超え、事前に定めた非劣性の判定基準を満たしました。平均で基準を満たしても、特定の入力でMTPありだけ不正解になる可能性まで否定したことにはなりません。実際のMTPなしだけ正解の組は11件です。問題単位で3seedのどこかにこの変化があったのは11/600問。二項独立仮定による感度分析の片側95%上限は3.016%です。同じテンプレートから作った問題であり、他の業務入力への一般化には限界があります。
この二項上限は「3seedのどこかでMTPなしだけ正解となる問題の割合」の補助指標で、平均正答率の差に対する−2ポイントの主判定とは異なります。分野別では計算課題の正答はMTPなし230/300、あり231/300と、どちらも約77%でした。同程度という相対評価を、実務上十分な計算精度という評価に置き換えることはできません。
同じ質問でも、具体的に何が変わったか
以下は確認した現象を説明するために選んだ例です。無作為抽出した標本ではなく、頻度の判断には上の全件集計を使います。各問・同じseedで対にした結果です。
| 例 | 元の正解 | MTPなしのanswer | MTPありのanswer |
|---|---|---|---|
| コード読解:MTPありだけ誤答 | 10 | 10 | 13 |
| コード読解:MTPありだけ正答 | [11, 2, 4] | [11, 15, 16] | [11, 2, 4] |
| 計算値は同じ、返す値の型・単位で不合格 | 93.95 | 93.95 | "93.95%" |
| 両条件に共通する計算誤り | 9700 | 9500 | 9500 |
| 同じコードの別seed:MTPありだけ正答 | 10 | 9 | 10 |
| 数量集計:MTPありだけ誤答 | 371 | 371 | 381 |
| 数量集計:MTPありだけ正答 | 408 | 388 | 408 |
コード読解:MTPありだけ誤答(code-056)
次のPython 3コードのprintが出力する値を答えてください。コードは実行せず読解してください。
```python
xs = [13, -2, 9, 6, 6, -1, 6, 10]
print(sorted(set(xs))[-2])
```
コード読解:MTPありだけ正答(code-043)
次のPython 3コードのprintが出力する値を答えてください。コードは実行せず読解してください。
```python
xs = [14, 11, 5, 2, 15, 4, 16, -5]
print(xs[1:7:2])
```
1つ目は重複除去・昇順整列した値から末尾の2番目を求める問題で、正解10に対してMTPありでは13でした。2つ目のスライス問題は逆にMTPありで正答しました。また1つ目と同じ問題でも、別seedではMTPなしが9、ありが正解の10となった回があります。各seed内では同じseedで対にしています。したがって、平均の判定基準を満たすかどうかと、個々の回答が常に同じ品質かどうかは別です。
3つ目は数値93.95の代わりに文字列「93.95%」を返したため、単位を付けない数値回答という指定で不合格になっています。計算自体の誤りとは区別します。4つ目は18,000−8,400×2+8,500=9,700の計算を、両条件とも9,500と誤答した例です。MTPあり/なしの相対比較が良好でも、基礎となるモデル回答が全問正解という意味にはなりません。
実務を想定した数量集計にも両方向の変化があります。12行の数量から返品数を引いた合計を求めるrecords-037では、正解371に対してMTPなし371、あり381でした。別のrecords-072では、正解408に対してMTPなし388、あり408と逆になりました。いずれも各対の中では同じ入力・seedです。元資料と回答全文は公開JSONで確認できます。
設問の表現に見つかった曖昧さと、補助集計
回答確認中に、会議室の設問で「複数の会議室に分けて収容」と「必要な会議室数の最小値」の解釈がぶつかる表現を見つけました。たとえば定員2・6・2人の部屋に6人を収容する問では、元の正解は1室ですが、「複数」を文字どおり読むと2室以上と解釈できます。この問のMTPありの2室という回答を、明確な品質劣化の例とは扱いません。
元の600問の結果と採点は変更せず、同じテンプレートの20問をすべて除く580問・1,740組でも補助集計しました。回答を一部見た後に追加した分析であり、事前登録した主結果の代わりではありません。除外はMTPの有利・不利ではなくテンプレート全体に適用しました。元の正解が1室の問いは1問ですが、対象テンプレート20問すべてを除いています。
| 集計 | 問題数/対比較 | なし正答 | あり正答 | 差 ポイント | 片側95%下限 ポイント |
|---|---|---|---|---|---|
| 事前の主比較 | 600問/1,800組 | 1664 | 1664 | +0.000 | -0.333 |
| 表現確認後の補助集計 | 580問/1,740組 | 1604 | 1605 | +0.057 | -0.287 |
−2ポイントの基準に対する判定は、元の集計と補助集計で一致しました。補助集計も同じ質問の3seedをまとめ、残った29テンプレート内で20,000回bootstrapしています。全問題・全回答と除外規則は公開JSONに残しました。
補助のgreedy試験120組では、正答はMTPなし112、あり112。停止トークンを含む全トークン列の一致は96/120組でした。samplingでは1500/1,800組です。同じseedでも、浮動小数点計算や実装上の状態により全出力が同じとは限りません。文字列一致と正答率は別指標です。
旧1,024上限:32K資料読解と長文レポートの限界
別枠の資料課題24問では、4Kに50件、32Kに600件の記録を入れ、集計・検索・根拠の確認を各1seedで比較しました。計24組の正答はMTPなし11、あり11です。問題の内容と記録量が異なるため、4Kと32Kの品質差を因果比較したものではありません。
| 資料課題の実入力 | 問題数 | MTPなし正答 | MTPあり正答 | なしだけ正解 | ありだけ正解 |
|---|---|---|---|---|---|
| 4K | 12 | 11 | 11 | 0 | 0 |
| 32K | 12 | 0 | 0 | 0 | 0 |
資料課題は6項目すべての正答を求める厳格な判定です。項目別の成績も公開JSONに併記しますが、部分正解を全問正解に置き換えてはいません。
32K資料は、MTPなし12/12回・あり11/12回が、思考と回答を合わせた1,024トークンの出力上限で終了しました。これら23回答は思考中の列挙・集計で打ち切られ、回答本文へ到達していません。1Mの入力バッファが確保できることと、必要な出力予算を確保することは別です。残るMTPあり1回は自然終了しましたが、対象部署の合計9,883を概算の9,500として回答し、最終JSONでは概算であることを示していませんでした。したがって32Kの実務品質を確認できたとは言えません。
4Kの共通する1問の誤答は部署別合計1,273を1,375としたもので、他の5項目は正答でした。32Kで完了した1回答も、合計以外の5項目は正答です。上限終了では最終JSONがないため項目別採点も0となりますが、思考中に指定IDの値などを述べた例はあり、すべての個別検索が失敗したと読み替えることはできません。初回の資料課題試験では出力上限の拡大を測っていませんでした。今回の追加試験で4,096・8,192へ増やした結果を掲載しました。集計ツールを併用した試験は引き続き未実施です。この小規模補助試験で、32K品質の非劣性を判定したわけでもありません。
速度測定用の長文レポート24回答も全文を点検しています。計算が合っていても、資料にない試行と入力長の対応を補う、時間区間を定義せず加算する、指定した文字数目安を大きく超える、といった問題が残りました。所見は回答ごとに公開JSONへ収録しました。構造化した短答の正答率が高くても、自由記述の正確さ・自然さ・網羅性まで保証できません。点検者はCodexであり、人間による全回答の確認完了とは扱いません。
MTPの仕組みと、4bit量子化の位置づけ
投機的生成は、補助モデルが出した候補を主モデルで検証する方法です。対象のExLlamaV3実装では、主モデルの分布から得たトークンと候補が一致した部分を採用し、不一致なら巻き戻します。これは対象分布の維持を意図した実装ですが、コードの意図だけで、実機の数値計算・キャッシュ・状態管理を含む正しさが証明されたことにはなりません。今回の実測はその確認を補うものです。
同じ配布者のsc_4.10bpw版も存在し、重みファイルは約167.73GB(156.21GiB)です。今回の既存データを保持したまま追加で保存する容量が足りず、GPU配置の見積もりも今回の予算を超えるため、4bit版はダウンロード・ロード・品質測定をしていません。これは4bit版があらゆる構成で動かないという結論ではありません。また4bitに変えれば全問正解になるとは限りません。既存の誤りを3bit量子化が原因だと断定する比較も実施していません。
MTPの効果を調べる主比較では量子化を固定しました。量子化精度の効果を知るには、別途3bit/4bitそれぞれでMTPなし/ありの4条件を同じ問題で測る必要があります。
一次資料:モデル配布と量子化版、ExLlamaV3 1.6.5の生成実装、投機的生成の原論文。理論の成立条件と、今回の実装・実機検証は区別します。
全条件・集計・品質所見(JSON) / 品質・速度試験の問題・正解・全回答・全試行(JSON)。初期停止・ウォームアップ・pilotを主成績に混ぜず、保存記録を分けています。
実機選定に使うには
今回、B200での構成変更とMTPの異なる効果に加え、H100 80GB×2でMTPありの全6回が試行平均50tokens/sを超える実測を得ました。入力長・待ち時間・品質の制限とセットで構成候補を示せます。H200 NVLやRTX PRO 6000 Blackwellの性能を予測した表ではありません。GPU間接続も含め、導入先の実機と業務入力で確認する必要があります。
今後の比較では、普段の入力長と最大入力長、回答の長さ、同時利用人数、待てる時間、必要な回答品質をそろえて評価します。入力を長く保持できる容量と、その長さを実際に処理したときの速度も区別します。
今回のH100 ExLlamaV3追補を含む更新版動画を掲載しています。10月30日版の動画も比較履歴として残しています。
一次資料
ExLlamaV3 v1.6.5:https://github.com/turboderp-org/exllamav3/releases/tag/v1.6.5
GLM-5.3-Flash EXL3配布:https://huggingface.co/turboderp/GLM-5.3-Flash-exl3/blob/main/README.md
MTPを推論高速化に利用する一般的説明:https://github.com/deepseek-ai/DeepSeek-V3
今回の数値の根拠は自社測定。固定版・モデルハッシュ・全試行・品質所見は共通データに紐づけて保存。
全試行の公開データ
B200の構成比較・MTP比較(JSON) / H100×2のMTPあり/なし全12試行(JSON)。中央値だけでなく各試行、待ち時間、メモリ、制限を記載しています。