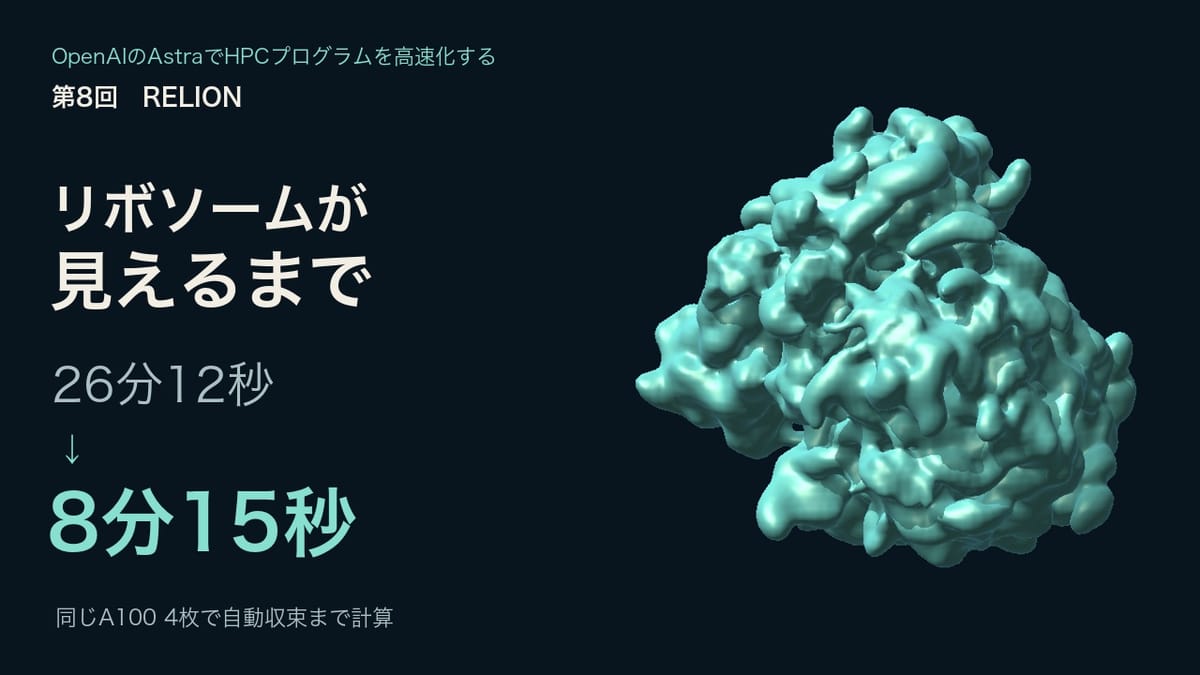
リボソームが見えるまで、26分から8分へ。OpenAIのAstraでHPCプログラムを高速化する 第8回・RELION
同じ10万5,247枚の粒子画像から、リボソームの立体像ができるまでを実測。公開CPU 32・64コアとA100 1・2・4枚を比較し、同じ4枚で26分12秒から8分15秒に短縮した。
同じ10万5,247粒子、同じGPU 4枚。公開版が得意とする構造解析で、どこに時間が残っていたのか。
下の写真には、同じ種類の分子が一つずつ写っている。輪郭はぼんやりしていて、向きもそろっていない。試料の中で一つひとつの粒子が違う向きを向いているおかげで、10万枚を集めると、さまざまな角度から見た手掛かりがそろう。そこから再構成したのが冒頭の立体像だ。
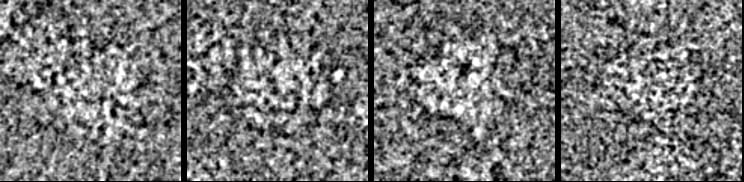
被写体は、薬剤エメチンが結合したマラリア原虫の80Sリボソームだ。リボソームは、細胞の中でタンパク質をつくる。Wongらが公開した電子顕微鏡データを借りて、RELIONの3次元自動精密化を走らせた。計算が推定するのは、各粒子の向きと位置、そして、それらの観測を説明できる三次元の密度分布だ。粒子画像 EMPIAR-10028 / 試料と原論文
22回で収束。違ったのは時計の針だった
公開版とAstra改良版を、同じ4枚のA100で順に実行した。入力の粒子も初期の立体像も共通だ。初期像には公開参照マップの大まかな形だけを残した。RELIONは、そこから計算した投影像を粒子画像と照らし合わせ、向きと位置を推定し、密度マップを更新する。両版とも22反復で自動収束した。
公開GPU版は 1,572.33秒(26分12秒)。Astra改良GPU版は 495.32秒(8分15秒)。同じ4枚で3.17倍、1回の再構成で約18分短縮した。
全105,247粒子を120×120画素に縮小し、プログラムの起動から最終結果を書き終えるまでを計った。収束までの試行は各版1回。
GPUが1枚なら何分待つ? CPUから4枚GPUまで、収束までの実測
| 実行構成 | 開発元の公開版 | Astra改良版 | 同じ構成での高速化倍率 |
|---|---|---|---|
| CPU 32物理コア | 27,883.68秒(22反復) | 対象外 | — |
| CPU 64物理コア | 14,083.89秒(22反復) | 対象外 | — |
| A100 1枚 | 5,682.74秒(22反復) | 1,783.75秒(22反復) | 3.19倍 |
| A100 2枚 | 4,815.36秒(22反復) | 1,156.61秒(22反復) | 4.16倍 |
| A100 4枚 | 1,572.33秒(22反復) | 495.32秒(22反復) | 3.17倍 |
105,247粒子、120×120画素、各構成・各版1回の実測。全て同じ入力から自動収束し、独立半マップ2個を書き出した。起動・画像読み込み・全反復・最終出力を含む。秒数の後の括弧内は実際の反復回数。CPU 32コアは初回の最終出力を保存できなかったため、同条件で最初から再計測した1回の値を掲載した。CPUの独自改良は行っていない。GPUあたりMPIワーカーは2個。1・2・4枚でワーカーあたりのホストスレッドは順に4・2・4本なので、枚数をまたぐ時間差にはCPU側の構成も影響する。同じ枚数内では両版の設定をそろえた。
A100が1枚のとき、公開版は1時間34分43秒、同じ1枚の改良版は29分44秒だった。公開版を2枚に増やすと1時間20分15秒になった。公開CPU版では64物理コアが速く、収束まで3時間54分44秒かかった。
| GPU枚数 | GPU化の効果(公開CPU 64コア÷公開GPU) | 総合倍率(CPU比・公開CPU÷改良GPU) |
|---|---|---|
| A100 1枚 | 2.48倍 | 7.90倍 |
| A100 2枚 | 2.92倍 | 12.18倍 |
| A100 4枚 | 8.96倍 | 28.43倍 |
何万枚目の粒子でも、同じ向きは同じ矢印になる
たとえば、ある粒子が「ほぼ正面」を向いていると分かってきたとする。精密化の終盤では、正面からほんの少しずつずれた向きを調べて、最もよく合う候補を探す。次の粒子では調べたい範囲が変わる。一方、球面に並べた候補方向の一覧には、粒子をまたいで使えるものがある。
公開版は、ある方向が探索範囲に入るかを判定するとき、角度から三次元の矢印を繰り返し計算していた。Astra改良版では、その矢印を一度つくって保存し、一覧が変わるまで再利用した。角度を細かく調べるほど候補は増えるので、終盤ほどこの判断が効いてくる。今回の実装が対象とするのは、回転対称性を仮定しないC1の局所探索だ。
実際に第19〜21反復だけを取り出すと、公開版が660.37秒、改良版が73.66秒で8.97倍だった。これは各反復の出力時刻から求めた区間値である。全体の3.17倍には、GPU処理の完了確認に使うCUDAイベントの再利用や、並列プロセス間の画像データの共有も効いている。
最初の3反復だけ測ると、倍率はどう変わるか
精密化の序盤だけで同じ比較をするとどうなるか。全粒子・120×120画素の入力で初期3反復を固定した。最も速かったCPU構成は64物理コア。1枚でも2枚でも4枚でも、同じ枚数の公開版をAstra改良版が上回った。
| 実行構成 | 開発元の公開版 | Astra改良版 | 同じ構成での高速化倍率 |
|---|---|---|---|
| CPU 32物理コア | 912.71秒 | 対象外 | — |
| CPU 64物理コア | 476.98秒 | 対象外 | — |
| A100 1枚 | 316.71秒 | 123.66秒 | 2.56倍 |
| A100 2枚 | 175.25秒 | 83.01秒 | 2.11倍 |
| A100 4枚 | 92.67秒 | 38.62秒 | 2.40倍 |
4 GPUは各版3回の中央値(公開版92.20〜93.39秒、改良版38.53〜39.22秒)。ほかは各1回。CPUの独自改良は実施していない。全構成でMPI起動から結果の書き出し・終了までを計測した。
64コアの476.98秒から、公開GPU版4枚の92.67秒になるのがGPU化の効果、5.15倍。そこから同じ4枚のまま38.62秒になるのがAstraの上積み、2.40倍だ。両方を通した総合倍率がCPU比12.35倍になる。冒頭の3.17倍は、方向探索がいちばん細かくなる終盤まで含めた測定値だ。
分子の形は、どこまで一致したか
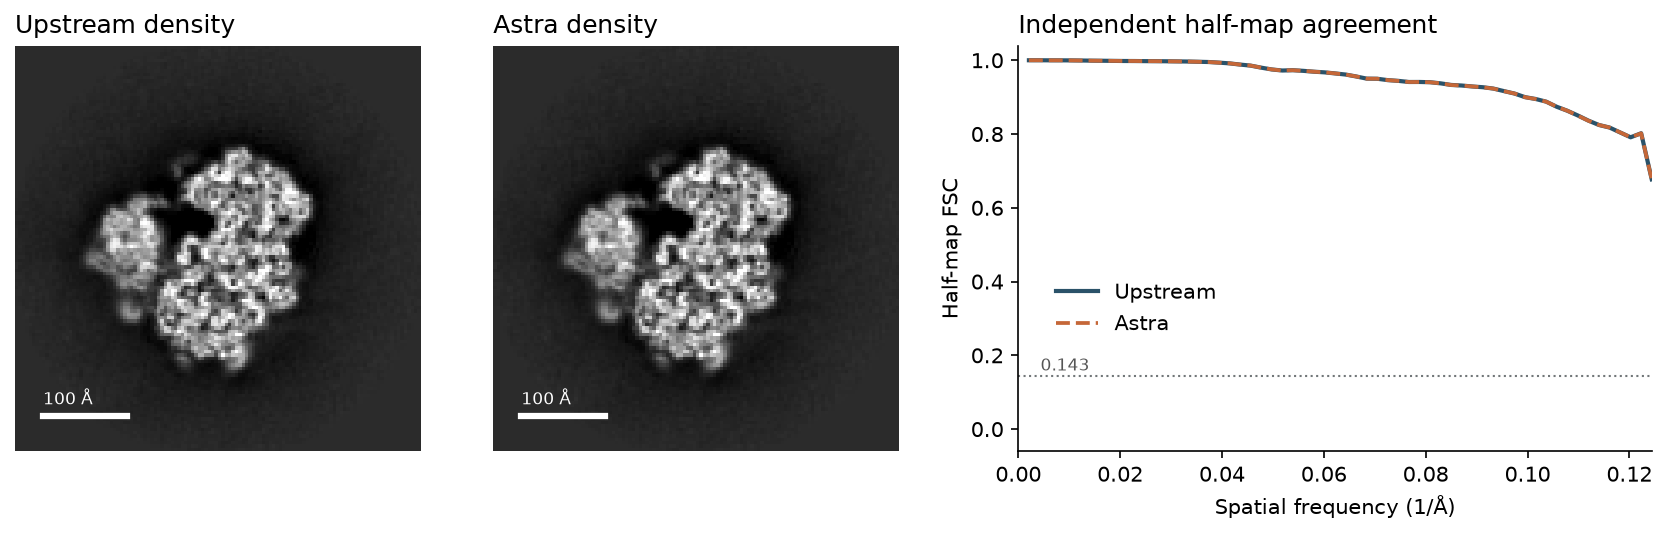
GPU 1枚と2枚でも、同じ枚数の公開版と改良版で収束後の立体像を照合した。二つの半マップを平均した像の相関は、1枚で0.999995、2枚で0.999983だった。4枚での平均マップ同士の相関は0.999973だった。RELIONが報告した分解能も両版とも8.18 Å。1 Åは0.1ナノメートルだ。さらに、あらかじめ二組に分けた粒子から得た半マップを、組ごとに公開版と改良版で比較した。この入力で表せる最も細かい8.04 Åの成分でも、対応する半マップの相関は0.99844と0.99813だった。
一つひとつの粒子まで見ると、推定した向きの差は中央値0度、95パーセンタイルで0.27度だった。一方で90度を超えて異なる粒子も100個あった。全体の形がよく一致していても、個々の粒子の向きには、これだけの違いが残る。
元の360×360画素でも速くなるか
最後に、画像を縮小せず、元の360×360画素のまま全粒子で初期3反復を測った。A100 4枚で公開版は217.73秒。上記の改良版では131.10秒、さらに画像を分割して読み込む経路も改良すると120.81秒になった。元画素でも同じ4枚で1.80倍、各版1回の結果だ。
元画素・全粒子で収束まで走らせた場合の倍率は今後の測定課題として残る。今回いちばん手応えがあったのは、10万枚の粒子を二十二回調べ直す仕事の中に、粒子が変わってもやり直す必要のない計算を見つけられたことだ。
開発元のRELION 5.0.1を基準に使用。Xeon Gold 6430を2基、A100 PCIe 80 GBを4枚搭載したノードで計測した。公開版と改良版は同じ精度・コンパイラ設定。GPU粒子探索は単精度、ホスト側は倍精度。入力と出力はメモリ上のファイルシステムを使用。初期3反復の公開CPU 64コア試行の一部と、公開GPU版の全粒子収束試験の冒頭では、低優先度ビルドが短時間並行した。RELION 5.0.1
参照像はEMD-2660を60 Åまで低域通過処理したもの。120画素入力は4.02 Å/画素、元画素は1.34 Å/画素。冒頭の回転映像は、Astra改良版で収束した二つの半マップの平均を平滑化(ガウス幅0.85画素)し、密度0.052の等値面を可視化したもの。色と照明は表示用で、視点を一周させている。参照マップ EMD-2660
詳しい測定レポートを開く
RELIONの公開GPU版をどこまで速くできたか
2026年11月15日 単粒子クライオ電子顕微鏡の3次元自動精密化 relion_refine_mpi
抗原虫薬エメチンが結合したマラリア原虫の80Sリボソームを、多数の2次元投影像から再構成した。以下はMPI起動から終了までの実時間(秒)。同じ入力・設定の完走分を集計し、代表値は中央値とした。複数回は範囲も併記した。
全105,247粒子を自動収束まで計算すると、A100 4枚で公開版1,572.33秒、Astra改良版495.32秒、同じGPU構成で3.17倍。 入力は120×120画素、公開版22反復、改良版22反復。各1試行。
全105,247粒子・自動収束までのCPUとGPU
120×120画素。各構成・各版1回。CPU 32・64物理コアとGPU 1・2枚を追加測定し、前回のGPU 4枚と比較した。
| 実行構成 | 開発元の公開版 | Astra改良版 | 同じ構成での高速化倍率 |
|---|---|---|---|
| CPU 32物理コア | 27,883.68n = 1 | CPU改良対象外 | 1.00倍 |
| CPU 64物理コア | 14,083.89n = 1 | CPU改良対象外 | 1.00倍 |
| A100 1枚 | 5,682.74n = 1 | 1,783.75n = 1 | 3.19倍 |
| A100 2枚 | 4,815.36n = 1 | 1,156.61n = 1 | 4.16倍 |
| A100 4枚 | 1,572.33n = 1 | 495.32n = 1 | 3.17倍 |
CPU比(公開CPU 64物理コア基準)。1枚で公開GPU版は2.48倍、改良GPU版は7.90倍。2枚で公開GPU版は2.92倍、改良GPU版は12.18倍。4枚で公開GPU版は8.96倍、改良GPU版は28.43倍。
全105,247粒子でCPUとGPUを比較 初期3反復
120×120画素、4.02 Å/画素。全粒子を使い、全構成で初期3反復を固定した。Astra改良版16。
| 実行構成 | 開発元の公開版 | Astra改良版 | 同じ構成での高速化倍率 |
|---|---|---|---|
| CPU 32物理コア | 912.71n = 1 | CPU改良対象外 | 1.00倍 |
| CPU 64物理コア | 476.98n = 1 | CPU改良対象外 | 1.00倍 |
| A100 1枚 | 316.71n = 1 | 123.66n = 1 | 2.56倍 |
| A100 2枚 | 175.25n = 1 | 83.01n = 1 | 2.11倍 |
| A100 4枚 | 92.67n = 3 92.20–93.39 | 38.62n = 3 38.53–39.22 | 2.40倍 |
CPU比(公開CPU 64物理コア基準)。1枚で公開GPU版は1.51倍、改良GPU版は3.86倍。2枚で公開GPU版は2.72倍、改良GPU版は5.75倍。4枚で公開GPU版は5.15倍、改良GPU版は12.35倍。
4枚GPUの初期3反復では、公開版どうし(初回と各再試行)の平均マップ相関は0.9999922〜0.9999922。公開版と改良版の対応する3組では0.9999906〜0.9999925だった。
全105,247粒子を元の360×360画素で比較 初期3反復
1.34 Å/画素。元の粒子スタックを各MPIランクが必要に応じて読み込む設定を公開版と改良版に共通で用いた。Astra改良版16。
| 実行構成 | 開発元の公開版 | Astra改良版 | 同じ構成での高速化倍率 |
|---|---|---|---|
| CPU 32物理コア | 未測定 | CPU改良対象外 | — |
| CPU 64物理コア | 未測定 | CPU改良対象外 | — |
| A100 1枚 | 未測定 | 未測定 | — |
| A100 2枚 | 未測定 | 未測定 | — |
| A100 4枚 | 217.73n = 1 | 131.10n = 1 | 1.66倍 |
元の画素サイズで比較 4,096粒子・5反復
360×360画素、1.34 Å/画素。初期5反復を固定してAstra改良版16と比較した。
| 実行構成 | 開発元の公開版 | Astra改良版 | 同じ構成での高速化倍率 |
|---|---|---|---|
| CPU 32物理コア | 225.61n = 1 | CPU改良対象外 | 1.00倍 |
| CPU 64物理コア | 163.28n = 1 | CPU改良対象外 | 1.00倍 |
| A100 1枚 | 92.98n = 1 | 35.81n = 1 | 2.60倍 |
| A100 2枚 | 88.65n = 1 | 33.36n = 1 | 2.66倍 |
| A100 4枚 | 94.92n = 2 88.50–101.33 | 33.01n = 1 | 2.88倍 |
CPU比(公開CPU 64物理コア基準)。1枚で公開GPU版は1.76倍、改良GPU版は4.56倍。2枚で公開GPU版は1.84倍、改良GPU版は4.89倍。4枚で公開GPU版は1.72倍、改良GPU版は4.95倍。
開発途中の比較 全105,247粒子・3反復
120×120画素、4.02 Å/画素。画像の共有読み込みを取り入れた段階のAstra改良版13。
| 実行構成 | 開発元の公開版 | Astra改良版 | 同じ構成での高速化倍率 |
|---|---|---|---|
| CPU 32物理コア | 912.71n = 1 | CPU改良対象外 | 1.00倍 |
| CPU 64物理コア | 476.98n = 1 | CPU改良対象外 | 1.00倍 |
| A100 1枚 | 316.71n = 1 | 124.07n = 1 | 2.55倍 |
| A100 2枚 | 175.25n = 1 | 89.62n = 1 | 1.96倍 |
| A100 4枚 | 92.67n = 3 92.20–93.39 | 39.61n = 1 | 2.34倍 |
CPU比(公開CPU 64物理コア基準)。1枚で公開GPU版は1.51倍、改良GPU版は3.84倍。2枚で公開GPU版は2.72倍、改良GPU版は5.32倍。4枚で公開GPU版は5.15倍、改良GPU版は12.04倍。
元の360×360画素の入力読み込みを改良した追加試験
105,247粒子、初期3反復。Astra改良版19は、一度に処理する分の元画像を単精度のまま読み込み、GPUへ転送する。公開版・改良版とも画像を分割して読み込む同じ設定。
| 実行構成 | 開発元の公開版 | Astra改良版 | 同じ構成での高速化倍率 |
|---|---|---|---|
| CPU 32物理コア | 未測定 | CPU改良対象外 | — |
| CPU 64物理コア | 未測定 | CPU改良対象外 | — |
| A100 1枚 | 未測定 | 未測定 | — |
| A100 2枚 | 未測定 | 未測定 | — |
| A100 4枚 | 217.73n = 1 | 120.81n = 1 | 1.80倍 |
補助試験 4,096粒子・120×120画素・5反復
中間のAstra改良版7で、イベント管理、角度探索、再構成の変更を確認した。
| 実行構成 | 開発元の公開版 | Astra改良版 | 同じ構成での高速化倍率 |
|---|---|---|---|
| CPU 32物理コア | 62.96n = 1 | CPU改良対象外 | 1.00倍 |
| CPU 64物理コア | 35.51n = 1 | CPU改良対象外 | 1.00倍 |
| A100 1枚 | 23.33n = 1 | 14.20n = 1 | 1.64倍 |
| A100 2枚 | 15.61n = 1 | 12.07n = 2 11.85–12.29 | 1.29倍 |
| A100 4枚 | 14.63n = 2 14.50–14.76 | 11.10n = 2 11.10–11.10 | 1.32倍 |
CPU比(公開CPU 64物理コア基準)。1枚で公開GPU版は1.52倍、改良GPU版は2.50倍。2枚で公開GPU版は2.28倍、改良GPU版は2.94倍。4枚で公開GPU版は2.43倍、改良GPU版は3.20倍。
収束までにかかった時間と再構成の一致度
RELIONは粒子を独立した二組に分け、それぞれから立体像(半マップ)を組み立てる。二つがどの細かさまで一致するかを周波数帯ごとに測ったものがフーリエ殻相関(FSC)である。
反復上限99で開始し、RELIONが自動収束を記録して最終の独立半マップ2個を出力した組だけを集計した。GPUの並列加算やMPIの粒子割り当てで収束反復が変わるため、所要時間と反復回数を併記する。全105,247粒子のCPUおよびGPU枚数別の結果は自動収束の比較表に示す。
| 入力・GPU | 公開版(秒・反復) | 改良版(秒・反復) | 倍率 | 平均マップ相関 |
|---|---|---|---|---|
| 2,048粒子・120画素・GPU 4枚astra4 各1試行 | 39.93秒・17回 | 35.27秒・17回 | 1.13倍 | 0.993328 |
| 16,384粒子・120画素・GPU 4枚astra10 各1試行 | 276.42秒・18回 | 242.77秒・17回 | 1.14倍 | 0.997195 |
| 16,384粒子・120画素・GPU 4枚astra16 各1試行 | 276.42秒・18回 | 102.74秒・17回 | 2.69倍 | 0.997217 |
| 105,247粒子・120画素・GPU 4枚astra16 各1試行 | 1,572.33秒・22回 | 495.32秒・22回 | 3.17倍 | 0.999973 |
2,048粒子・120画素・astra4では、対応する二つの半マップの相関は 0.98676、0.99177。マスクなしの半マップFSCが0.143を下回る分解能は、公開版10.69 Å、改良版10.71 Å。
16,384粒子・120画素・astra10では、対応する二つの半マップの相関は 0.99455、0.99474。両方とも計測範囲内にFSC 0.143の下降交点はなかった。
16,384粒子・120画素・astra16では、対応する二つの半マップの相関は 0.99455、0.99482。両方とも計測範囲内にFSC 0.143の下降交点はなかった。
105,247粒子・120画素・astra16では、対応する二つの半マップの相関は 0.99995、0.99994。両方とも計測範囲内にFSC 0.143の下降交点はなかった。
16,384粒子について、開始から同じ第15反復の出力が完了するまでを比較すると、公開版165.83秒、改良版90.22秒(1.84倍)。各実行のファイル更新時刻から求めた。
16,384粒子の収束後、対応する粒子の向きの差は中央値0.202度、95パーセンタイル0.818度、最大179.93度。位置の差は中央値0.441 Å、最大46.08 Å。マップ全体の高い相関と、個別粒子の一致度は別々に確認した。
公開版と改良版の対応する半マップ同士を比較したとき、最も細かい殻(8.04 Å)のFSCは、それぞれ0.906、0.912だった。
105,247粒子について、開始から同じ第15反復の出力が完了するまでを比較すると、公開版510.44秒、改良版334.63秒(1.53倍)。各実行のファイル更新時刻から求めた。
全粒子の第19〜21反復を合計すると、公開版660.37秒、改良版73.66秒で8.97倍。方向を細かく探す終盤で短縮幅が大きくなった。計測は第18反復の出力完了から第21反復の出力完了まで。
105,247粒子の収束後、対応する粒子の向きの差は中央値0.000度、95パーセンタイル0.272度、最大179.76度。位置の差は中央値0.000 Å、最大77.00 Å。マップ全体の高い相関と、個別粒子の一致度は別々に確認した。
向きの差が1度を超えた粒子は449個、90度を超えた粒子は100個だった(全105,247個)。
公開版と改良版の対応する半マップ同士を比較したとき、最も細かい殻(8.04 Å)のFSCは、それぞれ0.998、0.998だった。
後半の同じ反復だけを再計算した結果
16,384粒子、120×120画素、GPU 4枚。全版で公開版が保存した第14反復の同じ状態から再開し、第15反復を1回計算した。再開時の読み込みと終了処理も計測した。
| 版 | 実時間(秒) | 公開版比 | 平均マップ相関(初回) |
|---|---|---|---|
| native | 42.40n = 1 | 1.00倍 | — |
| astra13 | 39.40n = 1 | 1.08倍 | 1.000000 |
| astra15 | 41.78n = 1 | 1.02倍 | 1.000000 |
| astra16 | 10.34n = 1 | 4.10倍 | 1.000000 |
| astra17 | 9.39n = 1 | 4.52倍 | 1.000000 |
| astra18 | 10.05n = 1 | 4.22倍 | 1.000000 |
改良版15では向き候補をGPUで採点する方法を変えた。改良版16では改良版14に戻り、C1対称の局所探索で、向きの候補を表す単位ベクトルを各粒子について作り直す計算を省いた。C1は試料に回転対称性を仮定しない設定で、この変更は他の対称性には適用しない。角度の一覧が変わった場合は再計算する。54通りの事前分布の検証では元と同じ43,290個の方向インデックスを選び、確率の最大絶対差は8.1×10⁻¹⁵未満だった。
第15反復後、16,384粒子すべてで半分割の割り当てが一致した。出力された3つの向き角がすべて一致したのは16,382粒子。向きの最大差は0.234度、位置の最大差は0.603 Å。
どこを変えたか
- GPU処理の完了を確認するCUDAイベントを再利用した。4,096粒子・3反復のNsight Systems計測では、1つのMPIワーカーで公開版のイベント生成407,600回が、中間の改良版3で231回になった。プロファイラを有効にした時間は比較表に含めていない。
- 向きと平行移動を探索するとき、複数の移動候補で同じ投影を再利用した。粒子の重みを選ぶための集計はGPUで終えて、CPUとの同期回数を減らした。
- 立体像を組み立てる段階で、3次元逆FFT、切り出し、マスク、補正をGPU側に移した。倍精度のcuFFTを使い、GPUのメモリを確保できないときは元のCPU経路を使う。
同じ第15反復をLinux perfで調べると、公開版の1ワーカーではCPUサンプルの12.91%を三角関数の計算(sincos)が占め、メモリ確保と解放も上位に並んだ。改良版16では、Nsight Systemsの同じ1ワーカーで、GPUカーネル時間の約59%を粒子と候補投影の差を計算する粗探索が占めた。これはGPUでカーネルが動いた時間に占める割合で、実行全体の割合とは異なる。
元の360×360画素、全105,247粒子の第3反復では、対応する二つの半マップの相関は0.999988、0.999987。両半マップの平均像の相関は0.999994だった。
全粒子の3反復では、どの区間が縮んだか
4枚GPUの初回試行について、反復ごとの最終出力ファイルの更新時刻から区間を推定した。各区間には計算、通信、出力が含まれる。
| 区間 | 公開版(秒) | Astra改良版13(秒) |
|---|---|---|
| 初期化と初期出力 | 11.97 | 5.42 |
| 第1反復 | 40.63 | 12.47 |
| 第2反復 | 19.94 | 10.55 |
| 第3反復 | 19.67 | 10.48 |
| 最終出力から終了まで | 1.18 | 0.69 |
改良版13は、対応するMRCスタックの読み取り専用ページをMPIランク間で共有する。公開版は各ランクで別々に画像を保持する。MPIプロセスの共有分を按分した使用メモリ(PSS)の合計は、最初の期待値計算中のサンプルで公開版約52.6 GiB、改良版約5.35 GiBだった。
測定条件と範囲
- 開発元の安定版 RELION 5.0.1(d476e6f)。NVIDIA A100 PCIe 80 GB × 4、Xeon Gold 6430 × 2、各32物理コア、SMT無効。CPU実行は32物理コアまたは64物理コアに固定した。
- 公開版と改良版は同じGCC・CUDA 12.9・Open MPI環境でA100向けsm_80に最適化してビルドした。CPU版はRELIONのALTCPU経路とAVX対応のネイティブ最適化を使用した。GPUの粒子探索は単精度、ホスト側と移植した3次元FFTは倍精度。
- 主要な固定反復の表ではGPUごとにMPIワーカー2個、リーダー1個、CUDA MPSを共通使用。ワーカー当たりのスレッドはGPU 1・2・4枚で順に4・2・4。CPUは8ワーカーで合計32または64スレッド。コア配置、CUDA予約メモリ量、MPSなど実行設定による差はAstraの上積みに算入していない。
- 開始参照EMD-2660を60 Åに低域通過処理し、C1対称、CTF補正、自動精密化、固定した半分割と乱数シード10028を使用した。各構成で同じ粒子、参照像、画素サイズ、精度設定を使った。平行移動の初期探索範囲は5画素。120画素入力では20.1 Å、360画素入力では6.7 Åであり、両画素サイズはそれぞれ別の試験として比較した。固定反復の表は初期反復だけを測る。原論文の最終分解能の再現は今回の評価項目に含まれない。
- 入力と出力は同じサーバーのメモリ上のファイルシステムに置いた。壁時計の計測には画像読み込み、初期化、MPI通信、全反復、出力を含めた。データ取得、サイズ変換、コンパイルは事前に行った。公開版5.1.1タグのGPUはこの環境で初回反復に失敗したため、5.0.1と同一タグに対する改良を比較した。
初回計測は2026年11月15日14時まで。その後の追加測定は自動収束まで行った。完走した試行のみ速度表に含めた。入力の転送待ちに制御用Macがスリープした時間は、各試行の実時間に含まれない。全粒子・初期3反復のCPU 64コア試行および全粒子GPU 4枚の公開版収束試験の冒頭は、優先度を下げたコンパイルと短時間重なった。元画素での全粒子試験と、画素を縮小した収束試験は別の入力条件である。
元の360×360画素、4,096粒子の収束試験は、公開版が549.71秒で完走した。改良版16は14時の最終再構成中に停止したため、この入力の収束までの倍率は未確定。
制限時間で中断した試行は実時間の集計から除外した。個別のラベルおよび終了コード124は測定CSVに記録した。
開発元のRELION 5.0.1リリース EMPIAR-10028の粒子画像 参照マップ EMD-2660 試料の原論文