OpenFOAM、5.33倍からCPU比8.73倍へ|10倍に挑んだ24時間【OpenAIのAstraでHPC高速化・コード無料提供】
OpenFOAMの6,533万セルをA100 4枚で、CPU64コア比5.33倍から8.73倍へ。10倍を目指した追加24時間と、公開GPU版がホストRAM上限で停止した比較結果を総括。高速化コードは無料提供します。
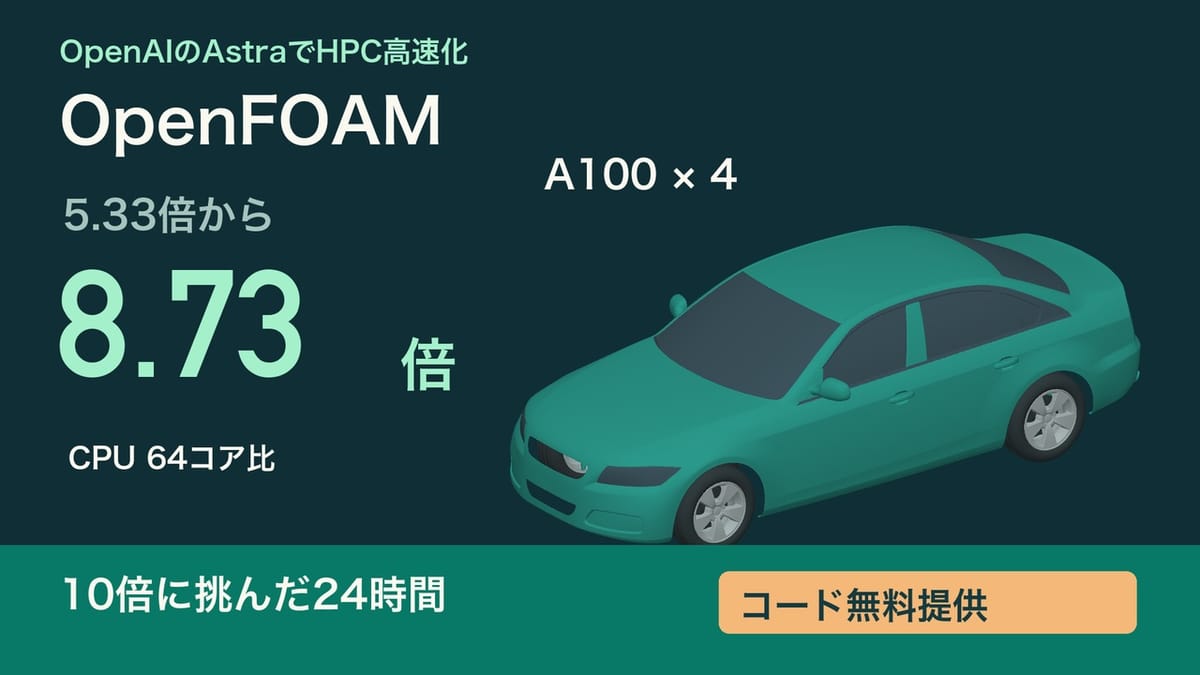
A100を4枚使い、CPU 64物理コアの1時間48分40秒を12分27秒へ。
その先を目指して追加検証した結果と、いま伝えたい到達点。
以前公開したOpenFOAMの動画では、CPU 64コアに対する5.33倍の高速化を紹介した。その後、同じ4枚のA100で8.73倍に到達している。今回まずお伝えしたいのは、この現在の成果だ。
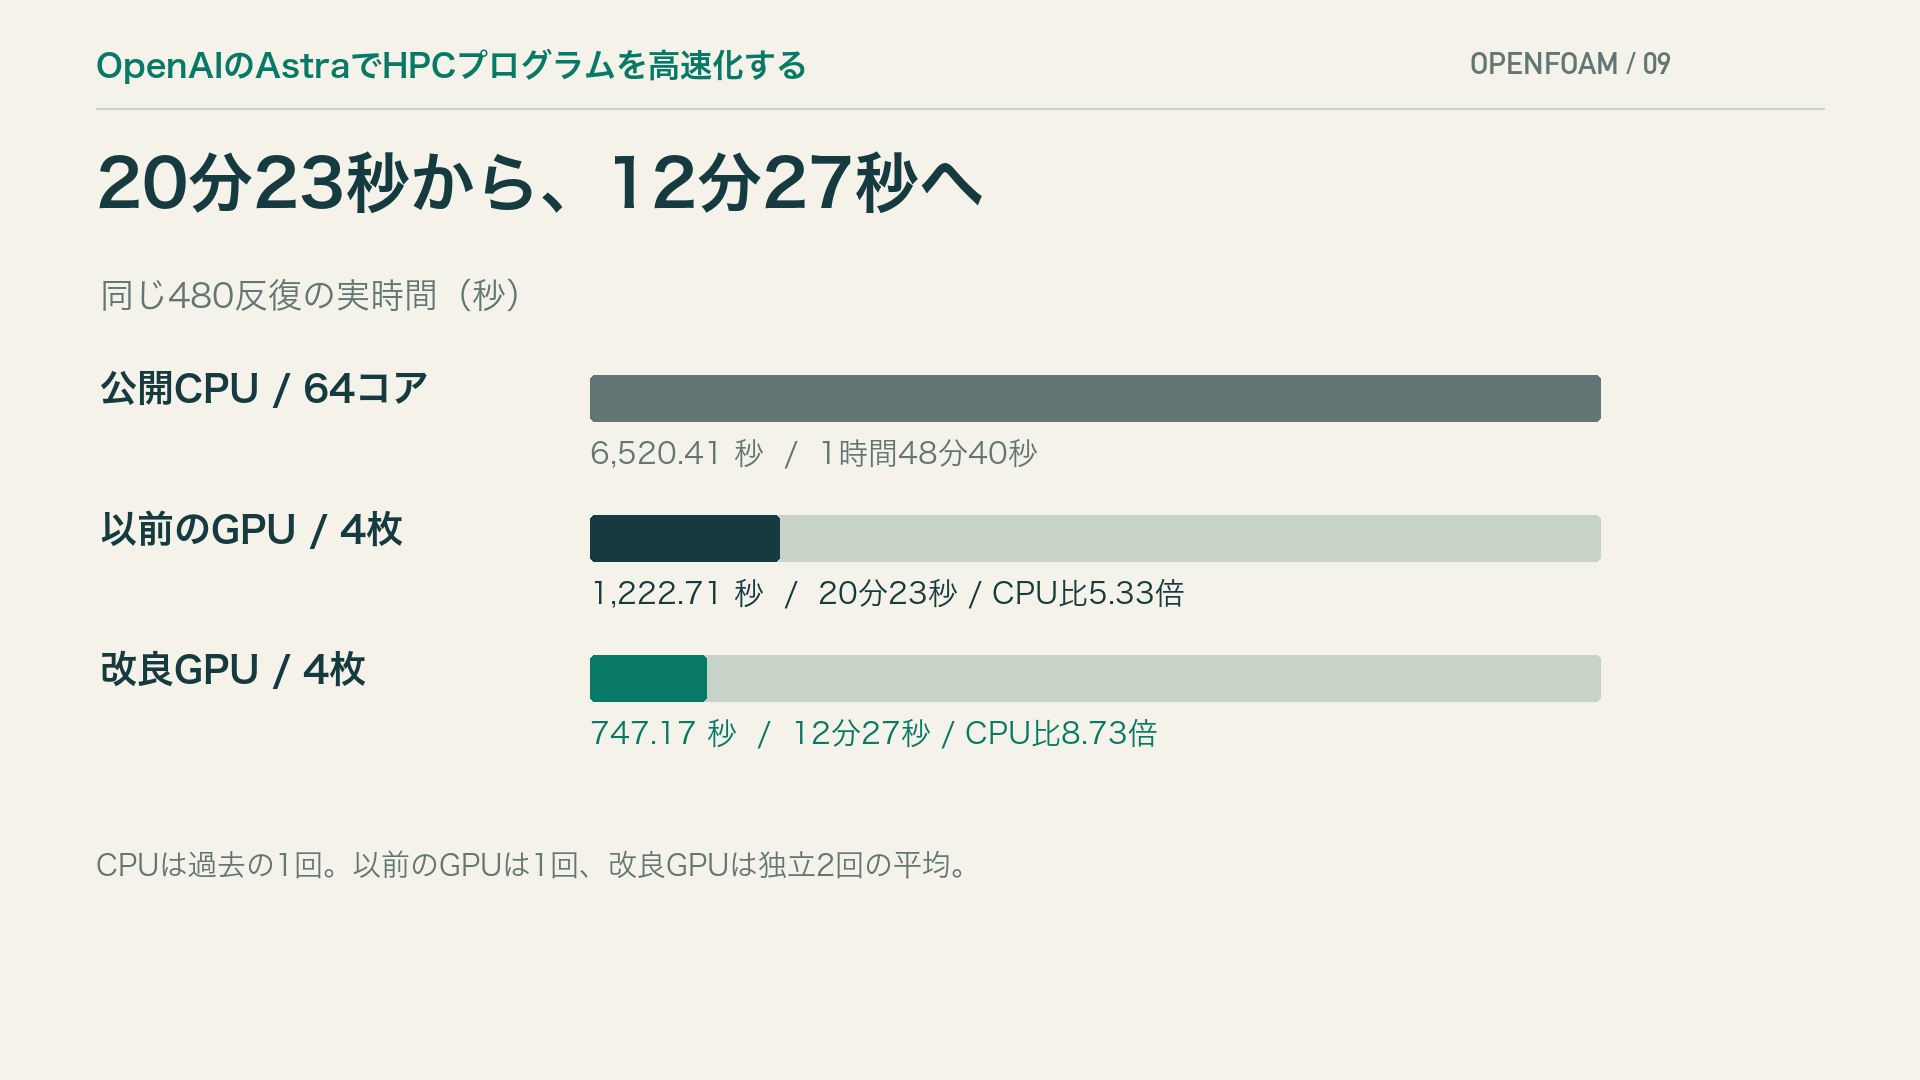
5.33倍の構成で20分23秒だった計算は、12分27秒になった。GPUを増やさず、計算時間をさらに約39%短縮したことになる。ここでいう倍率は、同じ入力から固定した480反復を進める実時間の比であり、必要な精度に収束するまでの時間比ではない。
なぜ、もう一度OpenFOAMなのか
最近公開した動画の再生数を見ると、以前の5.33倍のOpenFOAM動画がよく見られていた。視聴時間や視聴者維持率までは確認していないため、関心の強さを断定はできない。それでも、OpenFOAMを使う方にこの取り組みを届ける価値があると感じた。
そして、以前の動画だけを見て、5.33倍がServer Gearの現在の到達点だと思われてしまうのは惜しい。すでに得られた8.73倍を伝えたい。同時に、ここから10倍を目指せないかも確かめたい。その二つが、追加24時間の検証を始めた理由である。
6,533万セルの車体まわり流れを、同じ480反復で比べる
対象はDrivAerという自動車形状の周囲を空気が流れる計算だ。格子数は65,334,765セル。OpenFOAM v2606のsimpleFoamを基準に、定常・非圧縮のRANS計算をk–ω SST乱流モデル、倍精度(FP64)で実行した。GPU側はOpenFOAM-ECSEの公開GPUコード(v2606、コミット559823f7d1b8)を土台とした改良コードである。
400反復目の保存状態を共通の出発点として、401〜880反復の480反復を測る。計時はMPI起動から終了までで、初期化と途中4回の場の書き出しを含む。格子の分割と並べ替えは含めない。線形ソルバーの反復設定もそろえ、速度成分は各15回、圧力は12回、最粗格子PCGは35回、乱流のkとωは各8回とした。
CPUはXeon Gold 6430を2基、合計64物理コア・64 MPIランク。GPUはA100 PCIe 80 GBを4枚で、8.73倍の構成は4 MPIランクで動かした。ここでの車体画像は、実験に使ったメッシュを投影・着色したものだ。
CPU比8.73倍と、公開GPU版からの上積みを分ける
シリーズ共通の形式で、今回比較できた構成を示す。表中の「未測定」は、上記の入力・精度・計測区間での実測がないことを表す。
| 実行構成 | 開発元の公開版 | Astra改良版 | 同じ構成での高速化倍率 |
|---|---|---|---|
| CPU 32物理コア | 未測定 | 未測定 | 算出不可 |
| CPU 64物理コア | 6,520.41 秒 | 独自改良なし | — |
| GPU 1枚 | 未測定 | 未測定 | 算出不可 |
| GPU 2枚 | 未測定 | 未測定 | 算出不可 |
| GPU 4枚 | 完走不可 ※ | 747.17 秒 | 算出不可 |
※ 公開GPU版4枚はホストRAMの保護上限470 GiBで停止。詳しくは次節に記載。画面幅が狭い場合は、表を左右にスクロールできます。
CPU 64コアは過去の1回の実測。Astra改良版4 GPUは独立2回(747.678秒、746.664秒)の算術平均747.171秒。CPU 32コアとの優劣は未評価で、今回のCPU基準は実測のある64コアである。
GPU化の効果(公開CPU版÷公開GPU版)と、Astraによる上積み(同じGPU枚数の公開版÷改良版)は、公開GPU版の同条件での480反復の完走時間がないため算出できない。8.73倍は公開CPU版から改良GPU版までの総合倍率である。過去の開発途中のGPU構成も、未改変の公開GPU版としては扱わない。
公開GPU版4枚は、なぜ完走できなかったのか
追加24時間の検証を終えた後、比較のために、Astraの追加コードを読み込まない公開GPU版も4枚・4 MPIランクで試した。使用したのはOpenFOAM-ECSE v2606のfeature-gpuブランチ(コミット559823f7d1b8)。A100向けのビルド設定と、公開版が受け付ける入力設定を使った。
まず12反復の動作確認を行ったが、最初の反復中にホストRAMの保護上限470 GiBに達し、OSのメモリ保護によって停止した。サーバーの使用可能RAMは約503 GiBで、保護上限はOSなどの余裕を残すために設けたものだ。停止理由を示すoom-killとメモリ使用量をログで確認している。480反復の本測定には進めなかった。
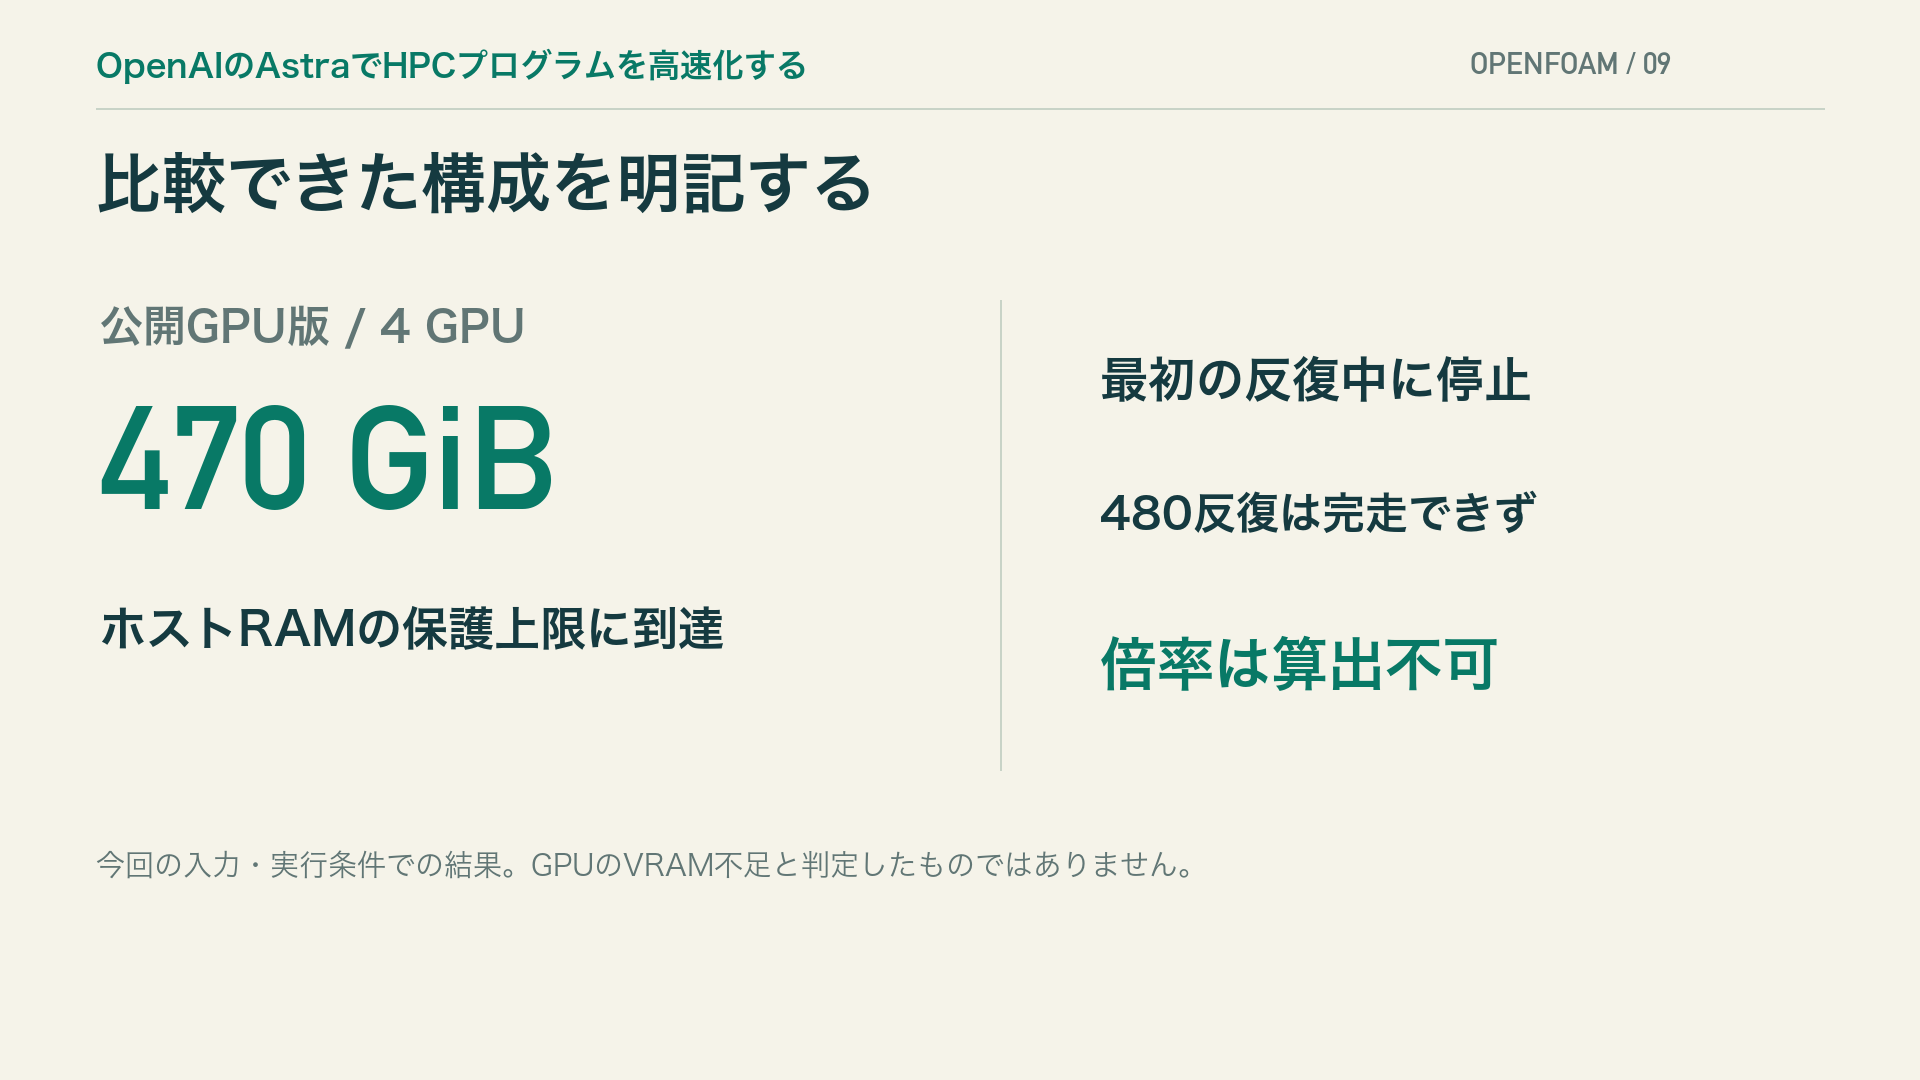
そのため表には「完走不可」と記録した。これは今回の6,533万セルの入力と実行条件での結果であり、公開GPU版が常に4枚で動かないという意味ではない。設定を変えた追加試行は途中で終了し、無理に実行を重ねることは避けた。公開GPU版1枚・2枚は未測定である。
Astra改良版については、2枚で12反復を正常終了した(115.38秒、1回)。この短い区間の力係数は従来の4枚構成と一致した。1枚は動作確認中にエラーが発生し、原因の確定には至っていない。1枚・2枚とも480反復の本測定は未実施のため、表に短い試験の時間を混ぜていない。これらの比較試験は、後述する24時間・218件の検証とは別の記録である。
5.33倍から8.73倍へ、何を積み重ねたか
最初は、境界にある面とセルの対応を何度も調べる処理や、CPUとGPUの間を往復するデータに着目した。対応関係を再利用し、圧力や乱流計算でのデータの扱いも見直す。その後、GPU一枚あたりのMPIランク数、格子の並び方、隣接セル番号の表現、圧力計算の作業配列などを調整した。
一つの魔法のような変更で8.73倍になったわけではない。プロファイルで時間のかかる処理を調べ、変更し、計算結果を照合してから全体の時間を測る。その積み重ねで、以前の1,222.71秒から747.17秒へ進んだ。旧GPU構成に対しては約1.64倍、所要時間では38.9%の短縮である。詳しい経緯は5.33倍までの記録と8.73倍の計測・数値比較に掲載している。
10倍まであと約95秒。追加24時間で試したこと
CPU比10倍に必要なのは652.04秒。747.17秒からさらに95.13秒、約12.7%を削る必要がある。2026年11月17〜18日の検証枠では、自動計測による候補探索と、対話の中での分析・コード変更を組み合わせた。短い試験、480反復の完走、プロファイル取得など、完了した計測は合計218件だった。218個の独立した高速化案や、218回すべての完走を意味する数字ではない。
隣接セルの値を読む二つのGPU処理は、観測したカーネル実行時間の合計の約28%を占めていた。これは計算全体の実時間の28%という意味ではない。この処理のセル番号の圧縮や読み出し方、メモリ確保、GPU処理の実行設定などを試した。
壁までの距離を再利用する案は、短い試験では起動時間が縮んだ。しかし480反復を完走させると、代表的な二案の各2回平均は754.50秒と760.75秒。起動時の改善だけでは、全体の短縮につながらなかった。セル番号やGPU実行設定にも約745秒の候補はあったが、今回の検証では、狙った大きさの安定した改善を確認できなかった。
744.68秒という途中記録を、更新記録にしなかった理由
GPUの実行設定を変更した候補は、最初の2回で744.49秒と744.87秒となった。その平均が、途中で報告した744.68秒、CPU比8.76倍である。しかし、3回目は748.31秒だった。
| 構成 | 1回目 | 2回目 | 3回目 | 算術平均 |
|---|---|---|---|---|
| 従来の8.73倍構成 | 747.89秒 | 746.36秒 | 745.58秒 | 746.61秒 |
| 設定変更案 | 744.49秒 | 744.87秒 | 748.31秒 | 745.89秒 |
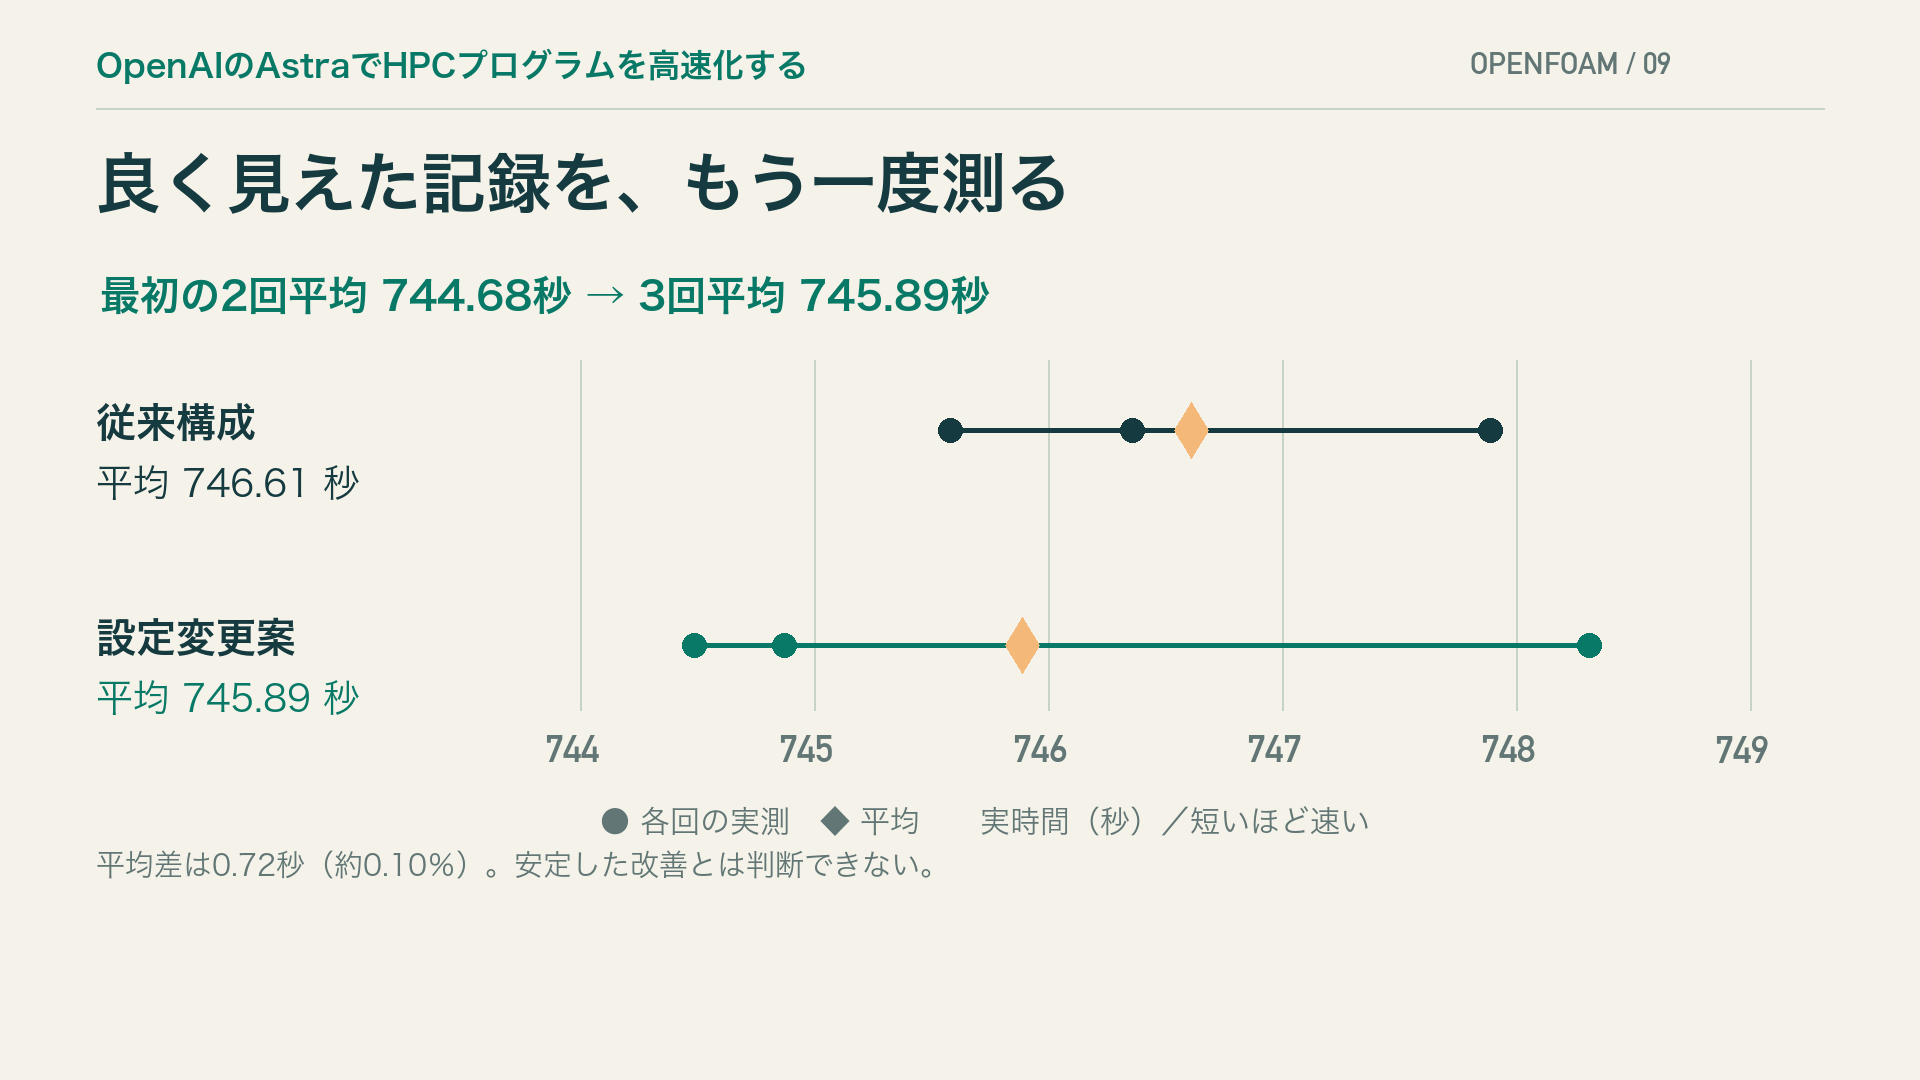
3回平均の差は約0.72秒、約0.10%に縮まる。各構成で観測されたばらつきと重なる小さな差であり、安定して速くなったと結論づける根拠には足りない。そのため今回の見出しは8.76倍とせず、従来の2回平均で確認し、今回も同程度の時間を再確認したCPU比8.73倍を中心にした。
最後に、GPU間の境界通信の待ち方も変えた
格子をGPUごとに分けると、境界の値を隣の領域と交換する必要がある。最後は、GPUの準備完了を待っている間にも受信処理を進める案と、送信を先に始める案を実装した。
短い試験では、力係数、線形ソルバーの残差、反復回数が従来構成と一致した。受信処理を進める案を480反復で測ると746.55秒(1回)。840反復目のU、p、k、ω、nut、phiの6種類×4領域、計24ファイルも従来GPU構成とバイト単位で一致した。数値を変えずに動かすことはできたが、大きな時間短縮にはならなかった。
「現在の到達点に近い」と判断する範囲
追加24時間の検証では、8.73倍を大きく上回る安定した成果は得られなかった。今回のハードウェア、入力、計測条件と、試した改良の範囲では、8.73倍付近が現在の方針での到達点に近いと判断している。これはOpenFOAM全般の限界や、数学的な最速値を証明したという意味ではない。
さらに大きな短縮を目指すなら、通信と計算の組み合わせ方など、実装の方針を立て直す必要がありそうだ。Astraを使っても、設計、実装、数値検証には時間がかかる。何日あれば10倍になるか、現時点で約束できる材料はない。
もう一つ、速度と一緒に伝えるべき点がある。CPU版とGPU版の840反復目の速度場は完全には一致していない。各セルを等しく数えた相対L2差は19.35%、セル体積で重みを付けると0.352%だった。後者だけを示して差を小さく見せることはできない。抗力・揚力の定常判定も満たしておらず、設計に必要な精度に達するまでの速さは別途評価が必要だ。
それでも、同じ480反復の実時間を1時間48分40秒から12分27秒に縮めた事実は変わらない。以前の5.33倍から進んだ8.73倍という到達点と、その先を試してわかったことを、今回の総括としてお伝えしたい。
計測記録・図版の出典
追加検証の218件の結果、3回の再確認、過去のCPU・GPU実測値と、今回の公開GPU版の停止記録を 計測記録ZIP に収録。24時間の計測一覧CSVと構成別の比較表CSVも用意した。短い試験は反復数が異なるため、480反復の実時間と直接比較しない。
車体メッシュ:Mark Wasserman・Sergey Lesnik, OHC-1 mesh files(CC BY 4.0)。Server Gearが投影・着色。ブログと動画の図表は計測ログをもとに作成した。動画の日本語ナレーションにはOpenAIのAI音声Marinを使用している。