衝撃波を追うGPU、2枚と4枚のどちらが速い?|AthenaK|OpenAIのAstraでHPCプログラムを高速化する 第6回
2枚のA100で6.06秒。もう2枚加えたら、6.37秒になった。ところが、大きい格子で同じ種類の衝撃波を追うと、今度は2枚で19.12秒、4枚で15.95秒。GPUを増やすと得をするのは、どんなときだろう。
2枚のA100で6.06秒。もう2枚加えたら、6.37秒になった。ところが、大きい格子で同じ種類の衝撃波を追うと、今度は2枚で19.12秒、4枚で15.95秒。GPUを増やすと得をするのは、どんなときだろう。
衝撃波の右端がへこむ
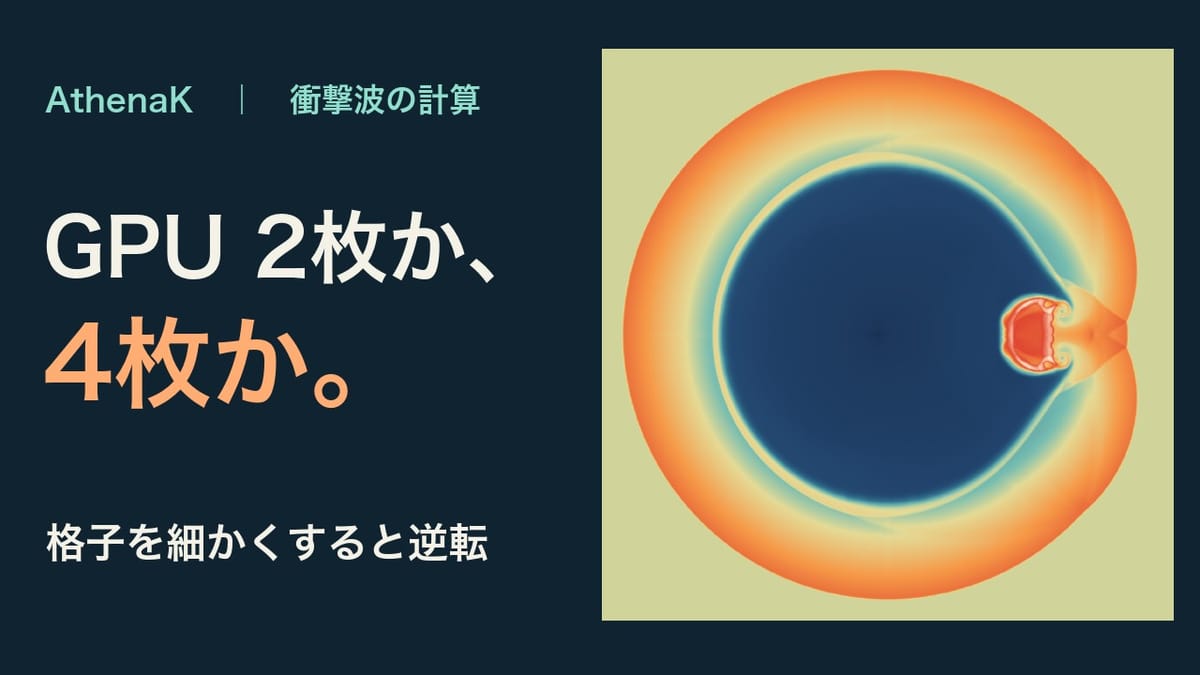
天体物理向けシミュレーションコードのAthenaK(アテナ・ケー)で、中央だけ圧力が高いガスを用意した。ガスが膨張し、周囲を押し縮めながら衝撃波が外へ広がる。左の映像では、密度の高くなった部分が丸い輪を描く。右に置いたのは、周囲と同じ圧力で密度だけが10倍の、小さなガスの塊だ。
輪の右端は塊にぶつかるとへこみ、両脇の波が先へ回り込む。細かく計算したい場所も、これと一緒に動く。AthenaKは格子をブロックにまとめ、密度が急に変わるところだけ細かく分割できる。今回手を入れたのは、そのブロック同士が境目で値を渡す処理だった。
まず、開発元のGPU版はどれだけ速いか
基本格子を768×768にし、ガス塊ありの問題を公開版で解いた。CPUは32物理コアで67.89秒、64物理コアで38.54秒。A100を1枚使うと15.72秒で、開発元のGPU化によってすでに2.45倍の速さが出ている。
| 実行構成 | 開発元の公開版 | Astra改良版 | 同じ構成での高速化倍率 |
|---|---|---|---|
| CPU 32物理コア | 67.89 秒 | 独自改良なし | ― |
| CPU 64物理コア | 38.54 秒 | 独自改良なし | ― |
| A100 1枚 | 15.72 秒 | 7.45 秒 | 2.11倍 |
| A100 2枚 | 10.45 秒 | 6.06 秒 | 1.72倍 |
| A100 4枚 | 9.59 秒 | 6.37 秒 | 1.50倍 |
GPU各5回・CPU各3回の中央値。公開GPU版のCPU比は1・2・4枚の順に 2.45 / 3.69 / 4.02 倍。最速の改良版はCPU比 6.36 倍。
同じ1枚のままAstraの改良を加えると、15.72秒が7.45秒になった。独自改良の効果は2.11倍だ。気になるのはその先だ。初回は各5回の中央値で2枚が4枚を0.31秒上回った。ところが、時間を空けて公開版と改良版を交互に各3回走らせると、改良版は2枚が6.43秒、4枚が6.30秒。こちらは4枚が0.13秒早かった。この入力での2枚と4枚は、それくらいの接戦だった。
隣のブロックが次に読む場所へ書く
ブロックの端にあるセルを更新するには、隣のブロックの値も要る。隣同士が同じGPUにあり、格子の細かさも同じなら、渡す値はいったん別のバッファに詰めなくてもよい。改良版は、相手が次に読み出す場所へ直接書き込むようにした。
もう一つ、いったん格子が決まると、細分化や担当GPUの変更が起きるまで、値を渡す相手は変わらない。そこで格子を組み替えたときに相手の一覧を作り直し、途中のステップでは必要な境界だけをGPUに割り当てた。セルの状態を次の時刻へ進める処理でも、各セルが隣の面を通る流れを読み、自分の値を更新するようにして、行ごとの待ち合わせを減らした。
この変更はGPUの記録にも表れた。均一なガスをA100 1枚で同じ区間だけ計算し、Nsight Systemsでカーネル時間を集計すると、境界データの受け渡しは437.3ミリ秒から83.9ミリ秒、セルの状態更新は301.1ミリ秒から89.7ミリ秒になった。計測区間は時刻0.016までで、表の実時間とは別の測定である。
| 実行構成 | 開発元の公開版 | Astra改良版 | 同じ構成での高速化倍率 |
|---|---|---|---|
| CPU 32物理コア | 62.90 秒 | 独自改良なし | ― |
| CPU 64物理コア | 34.59 秒 | 独自改良なし | ― |
| A100 1枚 | 14.16 秒 | 6.51 秒 | 2.18倍 |
| A100 2枚 | 9.55 秒 | 5.38 秒 | 1.77倍 |
| A100 4枚 | 8.76 秒 | 5.70 秒 | 1.54倍 |
GPU各5回・CPU各3回の中央値。公開GPU版のCPU比は1・2・4枚の順に 2.44 / 3.62 / 3.95 倍。最速の改良版はCPU比 6.43 倍。
ガス塊を取り除いた上の表でも、1枚の公開版14.16秒が6.51秒になり、2.18倍に達した。やり取りする値がそろっている必要はない。ガス塊の有無をまたいで使い回せたのは、計算格子が同じ間の通信先の一覧だ。
4枚が先に終わった条件
ガス塊を置いたまま基本格子を縦横それぞれ2倍の1536×1536に広げ、時刻0.08まで計算した。この表では公開版も改良版も同じ時刻に終了する。先ほどの表は時刻0.12までなので、所要時間の総量を比べるときには終了時刻の違いも効く。
| 実行構成 | 開発元の公開版 | Astra改良版 | 同じ構成での高速化倍率 |
|---|---|---|---|
| CPU 32物理コア | 325.13 秒 | 独自改良なし | ― |
| CPU 64物理コア | 168.51 秒 | 独自改良なし | ― |
| A100 1枚 | 70.16 秒 | 29.86 秒 | 2.35倍 |
| A100 2枚 | 39.83 秒 | 19.12 秒 | 2.08倍 |
| A100 4枚 | 29.97 秒 | 15.95 秒 | 1.88倍 |
全構成各3回の中央値。公開GPU版のCPU比は1・2・4枚の順に 2.40 / 4.23 / 5.62 倍。最速の改良版はCPU比 10.56 倍。
64コアの168.51秒から公開4枚版の29.97秒へ。ここまでがGPU化によるCPU比5.62倍。同じ4枚でAstraが29.97秒を15.95秒に縮めた分が1.88倍。最初から通したCPU比10.56倍は、この二つを合わせた数字だ。改良2枚の19.12秒とも、ここでは3秒以上の差がついた。
GPUを増やすと、1枚が受け持つセルは減る。一方、GPUをまたぐ境界では、隣のGPUへ値を渡す必要がある。このサーバーでは2枚をNVLinkでつなげられたが、4枚で直接通信を許す設定を試すと、計算結果に数値として扱えない値が生じた。4枚の表には、公開版と改良版の両方でCPU側メモリーを介し、結果の照合を通った構成を使った。この格子と通信経路で、細かい問題のほうが4枚に仕事を分ける利点を得やすかった、と読むのが妥当だ。
三次元でも同じ衝撃波が出たか
右の断面で輪の先端を追うと、その周りに小さな四角が現れる。一様に見える遠方には、大きな四角が残っている。球状に広がる波を三次元で解いたこの条件では、改良4枚版が4.13秒。公開4枚版の5.21秒に対する上積みは1.26倍だった。
| 実行構成 | 開発元の公開版 | Astra改良版 | 同じ構成での高速化倍率 |
|---|---|---|---|
| CPU 32物理コア | 116.81 秒 | 独自改良なし | ― |
| CPU 64物理コア | 61.71 秒 | 独自改良なし | ― |
| A100 1枚 | 11.01 秒 | 6.66 秒 | 1.65倍 |
| A100 2枚 | 6.73 秒 | 4.54 秒 | 1.48倍 |
| A100 4枚 | 5.21 秒 | 4.13 秒 | 1.26倍 |
全構成各3回の中央値。公開GPU版のCPU比は1・2・4枚の順に 5.60 / 9.17 / 11.85 倍。最速の改良版はCPU比 14.93 倍。
最後に、二次元の均一なガス、ガス塊あり、大きい格子、そして三次元の4問題で、最終時刻の再開用ファイルを突き合わせた。密度、運動量の3成分、全エネルギーを全実セルで調べると、GPU 1・2・4枚の全12条件で、公開GPU版と改良版の倍精度の値が全ビット一致した。
このサーバーで大きい二次元問題をもう一度解くなら、私は4枚を使う。2枚より3.17秒早く、同じ衝撃波を描き終えたからだ。768×768のガス塊なら、2枚で約6秒という結果にも価値がある。4枚を割り当てても、追試を含めて安定した時間短縮は得られなかった。
計測条件と公開ソース
CPUはXeon Gold 6430を2基使用。32物理コアは8 MPIプロセス×4スレッド、64物理コアは16×4。GPUはA100 PCIe 80 GBで1枚につき1 MPIプロセス。CPUは各問題で速かった64物理コアを基準にした。CPU独自改良は行っていない。
計算は倍精度の理想気体流体解析。ブロックは二次元で32×32、三次元で32×32×32。密度勾配による適応細分化を一段有効にし、PLM再構成、HLLC、RK2、CFL数0.3を使用した。中央の圧力は周囲の100倍。ガス塊の初期条件の生成コードは公開ソルバーにも改良ソルバーにも同じものを加えた。各表はMPI起動から初期・最終出力を含む終了までの実時間。倍率は丸める前の値から計算した。使用したAthenaKの公開ソース