AI・ローカルLLM
A100 x4で大型ローカルLLMはどこまで使えるか: 実際の質問と回答例で比較
A100 80GB x4のGPUサーバで複数のローカルLLMを動かし、導入説明、障害メモ、要約、ブログ構成という実務寄りの質問で回答の違いを比較しました。
AI・ローカルLLM
A100 80GB x4のGPUサーバで複数のローカルLLMを動かし、導入説明、障害メモ、要約、ブログ構成という実務寄りの質問で回答の違いを比較しました。
AI・ローカルLLM
GPUマキシマイザー開発の一環として、巨大なローカルLLMをA100 GPUサーバー上で動かし、GPU運用assistant、agent loop、実Fortran/CUDA高速化支援までを検証しました。
AI・ローカルLLM
A100 80GB×4でGLM-5.2 2bit GGUFをロード・生成・OpenAI互換API応答まで確認。さらにDS4/Qwen3-14Bと、Slurm導入前判断、NVIDIA driver再インストール要求、vLLM OOMなど6つのGPUサーバー運用タスクで比較しました。
AI・ローカルLLM
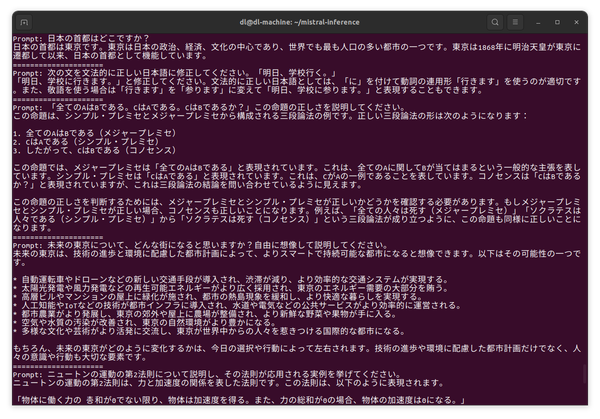
MIstral-NeMoはMIstral AI社が開発した12Bの大規模言語モデル(パラメーターの数が120億個)です。多言語で訓練されていますので、日本語でのやりとりも問題ありません。比較的入手が容易でそこまで高価でないGeForce RTX 4080...