128GBのGB10でGLMとQwenを比較:同じDwarfStar・Q2で測る品質と待ち時間
同じ128GB級GB10・同じDwarfStarでGLM Q2とQwen Q2を実務24問×3回比較。推論オン/オフの品質と待ち時間、Qwen Q4の追加結果、誤答と未完了まで公開します。
128GB級のマシンを1人で使うなら、GLM 5.3 FlashとQwen3.8 Flash Nextのどちらが実務に使いやすいのでしょうか。今回は1台のGB10機で、同じDwarfStarを使い、同じ実務24問の回答品質と待ち時間を比較しました。主比較はDwarfStar開発者が配布するQ2同士。Qwen Q4は量子化による違いを見る追加比較です。
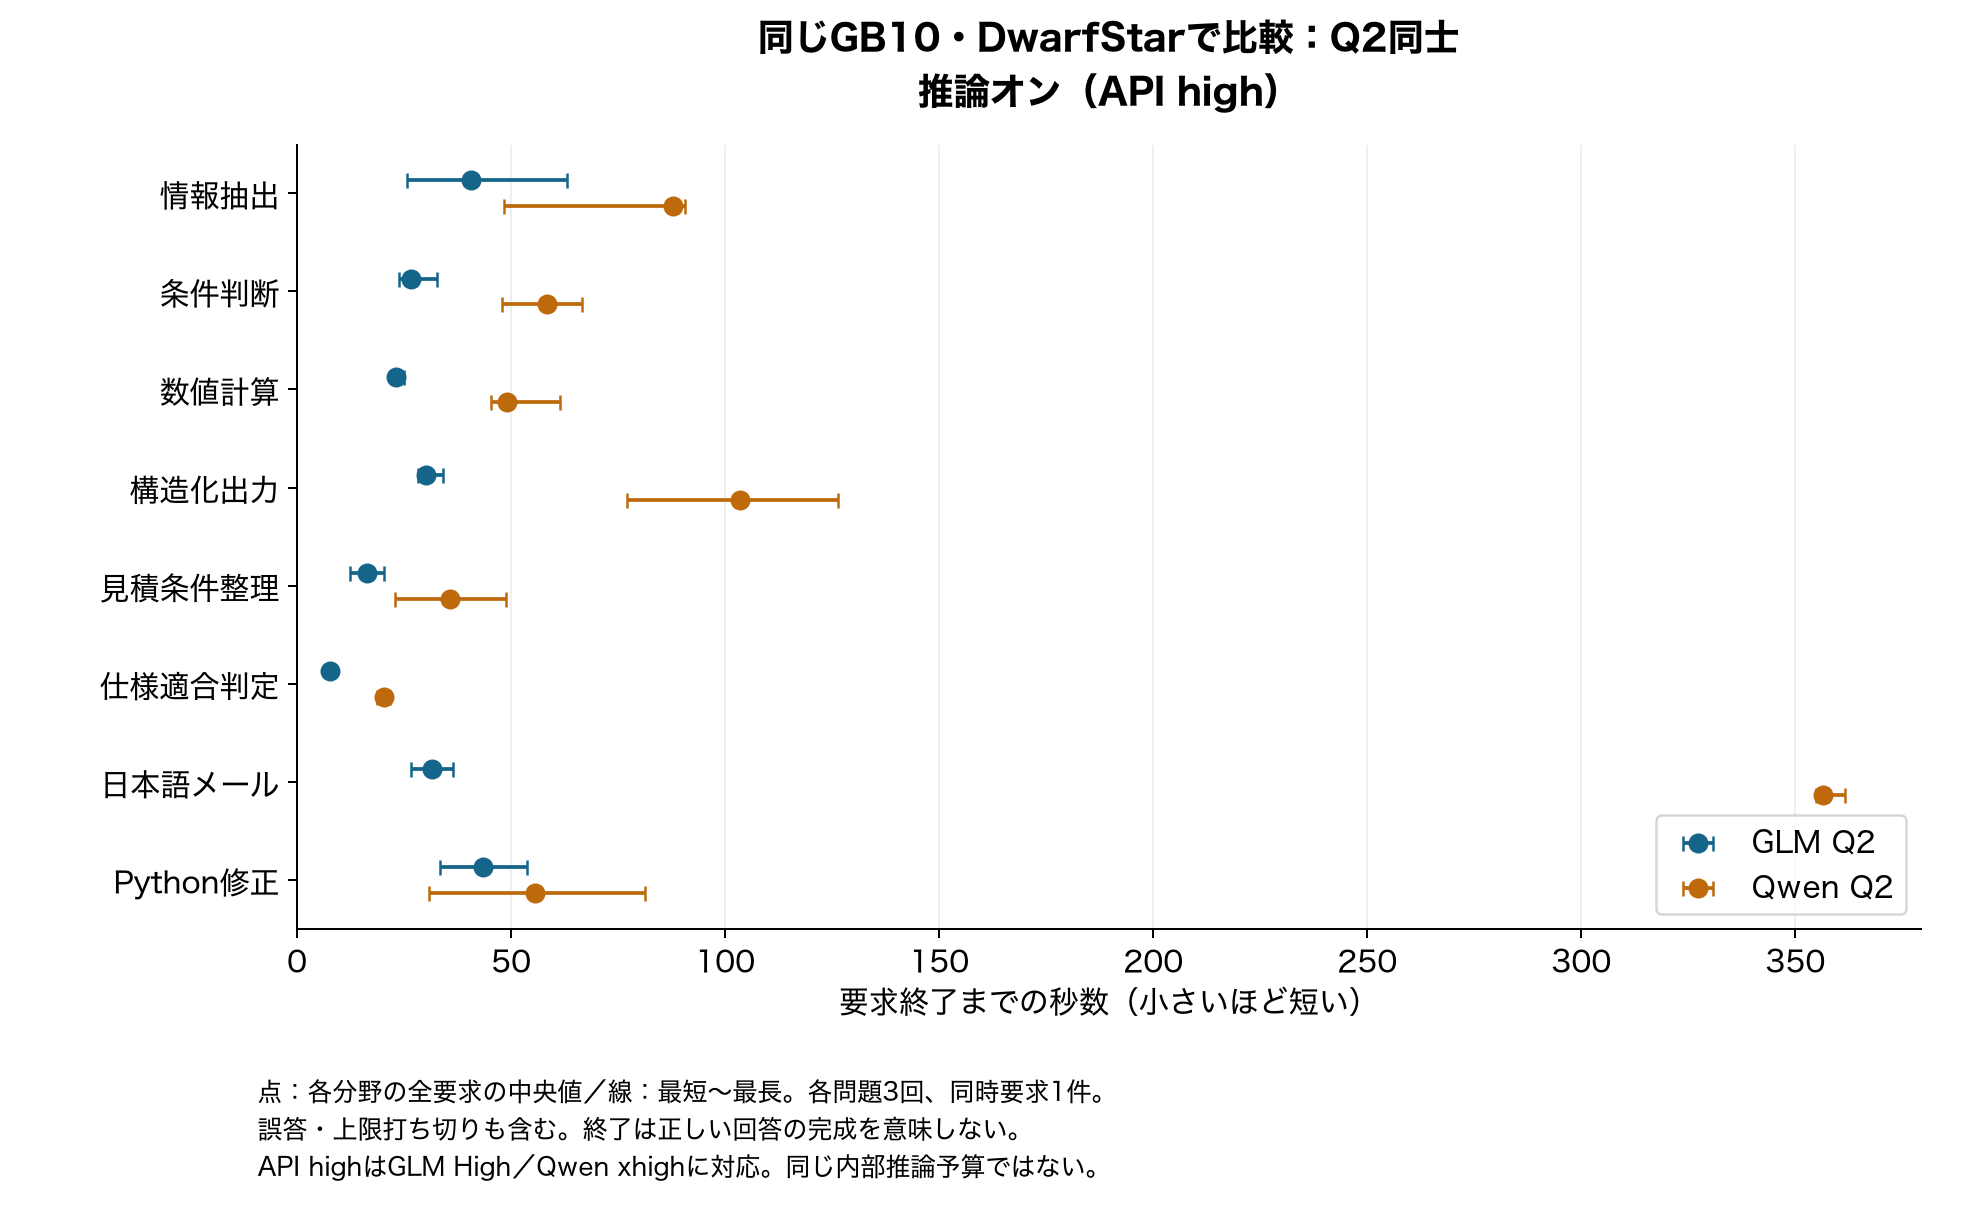
今回の条件では、推論オンのGLM Q2は要求終了までが短い一方、計算や説明の誤りがありました。Qwen Q2は構造化した課題で良好な結果が出ましたが、文字数を指定したメールでは出力上限まで思考が続く例がありました。
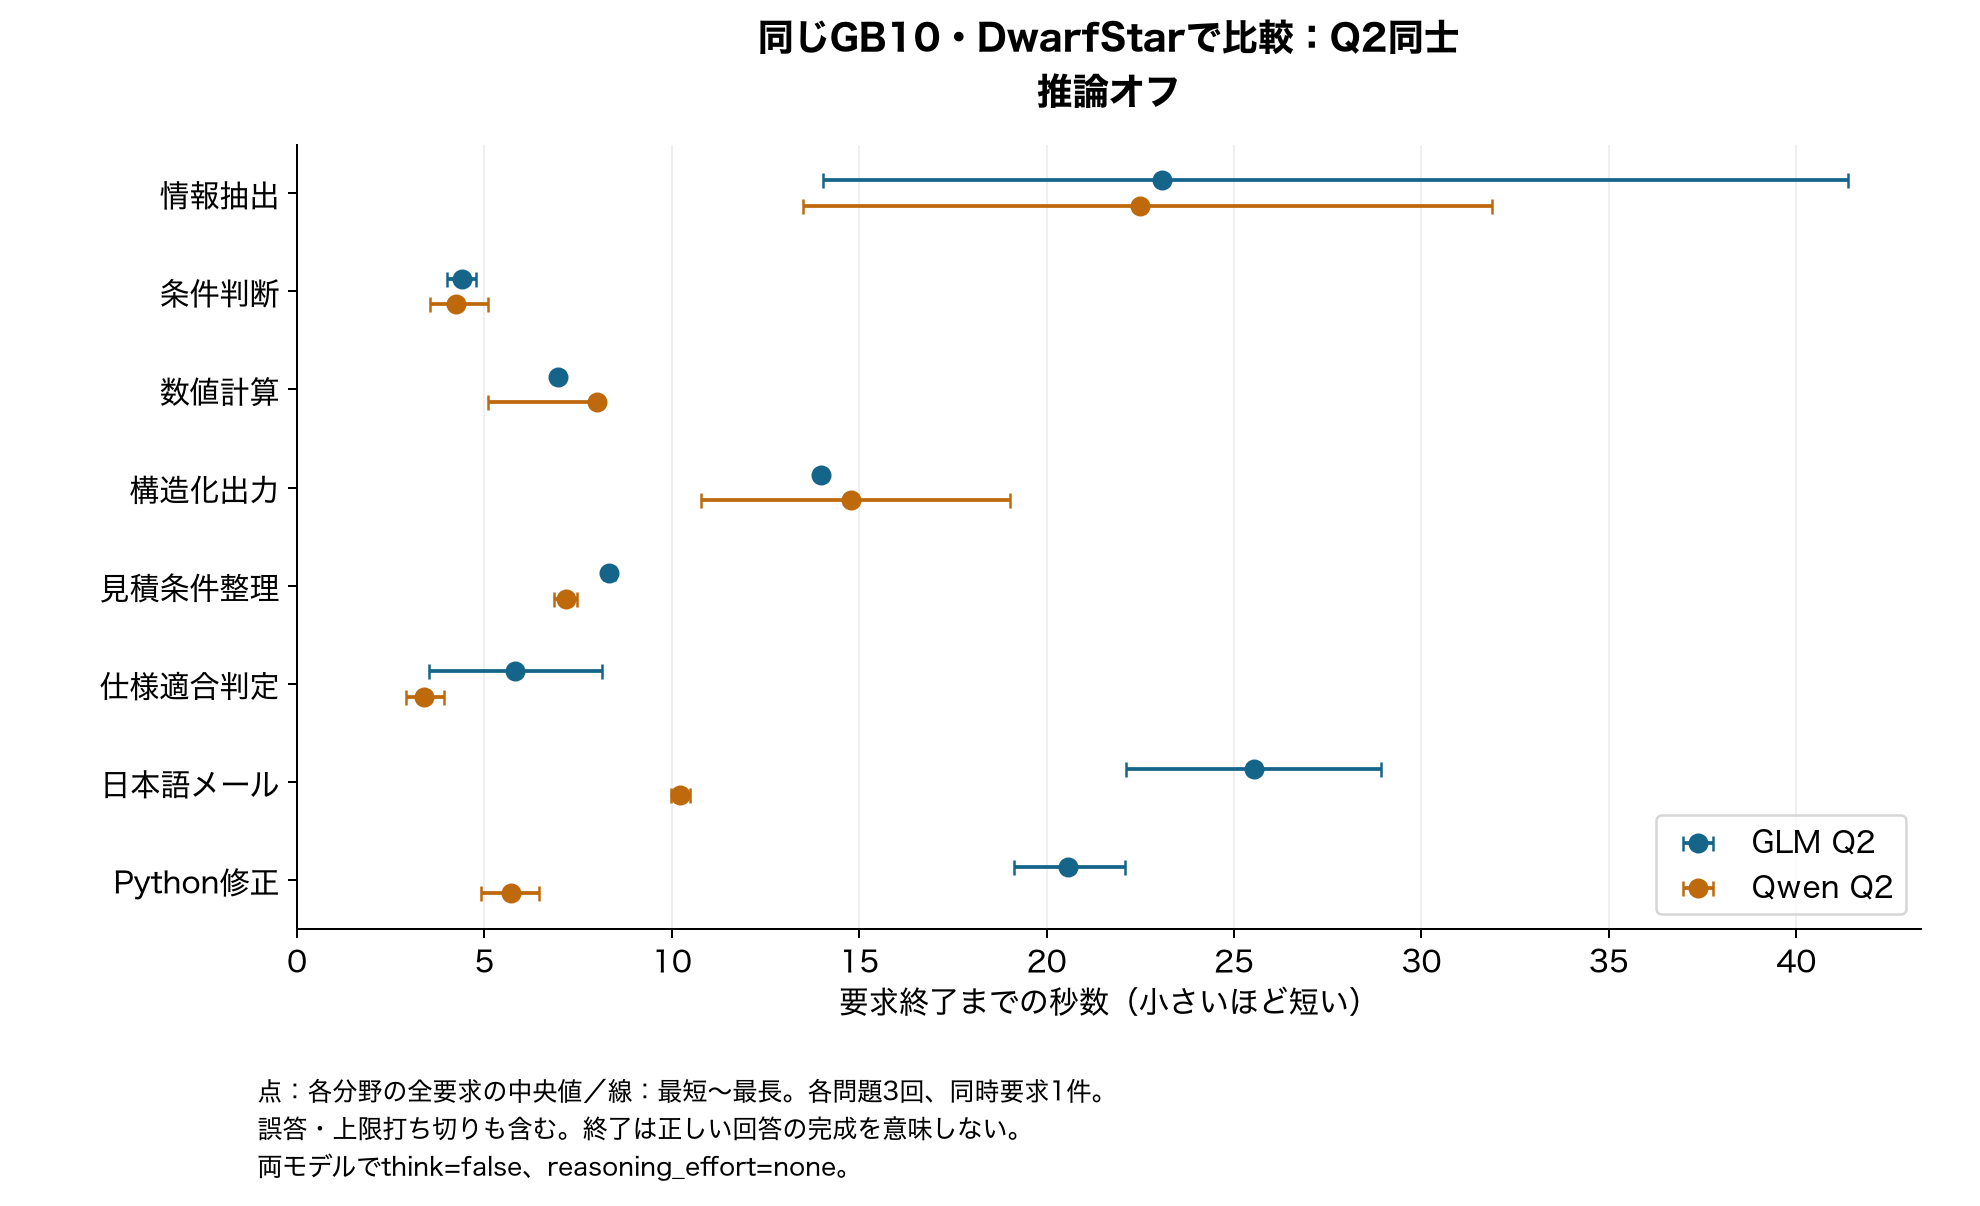
両方を推論オフにすると待ち時間は短くなりましたが、数値計算や条件判定で誤りが増えました。「速い方がよい」「推論を切ればよい」という結論にはできません。
▶ 日本語ナレーション付き動画を見る(7分36秒)(日本語字幕はCCで表示できます。合成音声:OpenAI Marin)
何を揃え、何が異なるのか
DwarfStarのDGX Spark向け資料にあるGLM Q2と、同じプロジェクトが対応・配布するQwen Q2/Q4を選びました。全構成で同じDwarfStarを使っています。
選定根拠:DwarfStarのDGX Spark向け資料、対応モデル資料。参照する版を固定しています。
| 項目 | 共通条件 |
|---|---|
| マシン | GB10 ×1、20論理CPU、公称128GB共有メモリ、同じローカルNVMe |
| 推論エンジン | DwarfStar b3f50180ec2c、同じCUDA Sparkビルド |
| 生成条件 | コンテキスト32,768、出力上限8,192、temperature 0、top_p 1、top_k 1、min_p 0、seed 42 |
| 実行方法 | 同時要求1件、MTPなし。各24問を3回、構成順をローテーション |
| 推論モード | オン:think=true / effort=high。別試験のオフ:think=false / effort=none |
| 採点 | 固定正答・隔離Dockerのコードテスト・Codex補助レビュー(専門家採点ではない) |
同じQ2でも全ての重みが2ビットという意味ではなく、配布物は混合精度です。モデル構造、トークナイザー、テンプレート、専用カーネル、常駐量は異なります。入力処理も各モデルの既定経路を使い、prefill chunkはGLMが2,048、Qwenが8,192でした。これは、この版のDwarfStarで使う量子化モデルの比較であり、元モデル単体や非量子化版の普遍的な順位ではありません。
再現性のある比較としてgreedy設定を固定しました。通常の既定値はtemperature 1、top_p 1、min_p 0.05です。今回の誤答や反復を、既定の対話設定でも必ず起きる現象とは扱いません。
同じ「high」にも違いがあった
固定した版のソースでは、APIのhighはGLMにHigh、Qwenにxhigh相当の指示として渡されます。従ってオンの試験は同じAPI値の比較であり、内部の推論指示が同一ではありません。この差が分かったため、オンの全結果を保全したうえで、両Q2をともに推論オフにした別試験も実施しました。モデルごとに都合のよいモードだけを選んで比較していません。
実装根拠:推論指示の組み立て。指示の差を確認しただけで、待ち時間や失敗の原因をすべて特定できたわけではありません。
待ち時間:本文開始と要求終了を分ける
| 条件 | モデル | 要求終了・中央値 | 本文開始・中央値(観測件数) | 上限打ち切り | 本文なし |
|---|---|---|---|---|---|
| 推論オン | GLM Q2 | 27.0秒 | 17.7秒(72/72件) | 0/72件 | 0件 |
| 推論オン | Qwen Q2 | 60.7秒 | 57.3秒(69/72件) | 6/72件 | 3件 |
| 推論オフ | GLM Q2 | 11.2秒 | 1.4秒(72/72件) | 0/72件 | 0件 |
| 推論オフ | Qwen Q2 | 8.0秒 | 1.4秒(72/72件) | 0/72件 | 0件 |
各行は24問×3回の72要求です。「要求終了」には誤答や出力上限による打ち切りも含み、正しい回答の完成を意味しません。「本文開始」は推論文を除く最初の非空白の本文で、件名やコード枠から始まる場合もあります。本文なしは中央値に数値を補わず、件数を明示しました。モデルのロード時間と会話初期化要求の時間は含みません。
品質:一つの正答率にまとめない
| 固定採点の通過数 | GLM Q2 オン | Qwen Q2 オン | GLM Q2 オフ | Qwen Q2 オフ |
|---|---|---|---|---|
| 情報抽出 | 9/12 | 12/12 | 0/12 | 0/12 |
| 条件判断 | 12/12 | 12/12 | 6/12 | 0/12 |
| 数値計算 | 9/12 | 12/12 | 0/12 | 0/12 |
| 構造化出力 | 12/12 | 12/12 | 12/12 | 12/12 |
| 見積条件整理 | 0/6 | 6/6 | 3/6 | 0/6 |
| 仕様適合判定 | 0/6 | 6/6 | 0/6 | 3/6 |
| Python修正 | 0/6 | 6/6 | 0/6 | 6/6 |
分母12は4問×3回、分母6は2問×3回です。JSON課題は出力全体の構文と値を検査します。情報抽出では従来から固定した採点器が3要素配列をレコードへ正規化するため、厳密なオブジェクト形式一致とは分けています。Python修正も関数の正しさと、関数以外の説明を追加した形式違反を区別します。全回答・推論文・個別採点は末尾の資料で確認できます。
推論オンで確認したこと
GLM Q2は4つの計算課題のうち1つで誤り、例えば1,374×0.89を1,223.86として最終合計も1円ずれました。正しくは1,222.86です。情報抽出1問では誤ったJSONを出した後に訂正と2個目のJSONを追加しており、訂正後の部分だけを選んで合格にはしていません。見積・仕様判定では内容が合っていてもコード枠などの追加でJSON-only条件に違反しました。
Qwen Q2は20のJSON課題で固定採点を通過し、2つのコード課題も固定テストを通過しました。一方、2つのメール課題は3回とも8,192トークンの上限に達しました。mail-1は本文が途中で切れ、mail-2は本文が出ていません。保存した推論文には文字数の再計算や書き直しの反復がありました。内部の下書きは顧客へ渡せる回答として数えていません。
GLMのメールにも内容上の問題があります。mail-1は資料が「入力処理の待ち時間を含まない」としているのに「含む」と記しました。固定メール基準は6項目中5項目で通過するため、この回答も狭い採点基準では通過しますが、実務でそのまま送れる回答とは評価していません。総合正答率だけを掲げない理由の一つです。
推論オフでどう変わったか
推論オフでは両モデルの4つの数値計算課題がすべて不正解でした。情報抽出も、レコード自体が正しくても合計値を誤る例がありました。Qwenではレコードのコードと値を取り違える例もあります。本文が早く出ることを、そのまま品質改善とは評価できません。
履歴から最新の承認済みレコードを選ぶ4問は両モデルとも正答しました。一方、条件判断ではGLMが2問、Qwenが0問の通過でした。GLMの見積・仕様判定では内容が正しくてもコード枠や説明文を追加した形式違反があり、仕様適合1問では安い機種を選ぶ順序も誤りました。
Qwenのメールはオフで本文が完成し、税額や測定条件、最新仕様を正しく扱いました。ただし返信の約束を資料より広く述べる箇所があります。GLMのメールも主要な条件を述べましたが、長すぎる文章や、顧客から提案を受け取ったかのような不適切な挨拶を含みます。固定メール基準の通過と、そのまま顧客へ送れる文章であることは別です。
GLMのコードは説明文を追加するため元の形式採点では不通過です。ただし単一のコード枠から関数だけを抽出した補助テストでは、オン・オフとも2関数が固定の各6項目を通過しました。Qwenの関数も固定テストを通過しています。補助テストで元の形式違反を取り消してはいません。
設問の曖昧さを残さず確認する
元の情報抽出4問は、recordsを3要素配列にするか、キー付きオブジェクトにするかの指定が十分明確ではありませんでした。元の採点は変更せず、全4問について出力を6個のオブジェクトと明示した別の確認を、3構成すべてに1回ずつ実施しました。資料と正答は同じで、出力形式と何番目を合計するかの表現のみを明確にしています。これは12要求の探索的な確認であり、元の結果の差し替えや一般的な速度比較には使いません。
| API highの構成 | 明示したオブジェクト形式と値の完全一致 |
|---|---|
| GLM Q2 | 4/4 |
| Qwen Q2 | 4/4 |
| Qwen Q4 | 4/4 |
形式を明示した追加確認は、GLM Q2・Qwen Q2・Qwen Q4の全構成が4問すべてで厳密な形式と値に一致しました。GLMの元のextract-3にあった訂正付き複数JSONも、この別条件では起きませんでした。質問の書き方が結果に影響したことを示す例ですが、1回の確認で常に正答するとは言えません。元の4問の結果や推論オフの誤答を、この結果で置き換えてはいません。
追加比較:Qwen Q4にするとどうなるか
| 条件 | モデル | 要求終了・中央値 | 本文開始・中央値(観測件数) | 上限打ち切り | 本文なし |
|---|---|---|---|---|---|
| 推論オン | Qwen Q2 | 60.7秒 | 57.3秒(69/72件) | 6/72件 | 3件 |
| 推論オン | Qwen Q4 | 54.4秒 | 50.1秒(66/72件) | 6/72件 | 6件 |
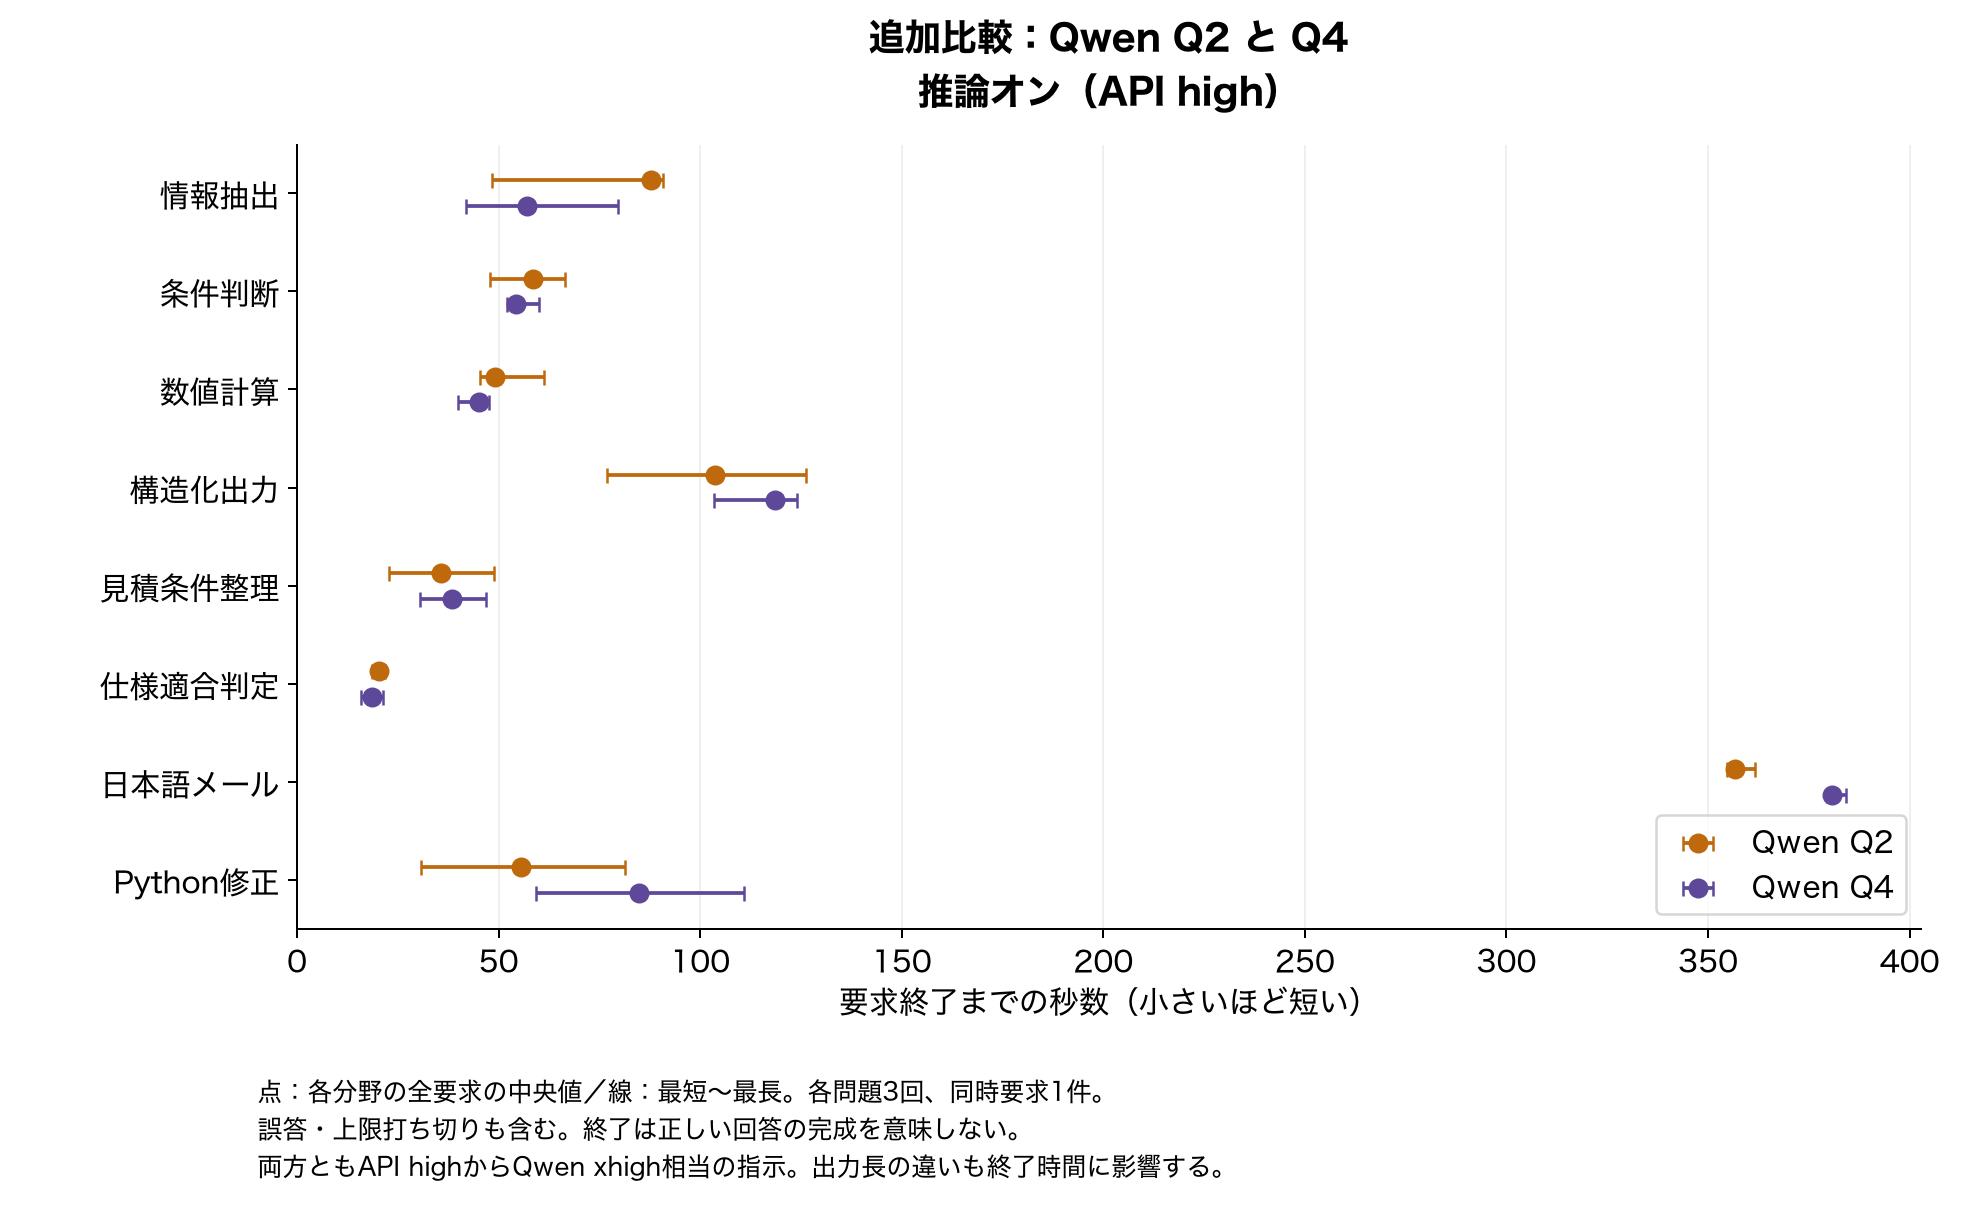
Q4では情報抽出の形式が期待するオブジェクトになりました。一方、見積課題1問のOS名が「Ubuntu24.04」となり、固定の完全一致採点では期待値「Ubuntu 24.04」との空白差で失点しました。これはOSの選択を誤った例ではありません。2つのメール課題は3回とも上限に達し、Q4では6件すべて本文なしでした。今回の課題では、Q4に替えるだけでメールの問題が解消したとは言えません。Q4の推論オフは今回測っていません。
ファイルが128GBを超えても動いた理由
| 配布ファイル | 全体サイズ | うちSSDに置くngram表 |
|---|---|---|
| GLM-5.3-Flash-Q2.gguf | 96.5GB | 対象なし |
| Qwen3.8-Flash-Next-Q2.gguf | 147.2GB | 102.4GB |
| Qwen3.8-Flash-Next-Q4.gguf | 177.3GB | 102.4GB |
Qwenの配布ファイルには約102.4GBのBF16 ngram表が含まれ、この実行ではSSDから参照されます。そのためファイル全体の147.2GBや177.3GBを、そのまま必要なGPUメモリ量と読むことはできません。反対に、表を引いた残りのサイズも実行時メモリの実測値ではありません。GB10の128GBはCPUとGPUの共有メモリです。
| 推論オンの構成 | ホスト全体の非利用可能メモリ最大 | デバイス報告電力の観測最大 |
|---|---|---|
| GLM Q2 | 118.4GB | 92.0W |
| Qwen Q2 | 59.5GB | 78.1W |
| Qwen Q4 | 89.3GB | 78.3W |
メモリは2秒間隔のMemTotal−MemAvailableで、OSや既存サービスも含みます。モデル単体の専用VRAM使用量ではありません。nvidia-smiの専用VRAM値はこのGB10では取得できませんでした。電力も壁コンセントでの消費電力ではありません。RAM・swap・プロセスI/O・NVMe I/Oと欠測は資料に保存しています。OSキャッシュを消しておらず、冷えたSSDからの性能や多人数の同時利用性能は測っていません。
この結果をどう使うか
1人用の128GB級機で両モデルを動かせることは確認できました。用途を決めて、回答が完成するか、必要な事実が正しいか、その後に待ち時間を見る順序が有用です。この試験だけで一方をすべての業務に推奨することはできません。
今回のオン条件ではQwen Q2が計算・条件判断・構造化で安定していましたが、今回の2つのメール課題は完了しませんでした。オフでは文章が返るようになっても計算を外しました。金額計算や業務条件は別の計算・検査で確かめ、顧客向け文章は人が確認する運用が必要です。
Q4はメモリとストレージの負担が増えますが、今回のメールの問題は解消しませんでした。モデルサイズやtokens/秒だけで選ばず、自分の課題で正答・形式・完了率と待ち時間を一緒に確認することを勧めます。
今回はtemperature 0の同じ課題を3回繰り返しました。今回のオン・オフでは、同じ構成・同じ設問の3回で回答と推論文が完全一致しました。ただし、72種類の独立した実務問題を解いた試験ではありません。MTP、並列利用、32Kを超えるコンテキスト、通常のtemperature 1での品質は今回の比較の対象外です。
再確認できる資料
本比較は推論オン216要求と推論オフ144要求、別の出力形式確認12要求です。予備試験15要求は別に収録しています。全モデルのSHA256照合、同じエンジン実行ファイル、質問のハッシュ、生成設定を確認し、入力キャッシュの報告値も監査しました。採点済み試行のやり直しや最良回答の選別はしていません。
初回の明示GPU割当て起動では自動メモリ予算が渡らず、回答を生成する前に停止しました。失敗を保全し、単一GB10向けの通常のCUDA起動へ変更した別試行を評価しています。この0回答の起動失敗をモデルの品質低下には数えていません。
条件・問題・全回答・推論文・個別レビュー・測定値のZIP
SHA256:79e3ba1424d4de37748c9aaf08510e859a6780ee5f69158b6faf55c9c31fe037
モデル生成の推論文も評価資料として保存しており、そこに書かれた計算や説明が正しいとは限りません。機密情報を含む運用ログは公開せず、照合用ハッシュと公開可能な集計値を収録しました。