自動車CFDの通常反復が約24倍に。A100とB200を1GPUずつ、6,533万セルで比較
6,533万セルのDrivAerをA100とB200で各1GPU計測。今回の同一数値条件では、通常反復77.36秒→3.22秒、約24倍。CPU64/128コアの参考時間、構成と適用範囲も公開します。
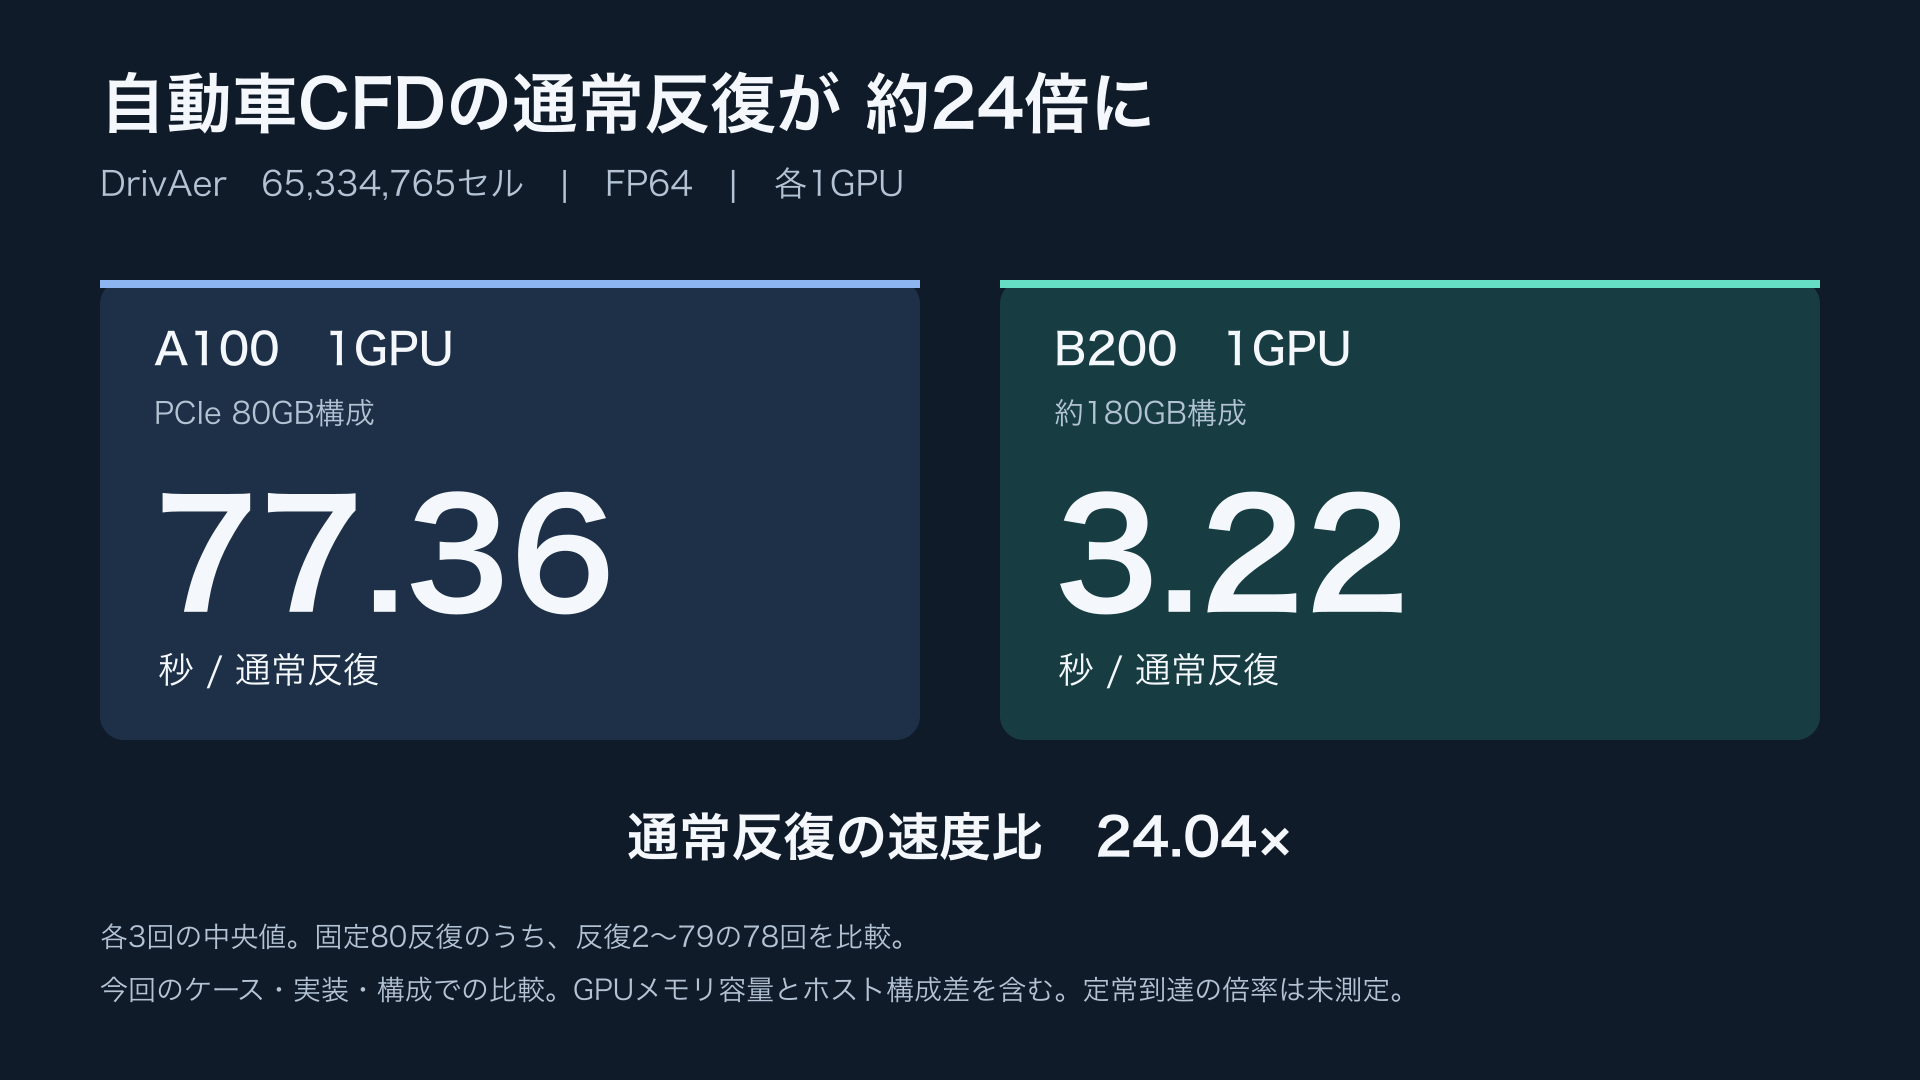
約6,533万セルの自動車外部流れケース「DrivAer」を、A100とB200でそれぞれ1GPUだけ使って計算しました。今回の実装・マシン構成では、通常反復1回あたりの時間が、A100の約77.36秒からB200の約3.22秒へ短縮されました。通常反復のスループットは約24.04倍です。
対象は、GPU化したOpenFOAM/SIMPLE系の実装です。同じメッシュ・初期条件を使い、FP64と元の線形ソルバー停止条件を維持しています。各構成で80反復の計算を3回行い、そのうち反復2〜79の通常区間を比較しました。
この結果だけでも、大規模CFDにおけるB200の実用的な可能性を示す一つの材料になると考えています。数千万セルのケースで、反復を進める速さに大きな差が実測されたためです。
動画で見る
測定条件と結果を約5分で解説しています。YouTubeで「A100とB200・1GPU通常反復約24倍」の解説動画を見る →
測定結果
| 構成 | 通常反復1回あたり |
|---|---|
| A100 PCIe 80GB ×1 GPU | 77.36秒 |
| B200 約180GB ×1 GPU | 3.22秒 |
| 通常反復の速度比 | 約24.04倍 |
いずれも各3回の中央値です。通常区間の計時は両者とも同じ方法で、ソルバーが出力したClock79からClock1を引き、78反復の区間を取り出しています。
3回の通常区間の時間は、A100が6040秒、6034秒、6031秒。B200が251秒、250秒、252秒でした。最速の1回だけを選んだ値ではなく、保存された3回の結果から中央値を使っています。
初期化と最終出力を含む全体の指標も別に保存しています。起動から終了検知までを同じ方式で比較した倍率は約15.4倍です。本記事の「約24倍」は、初期化と初回反復を含む区間、および最終出力を含む反復を除いた、通常反復の指標です。
比較条件と計算結果の確認
メッシュ・初期条件・物性など14ファイルは、両構成の実計測で保存されたSHAとサイズが一致しました。離散化、線形ソルバーの停止条件、出力頻度も照合しています。圧力行列は毎回更新し、full setupと真残差の検査を行っています。B200側だけ精度を落としたり、停止条件を緩めたりした比較は検出されませんでした。
性能計測には、別途実施した重いCPU監査やNsightによる計装を含めていません。両者とも1 MPI rank、使用GPUは1基です。
出力も別途確認しています。同じ初期条件から計算した資格確認用の出力では、A100とB200の速度場の相対L2差は約1.98×10⁻⁸、圧力の正規化差は約2.15×10⁻⁹でした。抗力・揚力・横力の係数であるCd、Cl、Csの窓平均比較も、設定した一致基準を満たしました。各性能計測については、自機の資格確認出力への再現性を確認しています。
使用したサーバー構成
| 項目 | A100側サーバー | B200側サーバー |
|---|---|---|
| CPU | Intel Xeon Gold 6430 ×2 | AMD EPYC 9575F ×2 |
| 物理CPUコア数 | 64コア(32コア×2) | 128コア(64コア×2) |
| ホストメモリ | 搭載512GB※/OS表示約503GiB | 3TB級・3072GB(128GB DIMM×24) |
| 今回のGPU計測で使用したGPU | A100 PCIe 80GBを1基 | B200 約180GBを1基 |
※A100側の搭載512GBは利用者提示の仕様です。保存したOSの認識容量は約503GiBです。ホストの総CPUコア数は、1GPU計測で使ったMPI rank数とは異なります。主比較は両者とも1 MPI rank・1GPUです。
CPUだけで計算した場合の参考時間
同じ65,334,765セル・固定80反復について、両サーバーでCPUだけを使った保存済みの計測もあります。こちらは通常反復1回の時間ではなく、ソルバーの起動・入力・最終出力を含む80反復全体の実経過時間です。
| CPU構成 | 使用MPI rank数 | 回数 | 固定80反復の全体時間・中央値 |
|---|---|---|---|
| Xeon Gold 6430 ×2 | 64 | 2回 | 1631.62秒(27分11.62秒) |
| EPYC 9575F ×2 | 128 | 2回 | 829.61秒(13分49.61秒) |
個々の全体時間は、64コアが1708.86秒/1554.38秒、128コアが820.31秒/838.91秒でした。CPUの時間はGNU timeのwall時間で記録しています。
CPU参考値は標準OpenFOAM v2606・GAMG、GPU側はSPUMA 0.3 v2512を基にpackedlower/AMGXを組み込んだ実装であり、ソフトウェア版、線形ソルバー、領域分割、MPIなどに違いがあります。このCPU表から、GPUとの同精度・定常到達の倍率は主張しません。A100とB200の1GPU同士を同一数値条件で比べた約24倍とは、別の参考情報です。
大きな差を読むうえでのポイントはメモリ容量
今回の比較は、A100 PCIe 80GB構成とB200約180GB構成です。GPUの演算部に加えて、GPUメモリ容量、CPU、ホストメモリ、PCIeなどの構成差を含んでいます。
別に行った短い2反復の容量診断では、A100のGPUメモリがほぼ満杯となり、Unified Memoryによるホスト側への退避を観測しました。B200では同じ短い診断で退避は観測されませんでした。これは、この規模のケースではメモリ容量の差も重要であることを支持する結果です。ただし、80反復全体の退避量や、速度差のうち何割が退避によるものかまでは測定していません。
大規模な解析を扱う利用者にとっては、こうした容量とデータ移動を含めて、目的のケースがどれだけ速く進むかが重要です。今回の約24倍は、その実ケース・指定構成における結果として提示します。
今回示した範囲と、次に確かめること
この測定は固定80反復の探索試験であり、物理的な定常状態に達したことを証明するものではありません。CPU128基準に対する速度場の差は双方約2.30%で、最終目標の1%には未達です。GPU同士の出力がよく一致することと、最終的な解析精度・定常解の確認は分けて扱います。
また、A100とB200ではドライバーや世代別バイナリ、ホスト構成が異なります。本結果は、A100の最善チューニングを尽くした比較や、すべてのCFDケースに適用できる一律の性能比を示すものではありません。
今後はB200側で、複数GPUを使ったときにどこまで反復を速くできるか、そして同じ品質の定常解までの時間をどこまで短縮できるかを検証します。その第一報として、今回の「同一数値条件の大規模ケースで、1GPU同士の通常反復が約24倍」という結果を共有します。
測定条件メモ
- ケース:DrivAer、自動車外部流れ、65,334,765セル
- 実装:GPU化したOpenFOAM/SIMPLE系実装。標準配布のsimpleFoamそのままの性能比ではありません
- 精度と設定:FP64、同じ入力・離散化・元の線形停止条件
- 使用GPU:各構成1基、1 MPI rank
- 計測:固定80反復×各3回、通常区間は反復2〜79、各回の平均時間の中央値
- 通常反復:A100 77.358974359秒、B200 3.217948718秒、速度比24.039840637倍
- 全体時間:起動〜終了検知の約15.4倍は別指標。終了検知は2秒ポーリングを含みます
- 適用範囲:今回のケース・実装・マシン構成。GPUメモリ容量とホスト構成差を含みます
- 未確定:同品質の定常解までの速度比、最終CPU基準1%精度、A100の最適チューニング性能
HGX B200の購入・導入をご検討の方へ
HGX B200の購入、構成選定、導入前の性能評価について、サーバーギアへご相談ください。お使いの解析ソフト、計算規模、現在の計算時間、ご予算、導入時期に合わせて、構成・価格・納期をご案内します。
「OpenFOAMの約24倍の記事を見た」とお書き添えください。今回の結果を踏まえて、お客様の計算に適した構成を検討します。正式な販売・見積・納品は、サンウェイテクノロジー株式会社と連携して対応します。