OpenAIのAstraでHPCプログラムをどこまで高速化できるか?|第2回 CalculiX:穴のあいた鋼板を、GPU 1枚で何秒で解けるか
約98万要素の穴あき鋼板をCPU 64コアで6.66秒、A100 1枚で3.59秒。4枚とも比較したうえで、1件の解析を速くするためにどの判断が効いたかをたどります。
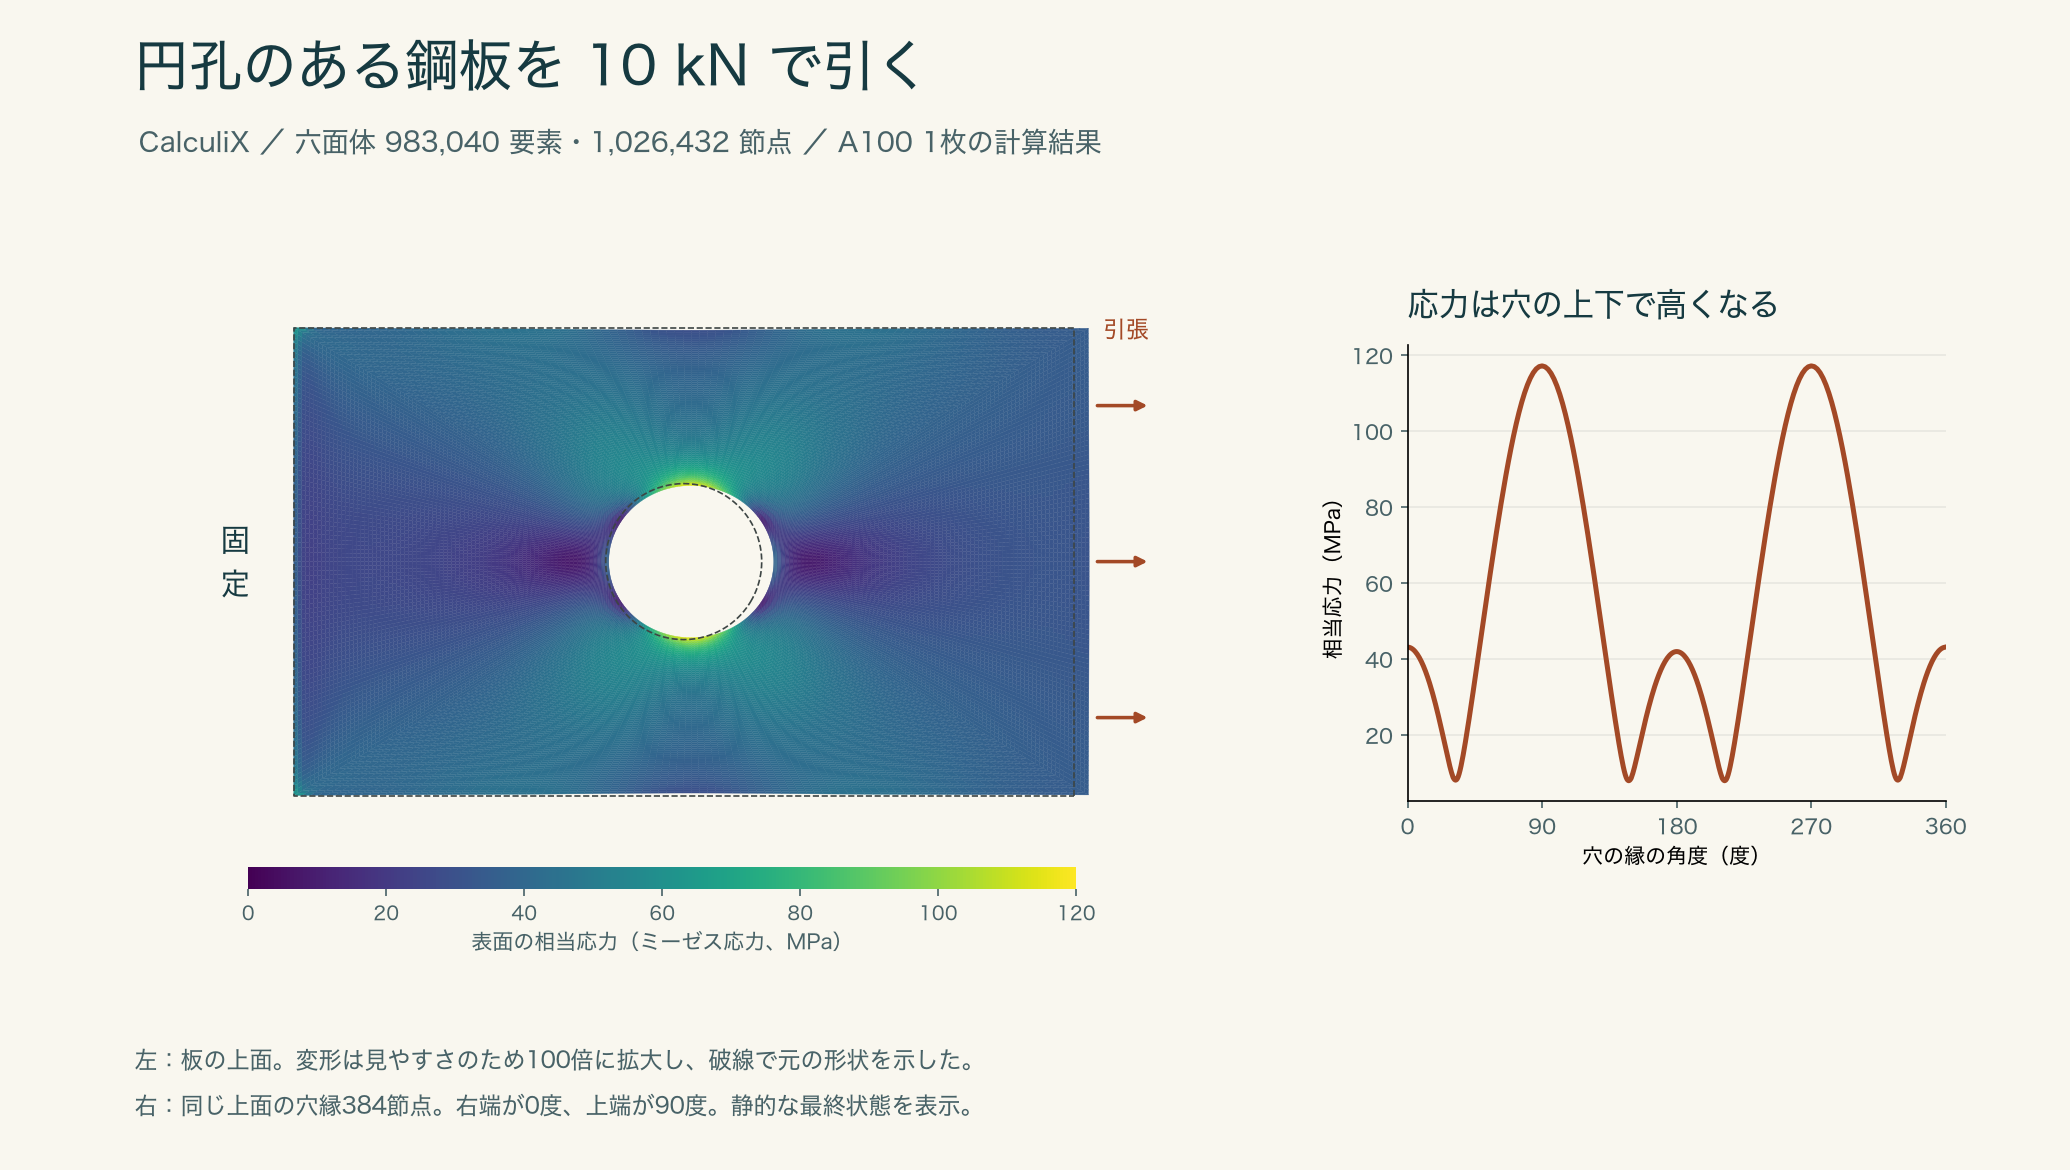
鋼板の左端を固定し、右端を10キロニュートンの力で引く。真ん中には丸い穴がある。板の上面を見ると、応力がいちばん高いのは、引っ張る方向に対して穴の上下の縁だった。約98万要素に分けて計算した最大相当応力は117.12 MPa。今回、速く出したかったのは、この数字と、それがどこに現れるかという答えだ。
この板で、改良したA100 1枚の版は3.59秒。別々に調整したCPU 32・64コアのうち、速かった64コアは6.66秒だった。CPU比は1.86倍、従来のGPU版(12.90秒)からは3.59倍。どれも入力を読むところから変位や応力を書き終えて終了するまで、独立3回の中央値だ。
前回はA100を4枚。なぜ今回は1枚なのか
前回のOpenFOAMは、6,533万セルの流体解析でCPU 64コアとA100 4枚を比べ、8.73倍だった。この数字はCPUからGPU構成に移したときの倍率だ。そこで今回は、同じCalculiXの入力と実装でGPUの枚数だけを変え、1件が早く終わるかを先に測った。
| 初期の枚数比較 | A100 1枚 | A100 4枚 |
|---|---|---|
| 引張1件・157万方程式(行を分割) | 13.30秒 | 14.86秒 |
| はりの接触1件・1,728要素(要素を分担) | 47.31秒 | 46.86秒 |
| 独立した接触解析4件の完了(合計48 CPUコア) | 56.36秒(1枚を共有) | 40.53秒(各件に1枚) |
上から順に各条件2回、3回、2回の中央値。引張1件は4枚でかえって長くなり、接触1件の差は各回のばらつきの範囲だった。引張の1枚実行を別に計測すると、全体13.55秒のうち反復計算は0.75秒(5.5%)。反復をどれだけ速くしても、それ以外の処理は残り、4枚に分けると境界の値を交換する手間も加わる。
一方、同じ接触モデルの独立した4件を同時に走らせると、各件に1枚ずつ割り当てた方が4件を早く終えられた。単位時間あたりの処理件数は1.39倍だ。今回短くしたかったのは、鋼板を1件解析して応力図が出るまでの時間だった。そこで、この予備試験の後は1枚の改良に集中した。最終版の98万要素の鋼板を4枚で解いた場合の時間は未測定だ。
GPUに渡す前に、何を減らせるか
第1回のOpenFOAMでは流れを計算した。第2回のCalculiXでは、材料を小さな要素に分け、加えた力と内部の力がつり合う変形を求める。Astraと進めるうえで、最初に決めたのは時計を止める場所だった。GPUの得意な連立方程式の計算だけを計ると、形状を読む時間も、応力を計算してファイルに書く時間も消えてしまう。今回は読者が解析の終了を待つ時間を測った。
引張モデルで効いた判断は、GPUで同じ反復をもっと速く回すことより、必要な反復そのものを減らすことだった。隣り合う節点だけで誤差を直していくと、遠くまでなだらかに続く誤差はなかなか小さくならない。そこで計算の途中に粗い格子を置き、広い範囲の誤差を一度に補正した。344万方程式の引張では、調整段階の比較で816回だった反復が64回になった。
穴のある板では、四角い規則格子をそのまま実物の代わりにはできない。元の曲がった要素と補正用の格子の間で力と変位を受け渡した。最後は元の要素の積分点で力のつり合いを再計算した。CPUにも同系統の改善を入れ、古いCPU実装だけを相手にした倍率にならないようにした。
同じA100でも、勝敗はモデルで変わる
静的解析では、CPUはXeon Gold 6430の物理32コアと64コア。GPUはA100 PCIe 80 GBを1枚、ホスト側の物理32コアと組み合わせた。入力と出力要求をそろえ、事前に条件を固定し、順番を入れ替えて別プロセスで3回ずつ実行した。表の「CPU比」は32コア・64コアのうち短い方の中央値を、新GPUの中央値で割ったものだ。
| モデル | 従来GPU 秒 | 改良GPU 秒 | CPU32 秒 | CPU64 秒 | CPU比 |
|---|---|---|---|---|---|
| 引張・157万方程式 | 3.65 | 2.20 | 2.45 | 2.13 | 0.97倍 |
| 引張・344万方程式 | 7.58 | 4.27 | 4.74 | 4.60 | 1.08倍 |
| 引張・639万方程式 | 14.49 | 6.37 | 8.74 | 7.87 | 1.24倍 |
| 引張・908万方程式 | — | 7.45 | 10.92 | 11.66 | 1.47倍 |
| 円孔平板・98.3万要素 | 12.90 | 3.59 | 7.00 | 6.66 | 1.86倍 |
157万方程式の引張はCPU 2.13秒、GPU 2.20秒。中央値ではCPUがわずかに速く、各回の測定にもばらつきがある。一方、908万方程式ではCPU 10.92秒、GPU 7.45秒だった。この大きさは従来GPU版の対応上限を超えるため、表の従来GPU欄は空欄とした。どこで逆転するかは、形状や解法を変えれば変わる。
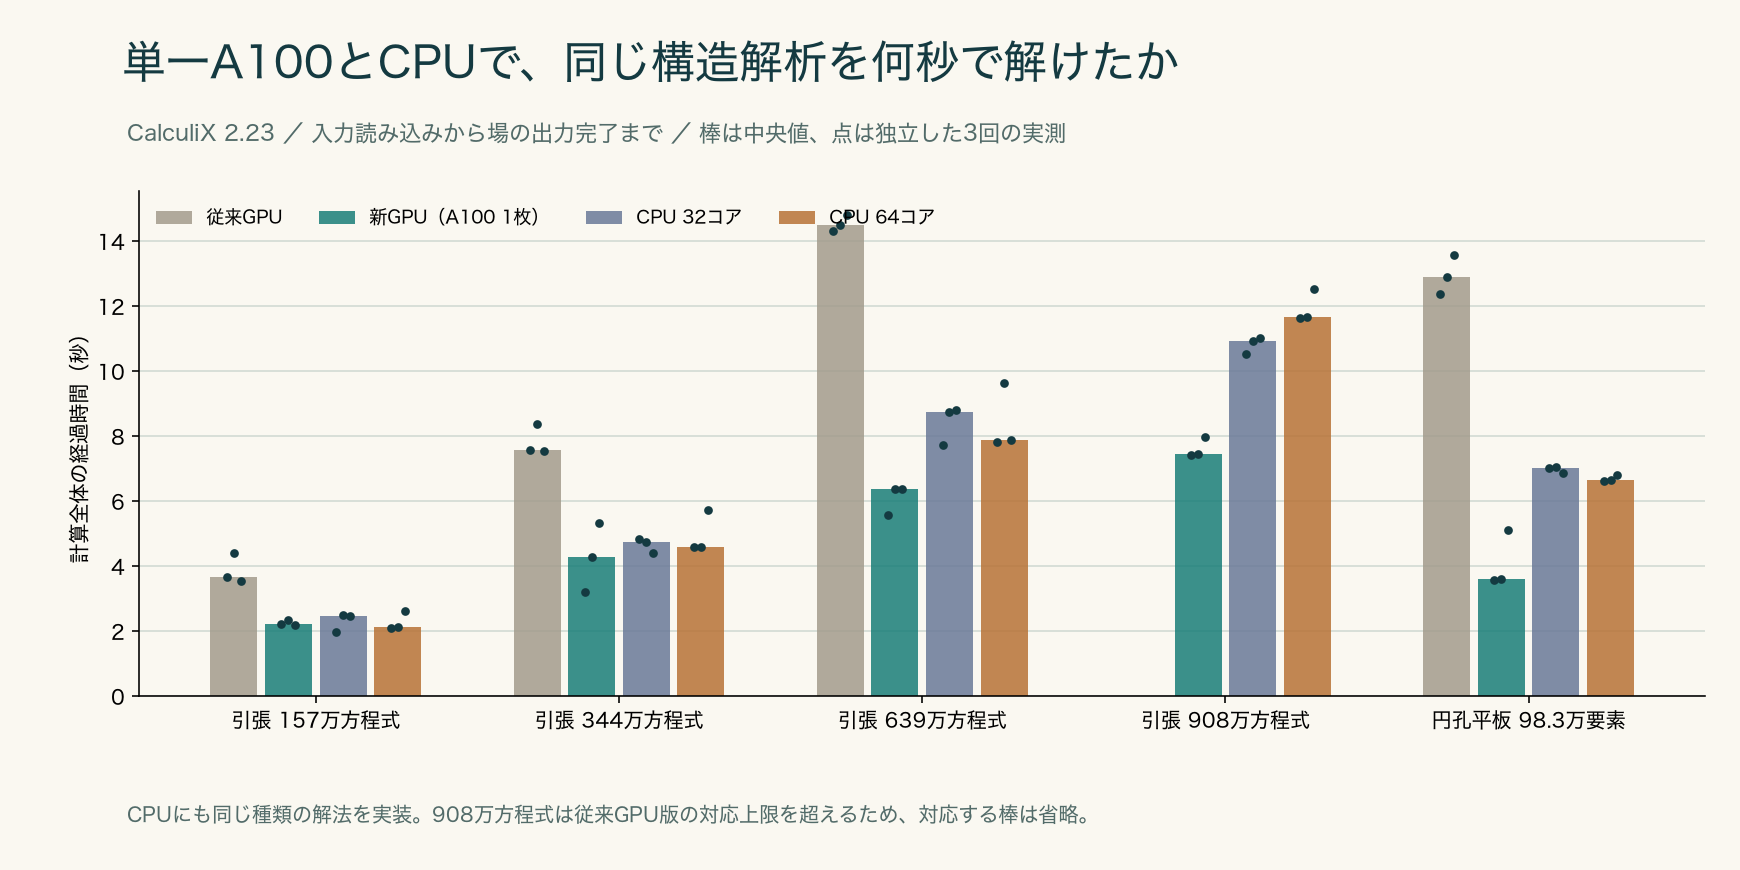
円孔平板の改良GPU版の3回は、3.58秒、3.59秒、5.12秒。最も遅かった回もそのまま含めた。全節点の変位3成分、応力6成分、ひずみ6成分を独立のCPU直接解と照合し、支持部の反力も荷重の10 kNと逆向きにつり合うことを確かめた。約31万要素から約98万要素に細かくしたとき、穴縁の最大相当応力の変化は約0.31%だった。
速くなりそうで、採用しなかった案
粗い格子で誤差を直すときだけ、数値を表す桁数を減らす案も試した。1回の計算を軽くできても、円孔平板では補正が効きにくくなり、反復が120回から352回に増えた。元と同等の精度に達するまでの全体時間は短くならず、この板には採用しなかった。
一方、メモリには大きな差が出た。344万方程式の引張で、剛性行列をGPUに丸ごと保存するのをやめると、GPUメモリ使用量の観測ピーク増分が8.63 GiBから0.84 GiBになった。これは別実行で約25ミリ秒ごとに測った値で、サンプルの間の瞬間的なピークは含まない。
自作の引張問題だけでなく、外部に基準値のある厚板の試験問題、NAFEMS LE10も解いた。面圧を受ける楕円形の厚板で、指定点の応力の基準は −5.38 MPa。CPU直接解は1,152要素の-5.816 MPaから、248,832要素の-5.486 MPaへ近づいた。後者でも基準値との差は1.98%あり、GPUとCPUの計算結果が一致することは、格子を十分に細かくしたことの証明にはならない。
はりが触れた瞬間に、別の問題が見えた
ここまでは静止した状態のつり合いだった。次は、圧力で二本のはりを動かして接触させた。計算が進むと接触状態が変わり、同じ行列を一度解いて終わりにはならない。GPU版では、行列の分解に単精度を使い、元の行列との誤差を倍精度で調べ、必要なら計算し直した。
| 二本のはり | 従来GPU 秒 | 改良GPU 秒 | CPU 秒 | CPU比 |
|---|---|---|---|---|
| R3 | 36.64 | 31.80 | 48.91 | 1.54倍 |
| R4 | 99.88 | 82.78 | 131.72 | 1.59倍 |
R3・R4は同じ系統の接触問題を異なる規模で解いたもの。CPUはR3で12コア、R4で16コア。従来GPU版のホストもそれぞれ12・16コア、改良GPU版は両方とも8コアで、速度差にはホストの調整も含まれる。GPUと参照CPUは、受理した時間刻みと、保存した10時点の全節点変位・接触合力を照合した。
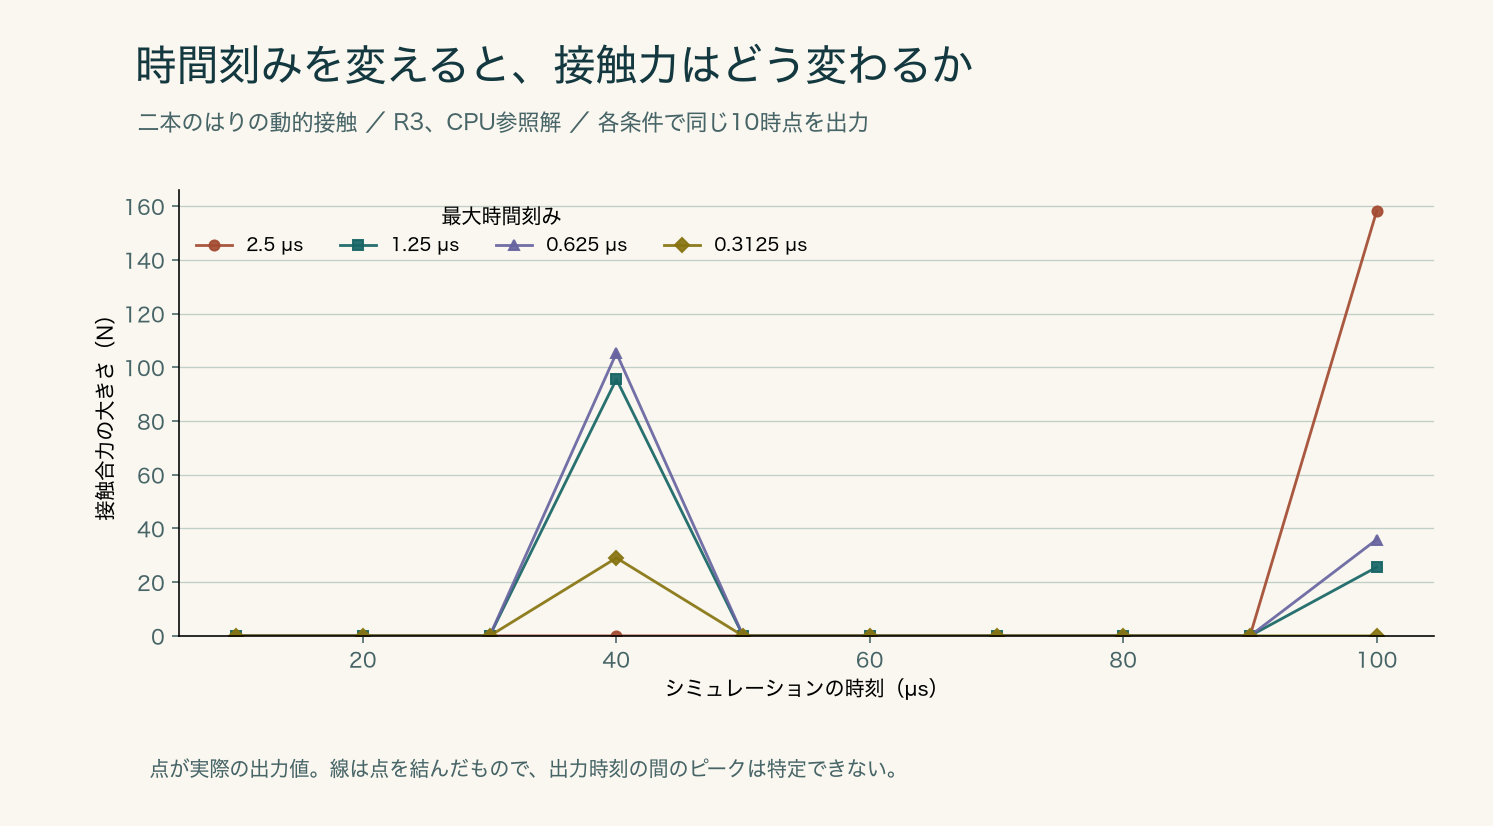
それでも、衝突の力を予測できたとは言えない。R3で最大時間刻みを8分の1にすると、10個の保存時刻で見た最大接触力は158 Nから29 Nに変わった。時刻と時刻の間にいくつのピークがあったかは分からない。元のCPU計算にも、最終時点で約229%という大きなエネルギー収支のずれが残った。「同じ答えを速く再現できた」ことと、「現実の衝突を正しく表せた」ことは別々に評価したい。
二つの時間刻みの変形を、実測10時点の短い動画で比較する →
その後の候補は、別の3回で確かめた
最初の比較を始めた後も、節点に働く力を集計する処理を見直した。候補を選ぶのに使った好タイムは捨て、別に定めた順で3回ずつ実行した。次の表は最初の表とは別の測定群で、元のGPU条件もこの群の中で計り直している。
| モデル | 比較GPU 秒 | 追加GPU 秒 | 追加CPU32 秒 | 追加CPU64 秒 | この群のCPU比 |
|---|---|---|---|---|---|
| 引張・344万方程式 | 3.24 | 3.23 | 4.57 | 4.91 | 1.41倍 |
| 引張・908万方程式 | 8.19 | 6.34 | 11.62 | 11.98 | 1.83倍 |
| 円孔平板・98.3万要素 | 4.45 | 3.58 | 7.17 | 6.78 | 1.89倍 |
円孔平板では再選考の結果も同じGPU設定だった。この行の二つのGPU時間の差は、同じ処理を繰り返したときのばらつきで、新しい改良の効果ではない。
接触では、一つ前の行列分解を試し、現在の行列の倍精度残差が基準を満たしたときだけ使う案も比較した。別試験の中央値はR3で32.80秒から32.52秒、R4で87.66秒から84.63秒。これも速度の比較で、エネルギー収支の課題は残る。
次に手を入れるなら
Nsight Systemsで区間ごとに見ると、344万方程式の引張のある実行で、専用の解法に約0.66秒、結果の計算に約1.05秒、FRDファイルへの出力に約0.46秒かかった。GPUの解法を速くした今、同じ応力やひずみを、同じ精度と書式でもっと少ない手間で取り出すことが次の候補になる。接触側では、さらに数秒を削ることより先に、時間刻みとエネルギー収支の問題を切り分けたい。
今回確認できたのは、決めた形状、材料、荷重、出力に対する結果だ。穴あき鋼板の待ち時間を縮められたこと、小さい引張ではCPUが競り勝ったこと、そして接触力の判断を保留したこと。どれも、この一枚のGPUから得られた答えだった。
技術報告を開く 測定条件・全比較・検証結果
A100 1枚で、構造解析は
どこまで速くなるか
入力読み込みから変位・応力などのファイルを出力して終了するまでを測った。規則的な引張モデル、円孔のある鋼板、二本のはりの動的接触を分けて比較する。
静的解析の比較
それぞれの条件で独立に3回実行した中央値(秒)。調整に使った試行は含まない。CPUにも粗い格子を使う解法を実装し、32コアと64コアを別々に調整した。右端の倍率は両CPU条件の速い方を基準にしている。
| モデル | 従来GPU 秒 | 新GPU 秒 | CPU32 秒 | CPU64 秒 | 旧GPU比 | 最速CPU比 |
|---|---|---|---|---|---|---|
| 引張・157万方程式 | 3.65 | 2.20 | 2.45 | 2.13 | 1.66× | 0.97× |
| 引張・344万方程式 | 7.58 | 4.27 | 4.74 | 4.60 | 1.78× | 1.08× |
| 引張・639万方程式 | 14.49 | 6.37 | 8.74 | 7.87 | 2.27× | 1.24× |
| 引張・908万方程式 | — | 7.45 | 10.92 | 11.66 | — | 1.47× |
| 円孔平板・98.3万要素 | 12.90 | 3.59 | 7.00 | 6.66 | 3.59× | 1.86× |
— は3回の確認がそろっていないか、比較対象がない欄。908万方程式は従来GPU版の対応サイズ上限を超えるため、旧GPU比を示さない。時間は短いほどよい。GPU条件にも入力処理や出力処理のためのCPUを使う。
円孔平板で確かめたこと
| 六面体要素数 | 節点数 | 穴縁の最大相当応力 MPa | 上面最大変位 mm |
|---|---|---|---|
| 28,672 | 33,408 | 115.07 | 0.01587 |
| 76,800 | 86,592 | 116.06 | 0.01588 |
| 307,200 | 327,936 | 116.76 | 0.01589 |
| 983,040 | 1,026,432 | 117.12 | 0.01589 |
98万3,040要素の独立したCPU直接解を作り、GPUの全節点で変位3成分・応力6成分・ひずみ6成分を照合した。支持部の反力は荷重10 kNと逆向きに一致した。上面の穴縁の応力は、30万要素から98万要素に細分化して約0.31%変わった。
何が効いたか
従来は、各節点で局所的に誤差を直していた。離れた節点にまたがる緩やかな変形を粗い格子でまとめて補正すると、344万方程式の引張で816回だった反復が64回になった。穴のある板には、実際の曲がった要素と補助格子の間で力と変位を受け渡す方式を使った。補助格子が置き換えるのは解を求める途中の処理だけで、形状・荷重・元の釣り合い式は変えていない。
| 初期の切り分け・GPU同一実行系列 | 従来の反復 秒 | 粗格子・1回平滑化 秒 | 粗格子・2回平滑化 秒 | 従来/2回 |
|---|---|---|---|---|
| 引張・157万方程式 | 4.07 | 3.96 | 2.83 | 1.44× |
| 引張・344万方程式 | 7.40 | 5.82 | 5.58 | 1.33× |
| 引張・639万方程式 | 14.55 | 10.19 | 9.93 | 1.47× |
単純な六面体格子では別の候補として、剛性行列の全成分を保存せずに積を求める処理も実装した。採用候補は実際の接続・座標・拘束・材料を検査する。行列を組まない場合は、各要素の8点で応力から内力を計算し直し、荷重と釣り合うことを確認する。適用できない入力は通常の経路に戻す。各実行で実際に選ばれた経路は証跡に記録した。
非線形の動的接触は別の問題
二本のはりが接触・離間すると、変形に応じて行列が変わる。静的引張の倍率はこのケースには転用できない。ここでは同じ入力で出力10時点の全節点変位、接触合力、受理した時間刻みを照合した。
| モデル | 従来GPU 秒 | 新GPU 秒 | CPU 秒(R3:12コア、R4:16コア) | 旧GPU比 | CPU比 | 旧GPUとの範囲比較 |
|---|---|---|---|---|---|---|
| 二本のはり・R3 | 36.64 | 31.80 | 48.91 | 1.15× | 1.54× | 測定範囲に重なり |
| 二本のはり・R4 | 99.88 | 82.78 | 131.72 | 1.21× | 1.59× | 3回とも短縮 |
GPUを支えるCPUは、従来条件がR3で12コア・R4で16コア、新条件はいずれも8コア。新旧の差にはホスト側のコア調整も含むため、行列分解の方式だけの効果とはみなさない。静的な本測定のGPU条件はいずれもホスト32コア。
圧力をかけた元モデルの最終エネルギー収支誤差はCPU参照でもR3で約229%、R4で約210%。CPUとGPUが一致しても、実際の衝突を精度よく予測できたことにはならない。
| CPU同一モデル | 最大時間刻み µs | 出力10点の最大接触合力 N | 最終エネルギー収支誤差 |
|---|---|---|---|
| pressure-r2 | 2.5 | 181.926 | 267.1% |
| pressure-r2 | 1.25 | 72.667 | 141.0% |
| pressure-r2 | 0.625 | 107.261 | 633.3% |
| pressure-r2 | 0.3125 | 0.000 | 1401.5% |
| pressure-r3 | 2.5 | 158.256 | 228.8% |
| pressure-r3 | 1.25 | 95.569 | 160.7% |
| pressure-r3 | 0.625 | 105.322 | 581.7% |
| pressure-r3 | 0.3125 | 29.040 | 1587.8% |
この表だけ時間刻みを変えている。速度表の比較には使わない。試験条件の差は十時点に現れる最大接触力にも影響する。
測定と検証
Intel Xeon Gold 6430(32物理コア×2)、NVIDIA A100 PCIe 80 GB。GPUは0番の1枚だけを表示し、CPUのみの実行ではGPUを非表示にした。32コアは0–31、64コアは0–63に固定。ジョブ間は排他制御を行い、モデル単位で実行順を入れ替えた。同じ入力ファイル・同じ出力要求を使い、独立なプロセスを起動して終了まで単調時計で計時した。プロファイラの実行時間は倍率に含まない。
静的解析はメッシュの節点・要素の一致、出力の有限性、相対L2誤差(変位5×10⁻⁷未満、応力・ひずみ5×10⁻⁶未満)、反復解の相対残差10⁻¹¹以下を確認した。円孔平板はさらに反力の誤差0.05 N未満を要求した。344万方程式と98万要素円孔平板にはCPU直接法、639万・908万方程式には独立したCPU反復解を用いた。これらは指定ケースでの数値的一致の検証であり、あらゆる構造・材料を保証するものではない。
残った待ち時間
Nsight Systemsで測ったCPU側の区間(秒)。計測器を付けた別実行のため、速度表には加えない。要素の行列を保存しない経路では組み立て処理に代わって「専用解法」を使う。
| モデル・実行経路 | 行列構造 | 通常の組み立て | 専用解法 | 結果計算(合計) | FRD出力 |
|---|---|---|---|---|---|
| 引張・344万(初期の粗格子版) | 1.65 | 0.59 | — | 0.98 | 0.47 |
| 円孔平板(初期の補助格子版) | 2.00 | 1.84 | — | 0.83 | 0.39 |
| 引張・344万(専用版) | 0.12 | — | 0.66 | 1.05 | 0.46 |
| 円孔平板(押し出し版) | 0.17 | — | 1.33 | 0.98 | 0.45 |
Nsight Computeのハードウェアカウンター
各カーネルを1回抽出して取得した値。アプリ全時間の使用率ではない。
| カーネル | 所要時間 | 演算器スループット | DRAMスループット |
|---|---|---|---|
| 細→粗格子(複数節点から加算) | 1.01 ms | 9.15 % | 3.50 % |
| 細→粗格子(格子側に集約) | 327.26 us | 39.15 % | 26.73 % |
| 直方体の格子転送 | 205.54 us | 58.27 % | 7.73 % |
| 直方体の剛性演算 | 1.19 ms | 32.58 % | 7.97 % |
| 押し出し断面の剛性演算 | 3.12 ms | 5.63 % | 65.06 % |
| 係数を並べ替えた断面演算 | 1.54 ms | 9.34 % | 76.22 % |
| 単精度の誤差補正 | 76.29 us | 76.86 % | 24.24 % |
行列の非ゼロ成分の位置を直接作る経路については、確認用の別実行で従来の構造を再構築し、全列の成分数・開始位置・行番号を照合した。全成分監査を通過した実行数:6。
各モデルの収束と独立参照解の照合(最終比較の1回目)
| モデル | 実際の解法 | 反復 | 相対残差 | 変位 相対L2 | 応力 相対L2 | 応力 最大差/最大値 |
|---|---|---|---|---|---|---|
| 引張・157万方程式 | GPU eight-point equilibrium PCG | 60 | 2.00e-12 | 1.31e-14 | 5.05e-11 | 3.36e-09 |
| 引張・344万方程式 | GPU eight-point equilibrium PCG | 60 | 2.26e-12 | 1.12e-14 | 3.01e-11 | 1.99e-09 |
| 引張・639万方程式 | GPU eight-point equilibrium PCG | 60 | 2.74e-12 | 3.75e-10 | 8.15e-09 | 1.27e-06 |
| 引張・908万方程式 | GPU eight-point equilibrium PCG | 60 | 2.91e-12 | 3.97e-10 | 2.15e-10 | 9.60e-09 |
| 円孔平板・98.3万要素 | GPU extruded equilibrium PCG | 120 | 8.19e-12 | 2.68e-10 | 1.31e-11 | 7.92e-10 |
各回の全体時間と採用した実行条件
| モデル | 条件 | 実行版 | コア | 全測定 秒 | 照合済み |
|---|---|---|---|---|---|
| 引張・157万方程式 | old | cudss-post | 32 | 3.65, 4.39, 3.53 | 3/3 |
| 引張・157万方程式 | new | cudss-release17v3 | 32 | 2.20, 2.35, 2.18 | 3/3 |
| 引張・157万方程式 | cpu32 | pardiso-cleanprism | 32 | 1.98, 2.50, 2.45 | 3/3 |
| 引張・157万方程式 | cpu64 | pardiso-cleanprism | 64 | 2.10, 2.13, 2.61 | 3/3 |
| 引張・344万方程式 | old | cudss-post | 32 | 7.58, 8.37, 7.53 | 3/3 |
| 引張・344万方程式 | new | cudss-release17v3 | 32 | 3.21, 4.27, 5.32 | 3/3 |
| 引張・344万方程式 | cpu32 | pardiso-cleanprism | 32 | 4.82, 4.74, 4.39 | 3/3 |
| 引張・344万方程式 | cpu64 | pardiso-cleanprism | 64 | 4.60, 4.57, 5.73 | 3/3 |
| 引張・639万方程式 | old | cudss-post | 32 | 14.31, 14.49, 14.79 | 3/3 |
| 引張・639万方程式 | new | cudss-release17v3 | 32 | 5.56, 6.38, 6.37 | 3/3 |
| 引張・639万方程式 | cpu32 | pardiso-cleanprism | 32 | 7.73, 8.74, 8.80 | 3/3 |
| 引張・639万方程式 | cpu64 | pardiso-cleanprism | 64 | 7.81, 9.63, 7.87 | 3/3 |
| 引張・908万方程式 | new | cudss-release17v3 | 32 | 7.43, 7.45, 7.96 | 3/3 |
| 引張・908万方程式 | cpu32 | pardiso-cleanprism | 32 | 10.54, 10.92, 11.01 | 3/3 |
| 引張・908万方程式 | cpu64 | pardiso-cleanprism | 64 | 11.64, 11.66, 12.51 | 3/3 |
| 円孔平板・98.3万要素 | old | cudss-post | 32 | 12.36, 12.90, 13.56 | 3/3 |
| 円孔平板・98.3万要素 | new | cudss-release17v3 | 32 | 3.58, 3.59, 5.12 | 3/3 |
| 円孔平板・98.3万要素 | cpu32 | pardiso-cleanprism | 32 | 7.00, 7.04, 6.85 | 3/3 |
| 円孔平板・98.3万要素 | cpu64 | pardiso-cleanprism | 64 | 6.62, 6.66, 6.79 | 3/3 |
| 二本のはり・R3 | old | cudss-order | 12 | 36.94, 36.64, 33.95 | 3/3 |
| 二本のはり・R3 | new | cudss-release17v3 | 8 | 50.48, 31.80, 31.80 | 3/3 |
| 二本のはり・R3 | cpu | pardiso-clean | 12 | 49.03, 48.91, 48.67 | 3/3 |
| 二本のはり・R4 | old | cudss-order | 16 | 100.02, 94.65, 99.88 | 3/3 |
| 二本のはり・R4 | new | cudss-release17v3 | 8 | 81.71, 82.78, 88.85 | 3/3 |
| 二本のはり・R4 | cpu | pardiso-clean | 16 | 136.59, 131.00, 131.72 | 3/3 |
どの判断が効いたか
良くなった案と見送った案を同じ基準で比較した。カーネル単独の速さではなく、最終出力までの時間・メモリと計算結果を見た。
| 試した変更 | 測定から分かったこと | 判断 |
|---|---|---|
| 剛性行列をGPUに丸ごと保存しない | 344万方程式でGPUメモリの観測ピーク増分 8.63 → 0.84 GiB | 規則的な形状で採用。全要素の釣り合いを別計算で検証 |
| 粗格子の補正だけを単精度にする | 円孔平板で 120 → 352 反復(各1回) | 円孔平板では採用せず。1回の演算より反復回数の増加が響いた |
| 押し出し断面の係数をGPU向けに並べ替える | 円孔平板の全体時間 3.77 → 3.96 秒(各3回) | 本測定では従来の並びを維持 |
| 前の4種類の行列構造を保存し、再登場時に使う | R3/R4の新規登録 45/49 回、切替後の再利用 0/0 回 | この2入力では追加の履歴を持つ利点を確認できず |
公表基準値との比較:NAFEMS LE10
厚さ600 mmの楕円形の厚板の上面に1 MPaの面圧を加える。NAFEMS LE10の仕様・基準値から独自に入力を作り、内側の上面端 D(2000, 0, 600 mm)の y 方向応力を、基準値 −5.38 MPa と比較した。節点数や拘束条件を変えず、標準の面圧入力のまま計算した。
| 六面体要素数 | CPU直接解 σyy MPa | 基準値との差 | CPU直接法 1回・秒 | 追加GPU版 1回・秒 | 追加GPU版の実行経路 |
|---|---|---|---|---|---|
| 1,152 | -5.816 | 8.10% | 0.11 | 0.47 | GPU extruded equilibrium PCG |
| 9,216 | -5.691 | 5.78% | 0.90 | 0.51 | GPU extruded equilibrium PCG |
| 73,728 | -5.547 | 3.10% | 7.48 | 0.89 | GPU extruded equilibrium PCG |
| 248,832 | -5.486 | 1.98% | 27.27 | 2.28 | GPU extruded equilibrium PCG |
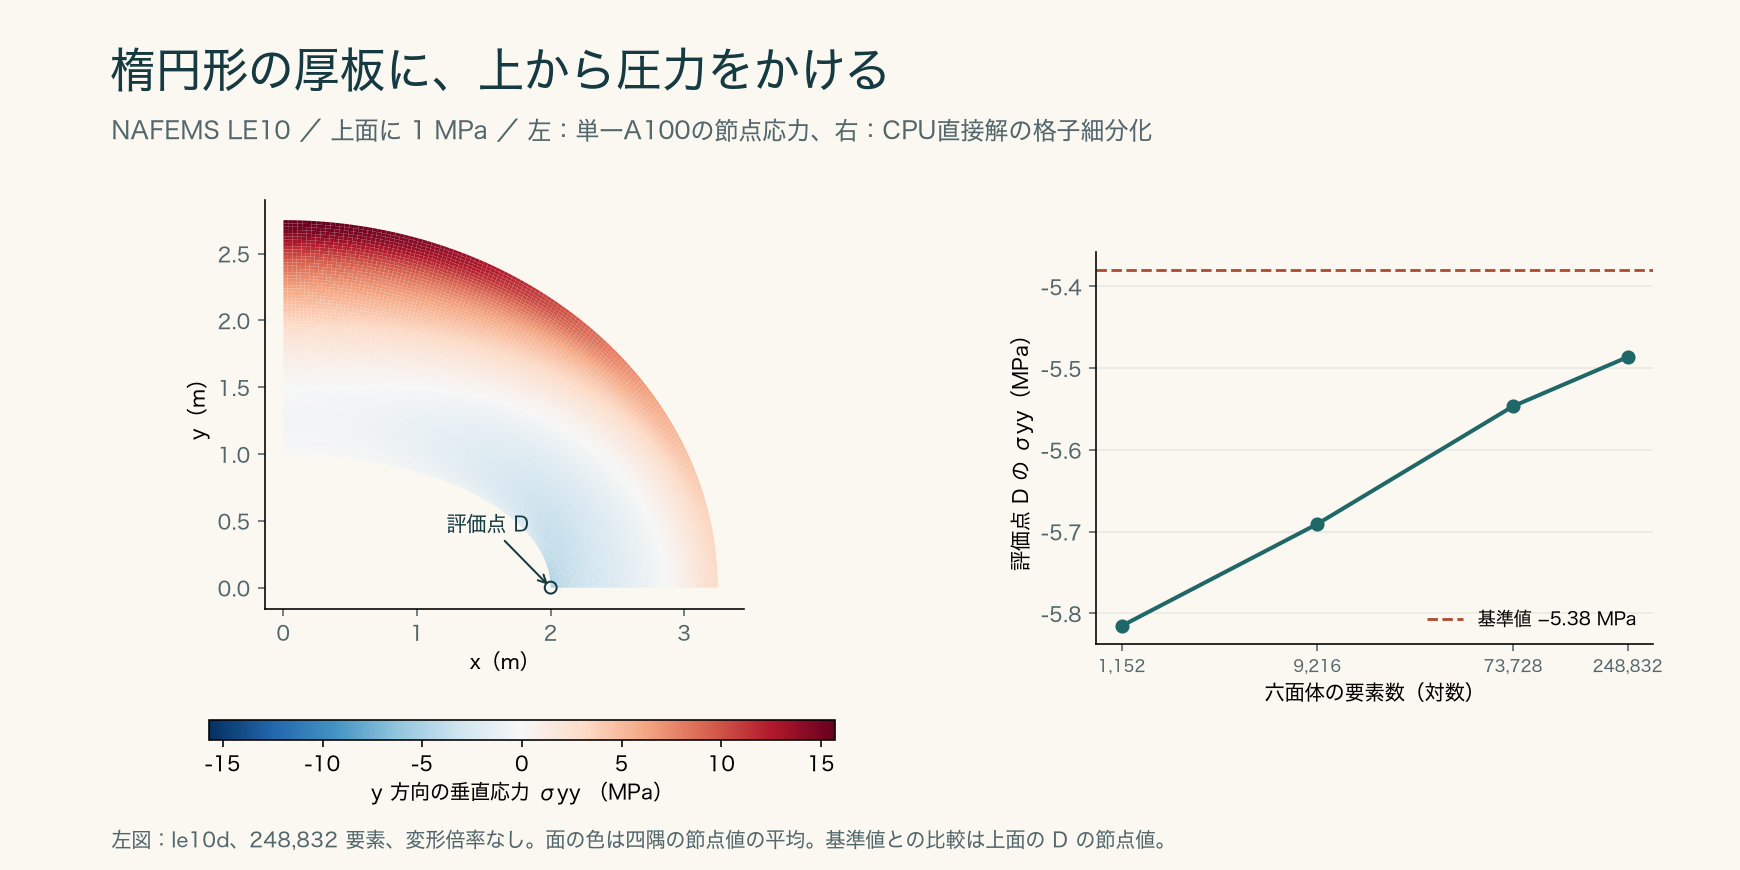
ここに示した時間は工学的な照合時の単発測定で、主要な速度比較の中央値とは別。反力は平面を多角形で近似した実際の要素面積×圧力と比較した。
追加の反復測定:静的解析
最初の本測定を開始した後の改善候補を、別の比較計画で各3回実行した。調整に使った試行は中央値から除いた。比較GPU欄は最初の本測定の新GPU条件をこの実行群で改めて測った値。
| モデル | 比較GPU 秒 | 追加GPU 秒 | 追加CPU32 秒 | 追加CPU64 秒 | 最速CPU比 |
|---|---|---|---|---|---|
| cube104 | 3.24 | 3.23 | 4.57 | 4.91 | 1.41× |
| plate-million | 4.45 | 3.58 | 7.17 | 6.78 | 1.89× |
| cube144 | 8.19 | 6.34 | 11.62 | 11.98 | 1.83× |
追加比較の全測定値と条件
| モデル | 条件 | 実行版 | コア | 各回 秒 | 照合済み |
|---|---|---|---|---|---|
| cube104 | refGPU | cudss-release17v3 | 32 | 3.24, 4.33, 3.20 | 3/3 |
| cube104 | GPU | cudss-reduce17 | 32 | 3.85, 3.23, 2.85 | 3/3 |
| cube104 | CPU32 | pardiso-release17v3 | 32 | 5.08, 4.57, 4.46 | 3/3 |
| cube104 | CPU64 | pardiso-release17v3 | 64 | 4.50, 6.73, 4.91 | 3/3 |
| plate-million | refGPU | cudss-release17v3 | 32 | 3.57, 4.45, 5.04 | 3/3 |
| plate-million | GPU | cudss-release17v3 | 32 | 3.58, 3.53, 3.58 | 3/3 |
| plate-million | CPU32 | pardiso-native17 | 32 | 7.30, 7.17, 7.01 | 3/3 |
| plate-million | CPU64 | pardiso-hostprism | 64 | 7.44, 6.60, 6.78 | 3/3 |
| cube144 | refGPU | cudss-release17v3 | 32 | 7.57, 8.19, 8.33 | 3/3 |
| cube144 | GPU | cudss-span17 | 32 | 6.34, 6.30, 7.30 | 3/3 |
| cube144 | CPU32 | pardiso-hostprism | 32 | 11.62, 10.63, 11.64 | 3/3 |
| cube144 | CPU64 | pardiso-hostprism | 64 | 12.14, 11.98, 11.29 | 3/3 |
平板(plate-million)は、追加選考でも同じGPU実行ファイル・設定が選ばれた。比較GPU列と追加GPU列の差は、同じ処理を別々に走らせた際の測定のばらつきで、追加の高速化ではない。
追加の反復測定:動的接触
最初の本測定を開始した後の改善候補を、別の比較計画で各3回実行した。調整に使った試行は中央値から除いた。比較GPU欄は最初の本測定の新GPU条件をこの実行群で改めて測った値。
| モデル | 比較GPU 秒 | 前回分解の再利用候補 秒 | 比較GPU比 |
|---|---|---|---|
| pressure-r3 | 32.80 | 32.52 | 1.01× |
| pressure-r4 | 87.66 | 84.63 | 1.04× |
追加比較の全測定値と条件
| モデル | 条件 | 実行版 | コア | 各回 秒 | 照合済み |
|---|---|---|---|---|---|
| pressure-r3 | refGPU | cudss-release17v3 | 8 | 32.80, 32.05, 33.34 | 3/3 |
| pressure-r3 | GPU | cudss-lag17 | 8 | 32.52, 35.00, 32.46 | 3/3 |
| pressure-r4 | refGPU | cudss-release17v3 | 8 | 86.02, 87.66, 91.54 | 3/3 |
| pressure-r4 | GPU | cudss-lag17 | 8 | 81.94, 84.63, 85.15 | 3/3 |
専用経路を適用できない入力の照合
| 変えた条件 | 実際の経路 | 変位 相対L2 | 応力 相対L2 | CPU直接解との比較 |
|---|---|---|---|---|
| 節点番号をシャッフル | 通常の行列を使用 | 8.51e-10 | 6.37e-13 | 合格 |
| 厚み方向で材料を変更 | 通常の行列を使用 | 1.06e-14 | 1.36e-10 | 合格 |
| ゼロでない強制変位 | 通常の行列を使用 | 8.51e-11 | 2.36e-09 | 合格 |
追加の接触試験で、ばねを軟らかくした入力の一部はエネルギーが非数になり、速度評価から除外した。完走メッセージだけでは精度合格と見なしていない。
動的接触の時刻別照合
出力10時点の全節点変位と接触合力、およびログのエネルギー出力を独立CPU参照と比較した。変位は各時点の相対L2の最大、力は最大絶対差、エネルギー差は最大値で正規化。エネルギーのコード間一致は、力学系のエネルギー保存を意味しない。
| モデル | 条件 | 回数 | 変位の相対差 | 接触合力差 N | エネルギーの相対差 | 受理した刻み数 |
|---|---|---|---|---|---|---|
| pressure-r3 | old | 3 | 1.06e-08 | 0.00e+00 | 0.00e+00 | 75 |
| pressure-r3 | new | 3 | 1.84e-08 | 0.00e+00 | 3.48e-08 | 75 |
| pressure-r3 | cpu | 3 | 1.84e-08 | 0.00e+00 | 0.00e+00 | 75 |
| pressure-r3 | supplement | 3 | 1.85e-08 | 0.00e+00 | 3.48e-08 | 75 |
| pressure-r4 | old | 3 | 1.79e-08 | 0.00e+00 | 0.00e+00 | 75 |
| pressure-r4 | new | 3 | 1.68e-08 | 0.00e+00 | 0.00e+00 | 75 |
| pressure-r4 | cpu | 3 | 1.56e-08 | 0.00e+00 | 0.00e+00 | 75 |
| pressure-r4 | supplement | 3 | 1.27e-08 | 0.00e+00 | 0.00e+00 | 75 |
前回の行列分解を何回使えたか
各条件の最初の検証済み実行から抽出。分解を使い回しても現在の行列で倍精度の残差を計算し、基準を満たせない場合はその時点の行列を分解し直した。分解が不要になった回数と、解析全体の時間短縮は分けて評価する。
| モデル | 条件 | 混合精度で解けた回数 | 総補正回数 | 前回分解の再利用成功 | 前回分解を棄却 | 再利用時の最大残差 |
|---|---|---|---|---|---|---|
| pressure-r3 | 比較GPU | 250 | 448 | 0 | 0 | — |
| pressure-r3 | 前回分解を試すGPU | 250 | 532 | 76 | 62 | 9.97e-12 |
| pressure-r4 | 比較GPU | 252 | 590 | 0 | 0 | — |
| pressure-r4 | 前回分解を試すGPU | 252 | 653 | 72 | 64 | 9.69e-12 |
どれだけメモリを使ったか
別実行でのLinux子プロセスの最大常駐メモリ(wait4)と、GPU 0 全体の使用メモリを約25 msごとに読んだ最大増分(NVML)。GPU値は起動前基準からの差で、サンプル間のピークを取り逃すことがある。これらの計測付き実行時間を速度表に含めていない。
| モデル | 条件 | ホスト最大RSS GiB | GPU使用量の増分 GiB | サンプル数 |
|---|---|---|---|---|
| cube104 | old | 5.58 | 8.63 | 300 |
| cube104 | new | 5.09 | 0.84 | 131 |
| cube104 | cpu32 | 4.68 | — | 219 |
| plate-million | old | 6.55 | 5.88 | 571 |
| plate-million | new | 4.58 | 0.87 | 144 |
| plate-million | cpu32 | 4.15 | — | 372 |
| cube144 | new | 12.81 | 1.30 | 298 |
| cube144 | cpu32 | 12.41 | — | 499 |
解析解がある大規模モデルでの規模検証
一辺110 mmの鋼の立方体に、軸方向120 MPa、側面に約51.43 MPaの引張り応力を与え、片側の面を固定。理論上は軸方向にだけ一様に伸びる。8積分点の要素内力に加えて、全節点の変位・応力・ひずみをこの独立な数式と照合し、支持反力 −1.452 MN も確認した。新たな規模に適用できるかを調べた別入力・各1回の実行であり、上の3回中央値と倍率を混ぜない。全場の対解析解相対L2誤差5×10⁻⁶を基準とした。標準版の六面体の節点換算係数は定数場に対する和が0.99996で、ソルバー残差が小さくても出力応力に約0.004%の偏りが生じる。高精度版ではこの係数を2点ガウス位置から理論式で求めた。主要な速度比較にはこの出力仕様の変更を入れていない。
| 自由方程式数 | 実行条件 | 節点値の換算 | 全体 秒 | 変位/解析解 相対L2 | 応力/解析解 相対L2 | 力の相対残差 | 照合 |
|---|---|---|---|---|---|---|---|
| 104,544 | A100 1枚 | 標準の出力換算 | 0.59 | 9.22e-07 | 4.13e-05 | 1.89e-12 | 基準外 |
| 104,544 | CPU 32コア | 標準の出力換算 | 0.46 | 9.22e-07 | 4.13e-05 | 1.89e-12 | 基準外 |
| 104,544 | A100 1枚 | 高精度の出力換算 | 0.55 | 9.22e-07 | 2.88e-07 | 1.89e-12 | 合格 |
| 104,544 | CPU 32コア | 高精度の出力換算 | 0.56 | 9.22e-07 | 2.88e-07 | 1.89e-12 | 合格 |
| 12,442,080 | A100 1枚 | 標準の出力換算 | 10.73 | 9.43e-07 | 4.13e-05 | 3.29e-12 | 基準外 |
| 12,442,080 | CPU 32コア | 標準の出力換算 | 14.39 | 9.43e-07 | 4.13e-05 | 3.43e-12 | 基準外 |
| 12,442,080 | CPU 32コア | 高精度の出力換算 | 17.34 | 9.43e-07 | 2.88e-07 | 3.58e-12 | 合格 |
立方体の6面に異なる一様圧力を与えた検算では、全6,144面のベクトル合力が手計算と一致(−9,000, −2,000, −8,000 N)。全節点の出力は独立CPU直接解と照合した。
厚みで材料が変わる平板を解く
上半分と下半分でヤング率とポアソン比が異なる平板。追加版は各層の厚さと全要素の材料定数を実際に比較して、等しい層の係数だけを共有した。元の均一厚板用の版は通常の行列を使用する。主要な中央値には入らない各1回の適用確認。
| モデル | 条件 | 全体 秒 | 実際の経路 | 応力の相対L2 |
|---|---|---|---|---|
| 厚み方向に材料2種類(2.87万要素) | GPU・層別候補 | 0.69 | GPU extruded equilibrium PCG | 1.38e-10 |
| 厚み方向に材料2種類(2.87万要素) | CPU・層別候補 | 1.12 | CPU extruded equilibrium PCG | 1.37e-10 |
| 厚み方向に材料2種類(2.87万要素) | GPU・通常行列 | 1.00 | GPU PCG | 1.35e-10 |
| 厚み方向に材料2種類(30.72万要素) | GPU・層別候補 | 15.83 | 直接法に切替 | 9.69e-10 |
| 厚み方向に材料2種類(30.72万要素) | CPU・層別候補 | 53.73 | 直接法に切替 | 6.05e-09 |
| 厚み方向に材料2種類(30.72万要素) | GPU・通常行列 | 15.32 | 直接法に切替 | 7.65e-10 |
配布ZIPから生成・復元した入力 11 件を実機で使用したファイルとSHA-256照合し、全件一致した。
配布ソースのGPU版 1216 ファイルとCPU版 1206 ファイルは、実機でクリーンビルドしたソースツリーと SHA-256 で一致。入力と実行バイナリの照合値は証跡に記録した。