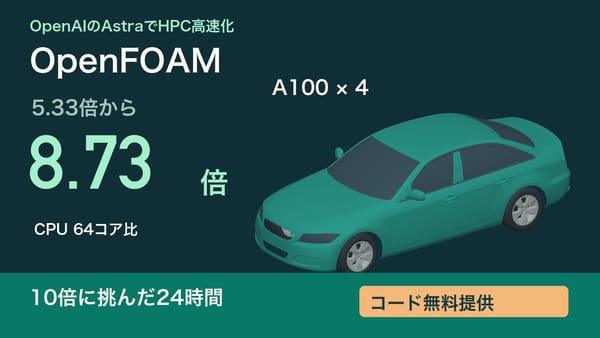
OpenAIのAstraでHPCプログラムをどこまで高速化できるか?|第1回 OpenFOAMでCPU 64コア比8.73倍に至るまで
CPUで1時間48分40秒かかった車体まわりの流体計算が、A100を4枚使うと12分27秒で終わった。同じ4枚でも、出発点は1時間を超えていた。何を測って、どこを変えたのか。
以前にも、A100とHGX B200でOpenFOAMの高速化を試した。それでも、思うような成果は出なかった。もう一度A100で挑んだのが、流体解析ソフトOpenFOAMで、自動車「DrivAer」のまわりの空気の流れを解くこの実験だ。Astraと一緒にHPCアプリを高速化する連載を、この再挑戦から始めたい。
1.71倍の時点で、私がAstraに頼んだこと
CPUの64物理コアで6,520.41秒。手元のGPU版は3,817.30秒。4枚使って1.71倍なら、まずは3倍を狙ってみたい。目標は2,173秒。あと約1,644秒、1反復あたり平均3.4秒をどこから削るか。そこで、私はこう尋ねた。
「NVIDIAのGPU専用のプロファイラーでプロファイリングすれば、どこが削れるかというヒントが出てくるのではありませんか。」
Astraが調べたのは、403〜405反復目の3回だった。NVIDIA Nsight Systemsで見ると、CPUからGPUへの統合メモリの移動が1反復に7.18 GB。GPUからCPUへも7.18 GB。4枚を合計すると、わずか1反復で14.36 GBが往復していた。また、8つのMPIプロセスのうち1つを調べると、GPUの処理が終わるのを待つための関数を、1反復あたり約2万4,600回呼び出していた。この回数だけでは、どの処理を直せば計算時間を短くできるかは分からない。そこで、CPUとGPUの間で大量のデータが移動したときに、プログラムのどの部分が動いていたかを調べた。
壁の隣にあるセルは、次の反復でも同じだった
手掛かりの一つは、車体表面などの境界で値を更新する処理だった。この計算では格子は動かない。それでも、境界の値を求めるたび、広い範囲を走査していた。境界面とセルの対応を一度調べて使い回し、同じセルに足し込む値はまとめて処理する。圧力補正に使う配列もGPU上で扱い、同じデータを読む回数を減らした。
乱流モデルの計算や通信も組み合わせて見直した後、同じ3反復で測り直した。統合メモリの往復は14.36 GBから1.76 GBへ。そこでプロファイラーを外し、今度は480反復を最後まで走らせた。20分23秒。CPU比5.33倍で、最初の目標を超えた。どれか一つの修正にこの短縮のすべてを割り当てることはできないが、データ移動を測ったことで、次に読むべきコードが絞れた。 初期版から5.33倍までの実測記録
| 480反復を完走した構成 | 経過時間 | CPU比 |
|---|---|---|
| CPU 64物理コア | 6,520.41秒 | 1.00倍 |
| A100 × 4・初期のGPU版 | 3,817.30秒 | 1.71倍 |
| 境界・圧力・乱流・通信を改良 | 1,222.71秒 | 5.33倍 |
| 4分割・格子の並べ替えなどを採用 | 906.07秒 | 7.20倍 |
| 11月11日 正午のGPU版 | 775.70秒 | 8.41倍 |
| 同日 最終版 | 747.17秒 | 8.73倍 |
起動で約20秒先行した案が、最後に逆転された
5.33倍の段階ではGPU 1枚に2つのMPIプロセスを置いていた。その後は1枚に1プロセスとし、空間的に近いセルがメモリ上でも近くなるように並べ替えるなどして、906.07秒まで縮めた。さらに隣接セルの番号を16ビットで扱える箇所に圧縮を入れ、通信の準備や乱流計算の中間結果を再利用すると、正午の段階で775.70秒になった。そこで私は、残り数%を狙って、もう一度試すことにした。
最後の候補の違いをよく表していたのが、車体の壁面までの距離だった。静止した格子なら、前回求めた距離を次の起動で読み込める。その構成は、最初の反復を始めるまで16.84秒。一方、起動するたび距離を求め直す構成は36.41秒かかった。この瞬間だけを見れば、採るべき案は決まったように見える。
ところが480反復を終えると、順位が入れ替わった。
| 最終候補(各2回) | 最初の反復まで | 通常の1反復¹ | 終了まで |
|---|---|---|---|
| 壁面距離を再利用する構成 | 16.84秒 | 1.440秒 | 751.09秒 |
| 壁面距離を毎回求める構成 | 36.41秒 | 1.401秒 | 747.17秒 |
¹ 通常反復の中央値を各実行で求め、2回分を平均。終了までの時間には初回反復や書き出しも含む。
毎回求めるほうの構成では、格子情報の構築、圧力計算の途中集計、隣接セル番号の読み方にも手を入れている。起動後にも差が積み重なり、全体で3.92秒先に終わった。この比較で選べたのは、私たちの480反復を速く終える構成の組み合わせだ。壁面距離の再利用だけを切り替えた際の効果を測るには、ほかの設定をそろえた対照試験が要る。
二つの一致を区別する
最終版の独立2回は747.678秒と746.664秒。6,520.406 ÷ 747.171 ≈ 8.73。正午版から最後に削ったのは、平均28.53秒だった。この間で計算結果が変わったかも調べた。正午のGPU版と最終版では、全480反復の力係数や残差の記録が一致し、840反復目に書き出した6種類の場も、4領域すべてで24ファイルがバイト単位で一致した。
一方、CPU版と最終GPU版を比べると、同じ840反復目の速度場には差がある。各セルを等しく数えた相対L2差は19.35%、セル体積で重み付けすると0.352%だった。抗力・揚力の定常判定も満たしていない。8.73倍は、決めた480反復にかけた時間の比だ。設計上必要な精度に到達するまでの時間は、別途測る必要がある。 最終版の計測・数値比較
計測条件 OpenFOAM v2606のsimpleFoam、倍精度、65,334,765セル。Xeon Gold 6430 × 2(64物理コア・64 MPIランク)とA100 PCIe 80 GB × 4(最終版は4 MPIランク)。同じ400反復目の保存場から401〜880を実行。各外側反復の速度3成分は各15回、圧力12回、乱流量k・ωは各8回。MPIの起動、初期化、4回の場出力、終了を含み、領域分割とセルの並べ替えは計時外。
次のアプリで、最初に測るもの
今回、私がAstraに向けた問いのうち、次にも持っていきたいのは「1反復で、何がどこへ動いたか」だ。次回は別のHPCアプリを取り上げる。まず普段使う入力を一つ選び、どの出力がどこまで合えば同じ仕事をしたと言えるのかを決める。そして最初のプロファイルを開く。そこで一番長く見えるのは、計算か、通信か、それとも別の処理だろうか。