CPUで5分半の地震波計算。公開GPU版で16秒、Astraで11秒へ|OpenAIのAstraでHPC高速化・第3回
SPECFEM3Dで同じ地震波を計算し、CPU 64コアの329.49秒から公開GPU版で16.09秒、Astra改良版で10.96秒へ。均質な地盤と二層地盤で、係数を表にまとめる工夫がどこまで使えたかを実測しました。
震源から出た波が地盤を伝わり、6地点の揺れがファイルに残るまで、CPU 64コアで329.49秒。約5分半だ。同じ地盤を、SPECFEM3Dの開発元が提供しているGPU版で解くと、A100を4枚使って16.09秒だった。ここまででCPUの20.47倍の速さになる。
そこから、同じ4枚のままAstraとコードを改良し、10.96秒まで縮めた。公開GPU版からさらに1.47倍、CPUから通して見ると30.07倍だ。初期の改良は公開GPU比1.19倍で、一度は限界に近いかと思った。突破口の一つは、GPUが繰り返し読み出す係数を数え直したことだった。
| 実行構成 | 開発元の公開版 | Astra改良版 | 同じ構成での高速化倍率 |
|---|---|---|---|
| CPU 32コア | 483.87秒 | 未測定 | — |
| CPU 64コア | 329.49秒 | 未測定 | — |
| GPU 1枚 | 54.09秒 | 35.44秒 | 1.53倍 |
| GPU 2枚 | 28.49秒 | 19.17秒 | 1.49倍 |
| GPU 4枚 | 16.09秒 | 10.96秒 | 1.47倍 |
なぜ、均質な地盤で試すのか
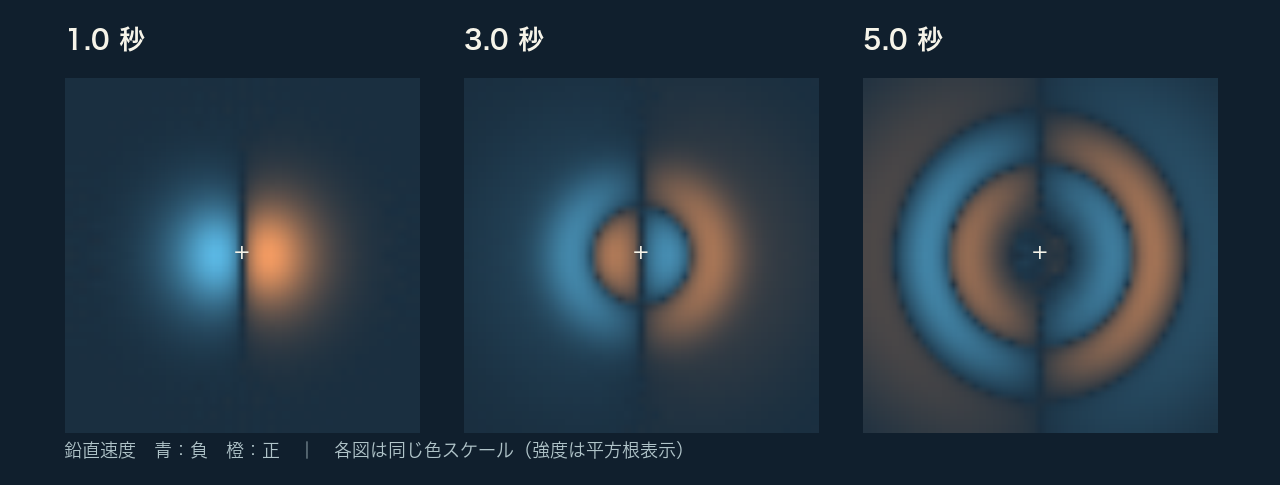
使ったのはオープンソースの地震波シミュレーター、SPECFEM3Dだ。まず、密度も波の速さもどこで測っても同じ、仮想の地盤を用意した。実際の地下には異なる岩石や堆積物が重なり、その境目で波の一部が反射する。均質な地盤なら、震源から受け取る波形を理論式で別に求められる。プログラムを速くした結果、波が早く着きすぎたり、振幅が変わったりしていないかを、その波形と照合できる。
この一辺32 kmの立方体を、縦・横・高さの各方向に64分割した。64×64×64で262,144要素になる。中央の震源で揺れが生まれると、周囲の地盤が変形し、それを押し戻す力が隣へ伝わる。このモデルでP波の速度は秒速2,800 m、S波は秒速1,500 m。少し離れた観測点では、揺れの向きも到着時刻も違ってくる。
1ミリ秒ずつ14,000ステップ進め、6地点で東西・南北・上下の変位を保存する。公開版も改良版も、用意済みの同じメッシュを使う。時計はMPIプロセスの起動直前にスタートし、観測記録を書き終え、ソルバーが終了したところで止めた。
約1,280万個の係数を数え直した
最初の改良版をNsight Systemsで見ると、GPU 4枚のうちランク0では、1ステップ当たり、弾性力の計算に約422マイクロ秒、次の時刻の動きへの更新に約211マイクロ秒を使っていた。後者では、格子点にかかった力に「質量の逆数」を掛ける。力が同じなら、軽いものほど大きく加速する。今回の均質な地盤と規則的な格子では、GPU 1枚が使う約1,280万個の係数を調べると、値は29種類だった。
そこで、29種類の値を小さな表にまとめた。各格子点には1バイトの番号を持たせ、その番号で表から元の係数を取り出す。単精度で保存した値が完全に一致する場合だけ、同じ番号を割り当てる。
地層が変わっても、この表は使えるだろうか。密度が2,300 kg/m³と2,000 kg/m³で、波の速さも異なる二つの地層を水平に重ねて調べた。係数は4枚のGPUのそれぞれで73種類に収まり、表を使えた。ただし、実際の地形に沿って要素の形を変えたり、密度を地点ごとに与えたりすると、隣の点でも係数は少しずつ違いうる。今回の実装では、あるGPUの担当範囲で256種類を超えると、そのGPUは元の配列から係数を読み出す。実在地域の地盤モデルで何種類になるか、この工夫で何秒縮むかは未測定だ。
さらに地盤内部では、半ステップ前の運動量を次の計算に引き継ぎ、配列を読み書きする回数を減らした。吸収境界や診断出力に必要な箇所では通常の更新を使う。
効果を確かめるため、中規模モデルをA100 1枚で走らせ、同じ第4,150ステップをNsight Computeで測った。変更を重ねた後の更新処理は100.13マイクロ秒から64.35マイクロ秒へ。弾性力の計算も272.83から252.42マイクロ秒になった。一方、よく使う配列をGPUのL2キャッシュに優先して残す試作は遅くなり、採用を見送った。
公開GPU版から、あと5秒を縮める
4枚では公開版16.09秒、初期改良版13.64秒、最終版10.96秒。3つの版を順番を変えて各3回実行した中央値だ。9時時点の1.19倍はその時点の測定値で、上の3つの秒数は最終評価でそろえて測り直した値を使った。実行時間には、震源や観測点を探す準備、GPU初期化、通信、波形の保存も含まれる。
公開GPU版からの改良幅はA100 1枚でも1.53倍だった。格子点の読み書きを減らした効果は、GPU同士の通信が発生しない条件でも現れた。
計算しなかった場所の揺れも当たるか
もう一つ、実地震では条件が限られるが、このモデルで試す価値のある手があった。地盤が平坦で材質が一様、震源は中央にあり、その向きも決まっている。東西と南北に折り返すと、揺れのどの成分の符号が変わるかが分かる。対称面に合う境界条件を設け、震源の強さを4分の1にして、地盤の一象限だけを解いた。
要素の大きさも時間刻みも同じで、解く要素数は65,536個になる。実測は5.14秒。全領域の公開版16.09秒と比べて3.13倍だ。対称境界だけを追加した公開版も同じ一象限なら7.42秒で、両方を一象限にそろえたときの実装差は1.44倍だった。
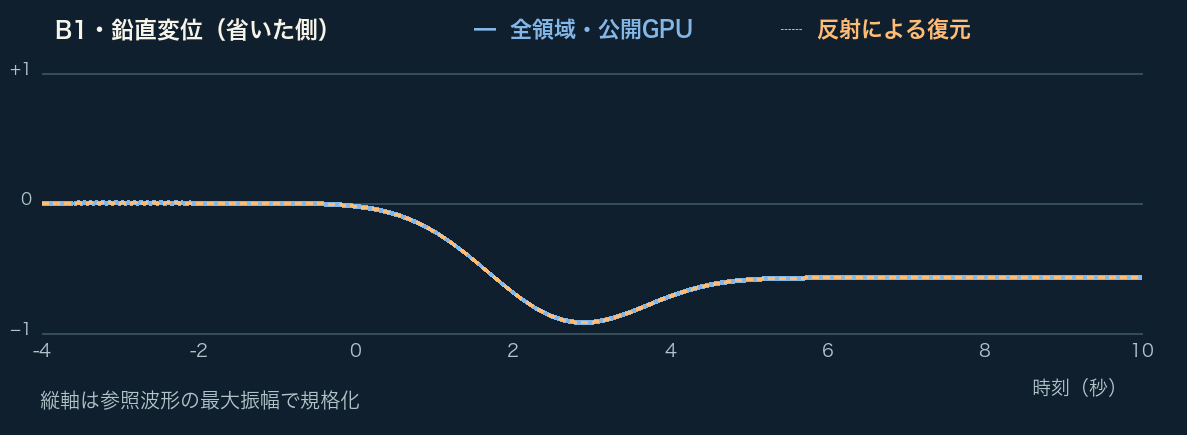
全領域の4象限に24個の観測点を配置し、各点の3成分、計72波形を比較した。全領域の公開GPU版に対する復元波形の相対L2誤差は0.052〜0.066%。地下構造や震源にこの対称性がなければ、4分の1領域の実験で得た倍率は持ち込めない。そこで、性質の違う地層を水平に二つ重ねた、別の規模のモデルでも全領域を解いた。A100 4枚の公開版で5.22秒、改良版で3.87秒、1.35倍だった。この1.35倍には他の改良の効果も含まれる。係数を表にした工夫だけで何秒縮んだかは、この比較からは分からない。この二層地盤に33の震源を非対称に置いた試験では、A100 1枚で1.27倍だった。特定の地域の地下構造を入れたときの速度や、実際の観測記録との一致は、今回の試験には含まれていない。
波形の精度は、変位と加速度で違った
主評価の変位は、6地点×3成分×14,000時刻の252,000サンプルで確かめた。波形全体の差を参照波形の大きさで割った相対L2誤差は、最終版でCPU版に対して0.0324〜0.0344%、解析解に対して0.0920〜0.1018%。同じ条件で測った公開GPU版のCPU版に対する差は0.0308〜0.0514%だった。
一方、変位・速度・加速度をすべて保存する別の中規模試験では、全周波数を含む加速度のCPU版との差は公開GPU版で45.0%、改良版で42.6%だった。公開GPU版と改良版の間でも27.7%の差があり、2 Hz以下だけを比較すると0.064%に下がった。加速度の鋭いピークを使う解析には、別途検証が要る。
「1.19倍が限界か」という問いに、この地盤の変位計算については答えが出た。1回の更新で読み出す約1,280万個の係数を数え直す。最後は、元と同じ地盤を解き、同じ観測点に同じタイミングで揺れが届くかを確かめる。その往復で、同じ4枚の待ち時間を16.09秒から10.96秒まで縮められた。