331万個の銅原子を動かす。LAMMPSの公開GPU版を同じ4枚で39秒から9秒へ|OpenAIのAstraでHPCプログラムを高速化する 第4回
331万個の銅原子を押す計算は、CPU 64コアで82.944秒、公開GPU版で38.998秒、Astra改良版で9.301秒。銅の断面の映像とともに、同じGPU 4枚で4.19倍まで縮めた過程を紹介します。
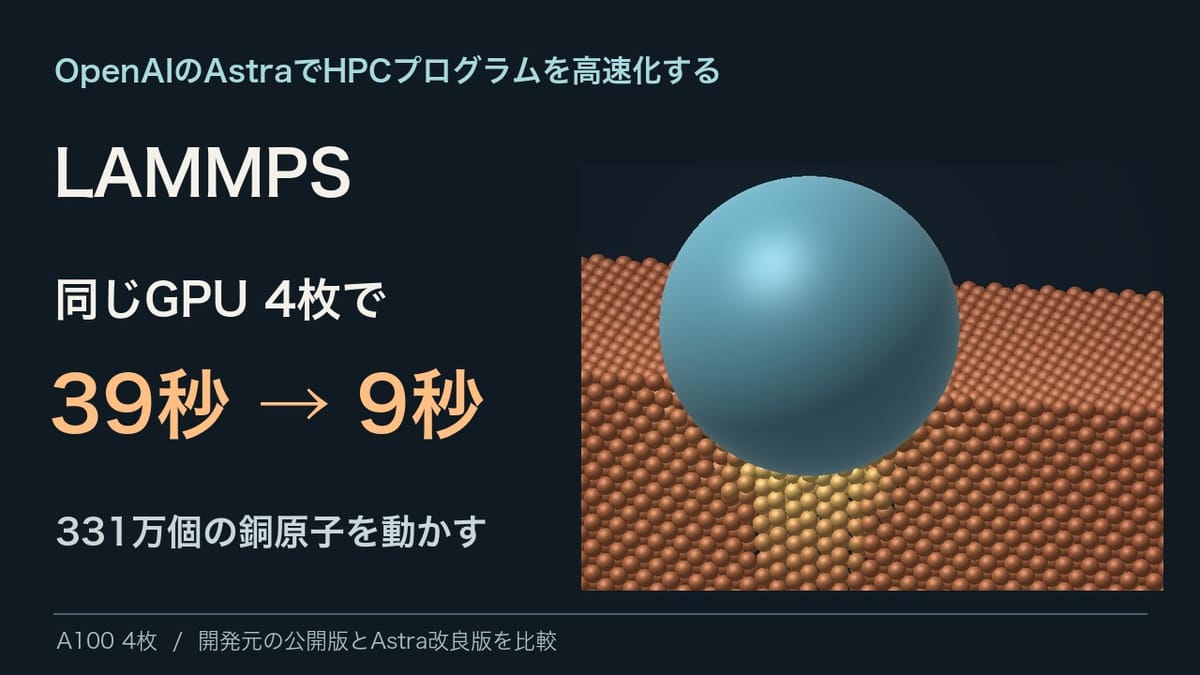
銅の板に小さな球を押し込むと、真下の原子が沈み、周囲の原子も動く。球を引き上げれば、銅が押し返す力は消える。では、へこんだ表面も元に戻るだろうか。分子動力学ソフトのLAMMPS(ランプス)を使って、その瞬間を原子一個ずつ追った。
331万7,760個の銅原子を使った押し込み計算は、公開CPU版の64物理コアで82.944秒。開発元が提供するGPU版なら、NVIDIA A100を4枚使って38.998秒で終わる。そこからAstraとコードや実行設定を改良し、同じ4枚で9.301秒まで縮めた。GPUに替えた効果が2.13倍、そのGPU版からの上積みが4.19倍。出発点の公開CPU版と比べると8.92倍だ。
ステップ番号を一つ読むのに、なぜ全原子の座標が要るのか
球の位置は、計算を何ステップ進めたかで決まる。1ステップごとに球を少しずつ下げるだけなら、必要な情報は現在のステップ番号一つだ。ところがGPUの実行をNsight Systemsで追うと、その番号を読む経路で全原子の座標、速度、力までCPUへ戻していた。銅をもう一度押す前に、大きなデータの往復が挟まっていた。
そこで、式がステップ番号だけを必要とする場合は、その転送を省いた。この変更だけを切り替えてA100を1枚使い、同じ120ステップを測ると、全原子の座標をGPUからCPUに転送した回数は159回から39回に減った。座標を実際に使う式では、必要なデータを従来どおり受け渡す。
球が原子を押す力もGPU上で計算した。また、単一元素の銅では、隣の原子も銅だと分かっている。同じ銅同士の係数を繰り返し探す手間を省き、変化する原子間の距離と力は毎ステップ求めた。通常の原子形式ではテキスト入力の数値も直接読み取るようにした。最終的な倍率には、これらの変更と、構成ごとに選んだ並列実行の設定がすべて含まれる。
82万9,440原子では、速く終わったのはGPU 2枚
各行で解いたのは、同じ平衡化済みの銅に半径2 nmの球を0.6 nm動かす問題だ。銅原子の相互作用には同じEAMポテンシャルを使い、すべて倍精度で計算した。1ステップは1フェムト秒で、計1,500ステップ。時計は計算プロセスの起動直前にスタートし、初期配置の読み込み、20ステップごとの荷重・エネルギー出力、終了処理までを含めた。
| 実行構成 | 開発元の公開版 | Astra改良版 | 同じ構成での高速化倍率 |
|---|---|---|---|
| CPU 32物理コア | 34.704 秒 | 30.145 秒 | 1.15倍 |
| CPU 64物理コア | 27.115 秒 | 22.968 秒 | 1.18倍 |
| A100 1枚 | 28.677 秒 | 7.236 秒 | 3.96倍 |
| A100 2枚 | 23.068 秒 | 5.342 秒 | 4.32倍 |
| A100 4枚 | 19.297 秒 | 5.537 秒 | 3.49倍 |
各構成で公開版と改良版を交互に5回ずつ実行した中央値。計測機はIntel Xeon Gold 6430を2基とA100 80 GB PCIeを4枚搭載する。CPU基準は速かった公開64コアの27.115秒。公開GPU版の効果は1枚から順に0.95倍、1.18倍、1.41倍。改良GPU版はそれぞれCPU比3.75倍、5.08倍、4.90倍だった。
改良版の2枚と4枚を比べると、原子の運動を時間順に解くループは2.637秒から2.069秒へ短くなった。一方、起動から終了までの実時間は5.342秒から5.537秒に延びた。ループで稼いだ約0.57秒を、それ以外の処理で使い切っている。1回の結果を早く手元に戻すなら、この試料では2枚が速かった。
同じ銅の板を4倍に広げると、GPU 4枚が生きる
試料を横に2枚、奥に2枚分並べて、銅の板を広げた。押す球は中央の1個、球の移動距離もステップ数も同じだ。原子数は4倍になり、離れた場所にある原子の運動も追う。ここでは試料を複製する時間も含めて測った。
| 実行構成 | 開発元の公開版 | Astra改良版 | 同じ構成での高速化倍率 |
|---|---|---|---|
| CPU 32物理コア | 107.810 秒 | 104.341 秒 | 1.03倍 |
| CPU 64物理コア | 82.944 秒 | 75.758 秒 | 1.09倍 |
| A100 1枚 | 100.088 秒 | 21.925 秒 | 4.56倍 |
| A100 2枚 | 56.531 秒 | 12.316 秒 | 4.59倍 |
| A100 4枚 | 38.998 秒 | 9.301 秒 | 4.19倍 |
代表値は各3回の中央値、A100 4枚のみ公開版と改良版を交互に各5回計測した中央値。公開4枚では開発元のGPUパッケージとKOKKOSパッケージを試し、この問題で速かったGPUパッケージを採用した。
| 実行構成 | 公開版のGPU化の効果 | 同じGPU枚数での上積み | 改良GPU版のCPU比 |
|---|---|---|---|
| A100 1枚 | 0.83倍 | 4.56倍 | 3.78倍 |
| A100 2枚 | 1.47倍 | 4.59倍 | 6.73倍 |
| A100 4枚 | 2.13倍 | 4.19倍 | 8.92倍 |
公開GPU版は1枚だと100.088秒で、公開CPU版の64コアより時間がかかった。4枚なら38.998秒でCPUの約半分。改良後は1枚から2枚、2枚から4枚へと増やすたびに短くなり、4枚で9.301秒になった。小さい試料だけで「この計算には2枚が最適」と判断していたら、この逆転を見落としていた。
荷重が消えたあと、銅の表面には何が残ったか
速度を測った1,500ステップでは、公開CPU版と各構成の荷重・エネルギーを76時点で照合した。小さい試料では最終時点の全原子をIDで対応づけ、公開CPU版と改良GPU版の位置の差は最大2.69×10⁻¹² Åだった。
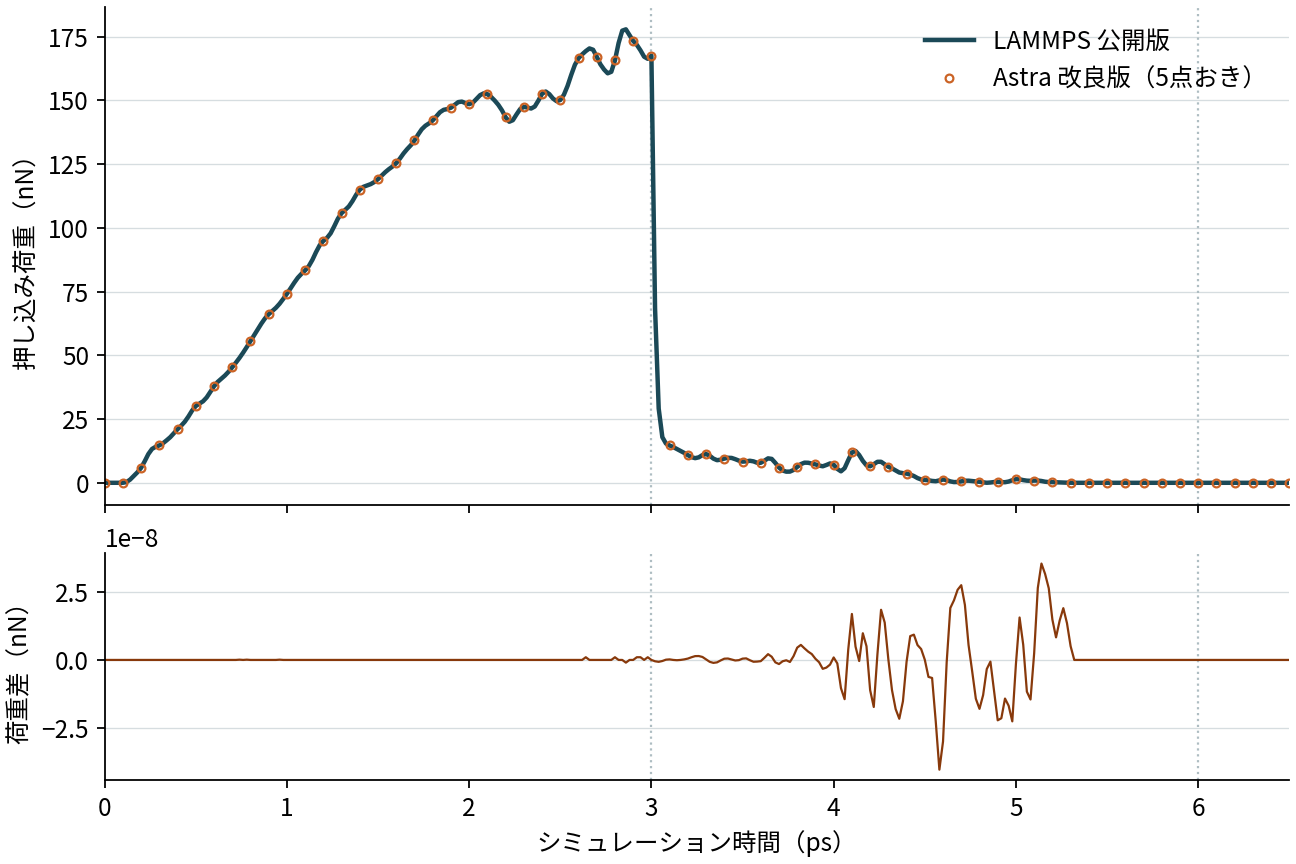
冒頭の動画では、同じ小さい試料で計算を6,500ステップまで延ばした。3ピコ秒かけて球を1.2 nm動かし、次の3ピコ秒で元の高さに引き上げ、さらに0.5ピコ秒観察した。球が最も強く押し返されたのは、最深点に着く少し前の2.86ピコ秒。公開版も改良版も177.832 nNで、326時点の荷重差は最大4.06×10⁻⁸ nNだった。映像用に原子座標を細かく保存し直した計算も、同じ326時点で公開版と照合した。
最後に球を画面から外すと、荷重がゼロに戻った銅に浅いくぼみが見える。表示した側の表面で、最初に球の中心軸から半径0.8 nm以内の最上層にいた18原子を追うと、6.5ピコ秒の時点で初期位置より下に動いた距離の中央値は0.33 nmだった。約39秒を9秒に縮めても、金属がいちばん強く球を押し返す瞬間を再現できた。
測定記録と構成別の時間内訳を開く
829,440個の銅原子を用意し、半径20 Åの球を6 Å移動させた。初期状態では球と表面の間に0.25 Åの隙間がある。1ステップは1 fsで、計算は1,500ステップ(1.5 ps)。金属結合を表すEAMポテンシャルと倍精度演算を全構成で共通にした。
同じ問題を解く実時間
| 実行構成 | 開発元の公開版 | Astra改良版 | 同じ構成での高速化倍率 |
|---|---|---|---|
| CPU 32物理コア | 34.704 秒 | 30.145 秒 | 1.15倍 |
| CPU 64物理コア | 27.115 秒 | 22.968 秒 | 1.18倍 |
| A100 1枚 | 28.677 秒 | 7.236 秒 | 3.96倍 |
| A100 2枚 | 23.068 秒 | 5.342 秒 | 4.32倍 |
| A100 4枚 | 19.297 秒 | 5.537 秒 | 3.49倍 |
プロセスの起動直前から終了まで。初期原子配置・速度のテキスト読み込みと20ステップごとの出力を含む。各構成の代表値は独立した5回の中央値。公開版と改良版を交互に実行した。構成は予備測定で選び、この表には別途測定した値を使った。
GPU化の効果とAstra改良の効果
| 構成 | 公開CPU÷公開GPU | 同じ枚数の公開GPU÷改良GPU | 改良GPUのCPU比 |
|---|---|---|---|
| A100 1枚 | 0.95倍 | 3.96倍 | 3.75倍 |
| A100 2枚 | 1.18倍 | 4.32倍 | 5.08倍 |
| A100 4枚 | 1.41倍 | 3.49倍 | 4.90倍 |
CPU基準は32・64物理コアのうち速かった公開版の27.115秒。実機はXeon Gold 6430を2基、NVIDIA A100 80GB PCIeを4枚搭載している。
荷重とエネルギーの照合
押し込み荷重、ポテンシャルエネルギー、運動エネルギーを76時点で公開CPU版の基準軌跡と照合した。全試行中の最大差は順に 1e-10 nN、0 eV/原子、1.21e-15 eV/原子。許容値は荷重が10⁻⁵ nN、各エネルギーが10⁻⁸ eV/原子。原子数と押し込み距離も照合した。
押した球を引き抜くとどうなるか
別に実行した6,500ステップの試験では、球を3 psまで押し込み、6 psまでに引き抜いた。4枚GPUの公開版と改良候補の荷重ピークは同じ2,860ステップ目で、ともに177.832 nN。全326時点の荷重差は最大4.06e-08 nNだった。
何を変えたか
押し込み位置を決める式の中で、時刻を表すステップ番号を読むたびに全原子の座標・速度・力がCPUに戻っていた。番号だけを読むときはこの転送を省き、球から受ける力をGPU上で計算した。物理量を参照する式には従来の処理を残した。
単一元素の銅では、原子種ごとに同じ係数を毎回探す処理を省ける。原子間の距離と力は毎ステップ求めた。合金では従来の元素対ごとの計算に戻る。テキスト入力については、通常の原子形式で数値を直接読み取る経路を追加した。
CPUと複数GPUの設定
CPUでは公開版にもXeon向けのINTELパッケージを適用し、MPIランク数とスレッド数を振った。真空を含む表面側は原子数が少ないので、z方向の領域境界を動かして負荷をそろえた。4枚のA100はNVLinkでつながった2枚組が2組ある。この実機では2枚で有効なCUDA IPC通信を4枚に広げると、複数の設定で原子座標が不正になった。4枚の最終比較には全時点で数値検証を通った通信設定を使った。
829,440原子の主試験では、時間積分ループだけなら2枚の2.637秒から4枚の2.069秒に縮まった。一方、起動・読み込み・終了を含めた実時間は2枚が5.342秒、4枚が5.537秒だった。GPU枚数の比較にはこの実時間を採用した。
最終ステップでは全829,440原子をIDで対応づけて位置、速度、力を比較した。公開CPU版に対するGPU3構成の最大差は位置2.69e-12 Å、原子ごとの力1.42e-11 eV/Åだった。
プロファイラで見えた転送
Nsight Systemsで1枚GPUの300ステップを追跡した。開発途中の2版を比べると、起動と入出力を含むGPUからCPUへの転送量は23.72 GBから3.36 GBに減った。さらにステップ番号の修正だけを切り替えた120ステップの対照試験では、全原子座標の転送が159回から39回に減った。転送が不要な理由を呼び出し元まで確認してから、この処理を省いた。
計測区間と試行間の幅
| 構成 | 実行ファイルの保存名 | MPIランク | 計算ループ中央値(秒) | 入力読み込み中央値(秒) | 実時間の最小–最大(秒) |
|---|---|---|---|---|---|
| C32 公開版 | intel-stock | 32 | 24.811 | 4.129 | 34.655–35.500 |
| C32 改良版 | intel-astra | 16 | 26.061 | 0.411 | 29.978–31.532 |
| C64 公開版 | intel-stock | 16 | 20.390 | 3.023 | 26.852–27.806 |
| C64 改良版 | intel-astra | 16 | 18.959 | 0.409 | 22.767–23.698 |
| G1 公開版 | lammps-hpcx-gpu | 4 | 22.895 | 3.167 | 28.561–28.883 |
| G1 改良版 | lanes4 | 1 | 4.532 | 0.376 | 7.201–7.284 |
| G2 公開版 | lammps-hpcx-gpu | 8 | 14.618 | 4.339 | 21.837–23.415 |
| G2 改良版 | lanes4 | 2 | 2.637 | 0.388 | 5.279–5.358 |
| G4 公開版 | lammps-hpcx-kokkos | 4 | 13.189 | 3.196 | 19.204–19.356 |
| G4 改良版 | coefficients | 4 | 2.069 | 0.512 | 5.458–5.670 |
CPU側もMPIランク数とスレッド数を完全にそろえて実行ファイルだけを交換した。各3回の中央値で、32物理コアで1.14倍、64物理コアで1.21倍だった。
実行ファイルだけを交換した比較
同じKOKKOSパッケージ、入力スクリプト、MPIランク数、通信方式で実行ファイルだけを交換した。各3回の中央値。冒頭の表では公開版が選べる別のGPUパッケージも含めて速い構成を採用している。
| 実行構成 | 公開KOKKOS | Astra改良版 | 同一条件での倍率 |
|---|---|---|---|
| A100 1枚 | 48.298 秒 | 7.271 秒 | 6.64倍 |
| A100 2枚 | 28.638 秒 | 5.321 秒 | 5.38倍 |
| A100 4枚 | 19.565 秒 | 5.538 秒 | 3.53倍 |
試料を331万7,760原子に広げると
同じ平衡化済み試料を水平方向に2×2個並べ、中央の球1個で同じ距離だけ押し込んだ。この追加試験は試料複製の時間を含む。大きい試料用に公開CPU版の基準軌跡を別途計算した。
| 実行構成 | 開発元の公開版 | Astra改良版 | 同じ構成での高速化倍率 |
|---|---|---|---|
| CPU 32コア | 107.810 秒(3回) | 104.341 秒(3回) | 1.03倍 |
| CPU 64コア | 82.944 秒(3回) | 75.758 秒(3回) | 1.09倍 |
| A100 1枚 | 100.088 秒(3回) | 21.925 秒(3回) | 4.56倍 |
| A100 2枚 | 56.531 秒(3回) | 12.316 秒(3回) | 4.59倍 |
| A100 4枚 | 38.998 秒(5回) | 9.301 秒(5回) | 4.19倍 |
大きい試料のCPU比
| 構成 | 公開CPU÷公開GPU | 同じ枚数での上積み | 改良GPUのCPU比 |
|---|---|---|---|
| A100 1枚 | 0.83倍 | 4.56倍 | 3.78倍 |
| A100 2枚 | 1.47倍 | 4.59倍 | 6.73倍 |
| A100 4枚 | 2.13倍 | 4.19倍 | 8.92倍 |
大きい試料の公開4枚版では、KOKKOSが53.618秒、GPUパッケージが39.332秒(GPU1枚あたり4 MPIランク)だった。速かったGPUパッケージを採用し、表の4枚の値は公開版と改良版を交互に5回再測定した中央値とした。
読み込みとループの時間はLAMMPSのログに基づく。起動や終了などの時間があるため、両者の合計より実時間は長い。