シリコン完全結晶でGPU 1枚が公開版の4枚を追い越した|Quantum ESPRESSO|OpenAIのAstraでHPCプログラムを高速化する 第5回
4枚のA100が12.55秒かけて解いた問題を、1枚で11.60秒。同じ216原子の電子密度と波動関数がそろうまでを測って、この順番になった。手がかりの一つは、シリコン原子の規則正しい並び方だった。では、その列から原子を1個抜いたら、どれだけの速さが残るだろう。
4枚のA100が12.55秒かけて解いた問題を、1枚で11.60秒。同じ216原子の電子密度と波動関数がそろうまでを測って、この順番になった。手がかりの一つは、シリコン原子の規則正しい並び方だった。では、その列から原子を1個抜いたら、どれだけの速さが残るだろう。
シリコンの中で、電子はどこに集まるか
シリコンの結晶では、各原子が四つの隣の原子と結びついている。下の図の赤い領域は、原子が結晶になると電子がどこに集まるかを示している。今回使ったオープンソースのQuantum ESPRESSO(クオンタム・エスプレッソ)は、原子の種類と配置をもとに、こうした電子の状態や、そこから原子に働く力を計算できる。
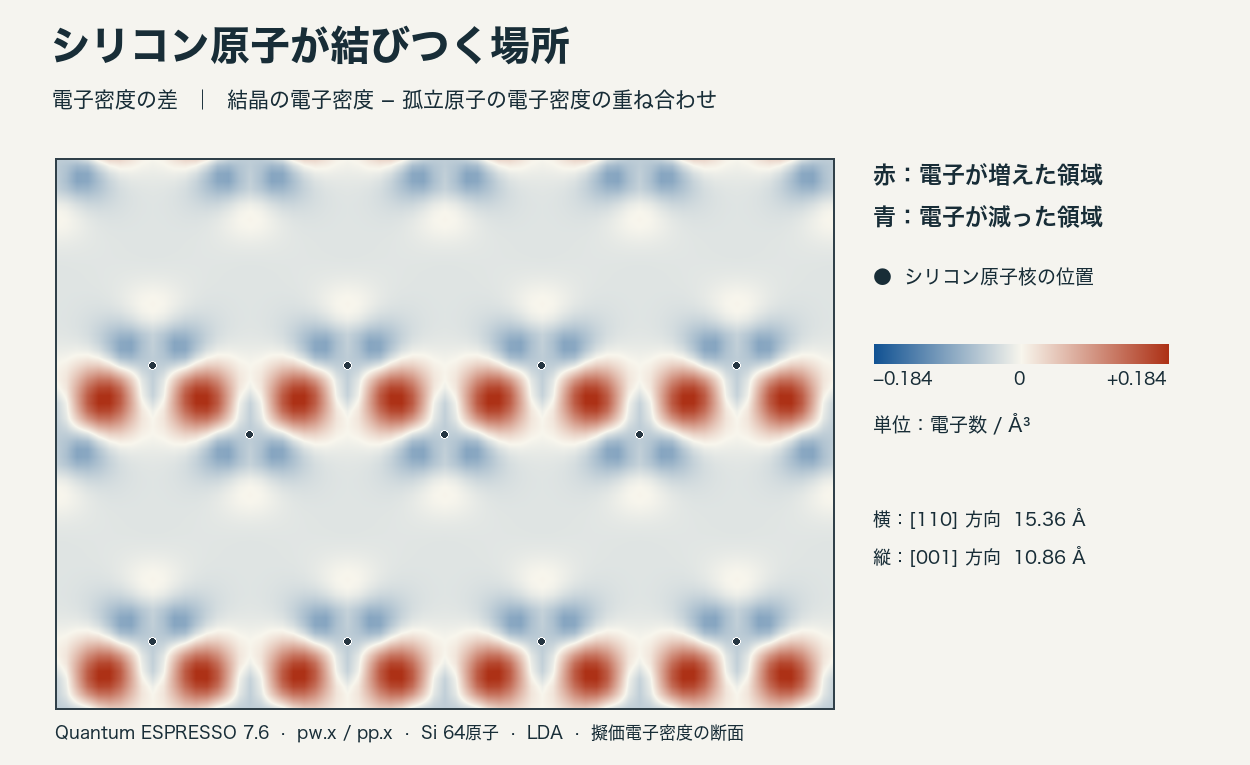
計算中は、電子がどう分布しているかをいったん仮定し、その分布がつくる電場の中で電子の波を解く。得られた波動関数から密度を作り直し、両者がつり合うまで繰り返す。性能試験では216原子の完全結晶を使い、最後に電子密度と、電子が占める状態の波動関数を保存した。
公開GPU版はどこまで速かったか
開発元の公開版をビルドし、CPUの並列数、GPUの仕事の分け方、電子状態を解く設定を調整した。例えばA100 1枚では、標準の探索空間を使った場合の49.52秒(2回の中央値)から、設定変更だけで42.69秒になった。下の公開版の列には、調整後に改めて測った値を使っている。
| 実行構成 | 開発元の公開版 | Astra改良版 | 同じ構成での高速化倍率 |
|---|---|---|---|
| CPU 32物理コア | 124.21 秒 | 独自改良なし | ― |
| CPU 64物理コア | 102.46 秒 | 独自改良なし | ― |
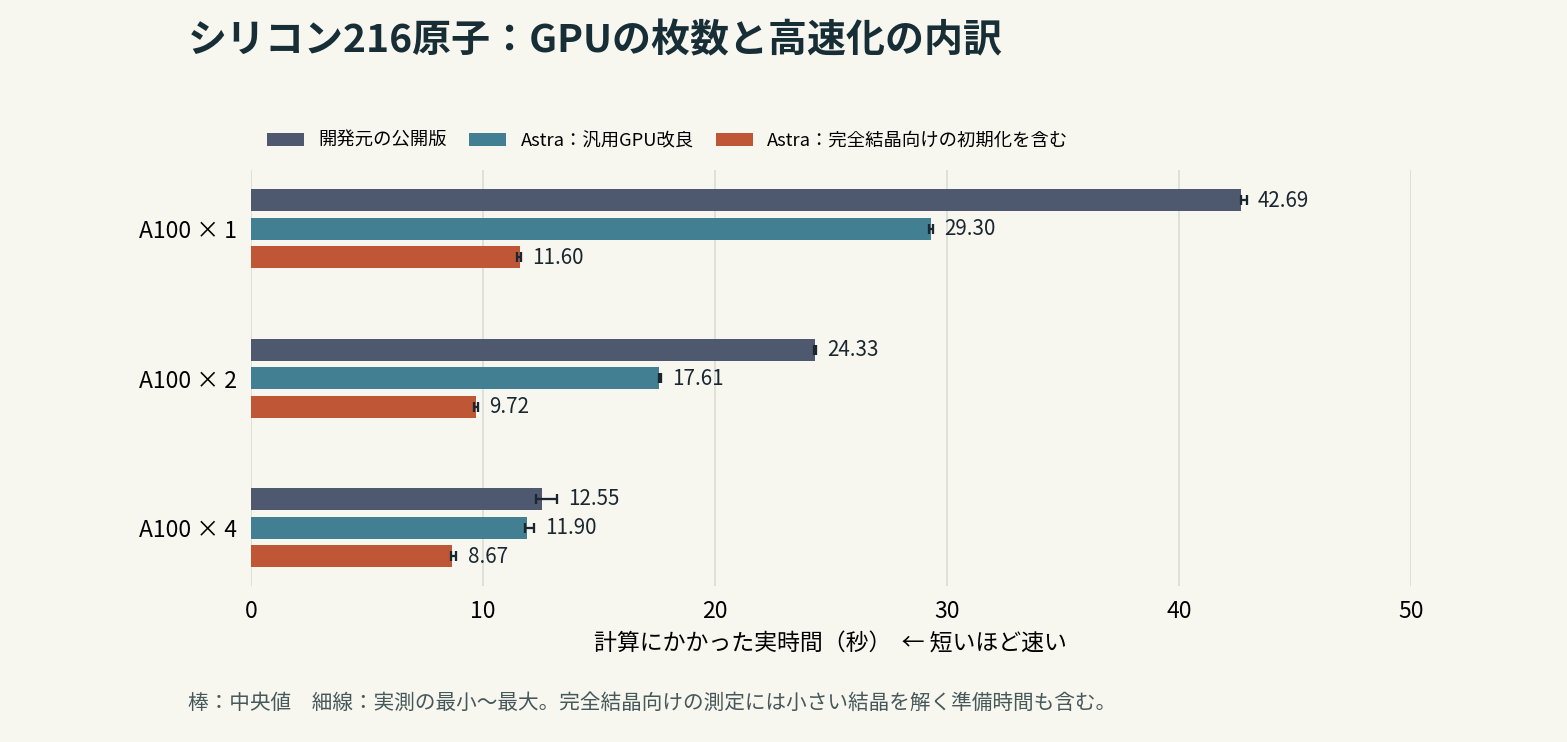
| A100 1枚 | 42.69 秒 | 11.60 秒 | 3.68倍 |
| A100 2枚 | 24.33 秒 | 9.72 秒 | 2.50倍 |
| A100 4枚 | 12.55 秒 | 8.67 秒 | 1.45倍 |
完全結晶・216原子。比較する8構成を各5回、計40回実行した。代表値は実時間の中央値。CPUの独自高速化は行っていない。
CPUは32コアより64コアが速く、基準は102.46秒。そこから公開GPU版に移ると、1枚で2.40倍、2枚で4.21倍、4枚で8.16倍になった。さらにAstraの改良を加えると、4枚は12.55秒から8.67秒へ。同じ4枚での上積みは1.45倍、公開CPU版から通して見るとCPU比11.82倍になる。
42.69秒から29.30秒へ。何度も使う波動関数をGPUに残す
まず1枚のA100で、CPUとGPUの間を何が行き来しているかをNsight Systemsで追った。電子状態を繰り返し解く間、同じ波動関数をまた使う。そこで、次に使う波動関数をGPUのメモリに残し、CPU側にコピーする処理をまとめた。フーリエ変換の後にデータを取り出す処理も整理した。
プロファイラを付けた別試行で、CPUとGPUの間の転送に使ったGPU時間を足すと、両方向合わせて2.43秒から0.52秒に減った。転送の回数自体は増えた。それでも、大きなデータの往復を減らすと、電子状態を解く反復部分は34.88秒から22.11秒に縮んだ。汎用的な改良を合わせた、起動から終了までの時間は29.30秒だった。
29.30秒から11.60秒へ。8原子の解を216原子に広げる
今回の結晶は、8原子を含む立方体を各方向に3個ずつ並べたものだ。27個の立方体のどれを見ても、シリコンが同じように並ぶ。この周期性を使えば、大きな結晶の計算を、答えに近いところから始められる。
まず8原子のセルで、電子の波の周期の違いを細かく取りながら電子状態を解く。その解を並進と回転の対称性で組み合わせ、216原子の波動関数の初期値を組み立てる。最後に大きなセルの方程式で残差を確かめ、収束した電子密度と波動関数を書き出す。小セルは毎回新しく解いた。準備と本体が使うGPUの合計を1枚に収め、両方の起動から最終出力までを測ると11.60秒。公開版の同じ1枚から3.68倍だった。
ここで「欲しい答えは何か」が効いてくる。理想的な結晶の原子1個あたりのエネルギーだけが欲しければ、公開版で8原子セルを解くだけでよく、1枚GPUの実測は3.12秒だった。今回11.60秒をかけて得たのは、216原子セルで次の計算にも使える波動関数まで含む結果だ。結晶の対称性を使う方法は以前からある。今回の工夫は、それを初期値の生成とGPU上の処理に組み込んだ点にある。
公開版の再開機能を使う対照試験もした。外部で初期密度と波動関数を準備し、公開版の実行ファイルに渡すだけでも、1枚で20.53秒だった(準備込み、1回)。11.60秒に至る改善の一部は、公開版に与える出発点を変えたことに由来する。
原子を1個抜くと、同じ4枚で1.03倍
最初に1原子を0.08 Åずらしてみた。この216原子を4枚で解くと、結晶の規則性を使わない汎用改良だけで43.38秒から30.25秒、1.43倍になった(各3回の中央値)。では、同じ場所から原子を丸ごと抜いたらどうか。残るのは215原子。原子が抜けてできた空席を「空孔」と呼ぶ。
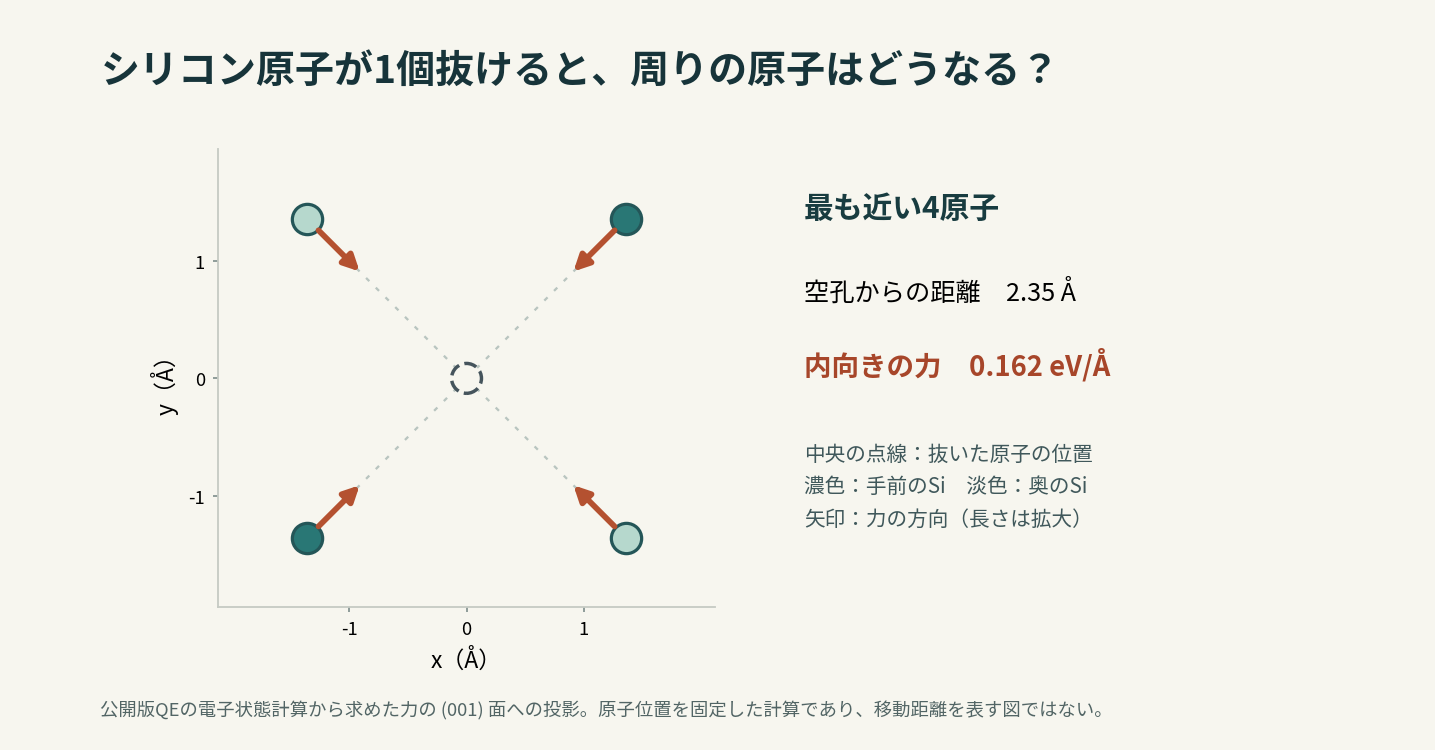
最も近い4原子について計算すると、空孔の中心へ向かう力の成分が、どれも0.162 eV/Åだった。下表は、原子の位置を固定したまま電子状態を収束させ、全原子に働く力も出力したときの実時間だ。
| 実行構成 | 開発元の公開版 | Astra改良版 | 同じ構成での高速化倍率 |
|---|---|---|---|
| A100 1枚 | 113.73 秒 | 76.33 秒 | 1.49倍 |
| A100 2枚 | 62.28 秒 | 43.59 秒 | 1.43倍 |
| A100 4枚 | 28.39 秒 | 27.59 秒 | 1.03倍 |
中性空孔・215原子。汎用改良を使用。1・2枚は各1回の参考値、4枚は各3回の中央値。公開CPU 64物理コアは233.07秒(1回)。ほぼ占有されない状態の固有値差が許容範囲を超えたため、空孔のCPU比は算出していない。空孔の32コアは未測定。
空孔でも1枚なら約37秒縮んだが、4枚で縮んだのは0.80秒。4枚の転送イベントの時間を足すと、公開版も汎用改良版も約5.25秒だった。複数GPUで同時に行う処理を積算した値なので、そのまま実時間から引くことはできない。この構成では、1枚の完全結晶で見られた大きな転送時間の減少が見られなかった。
もう一つ、完全結晶の電子密度から抜いた原子の分を引いて、空孔の初期値を作る方法も試した。反復は18回から16回に減ったものの、準備に約4秒かかり、全体では30.99秒(3回の中央値)。しかも、ほとんど電子が入っていない状態の固有値が許容差を超えた。この案を外し、4枚の結果には通常の初期値から解いた27.59秒を採用した。
4個の原子は、どこで止まるのか
空孔を囲む4個の矢印は、原子が次に動こうとする向きを教えてくれる。実際に原子を少し動かせば、電子の分布も、受ける力も変わる。移動と計算を繰り返して、力がつり合う配置を探すのが構造緩和だ。そのときは一つ前の配置で求めた電子状態を次の出発点にできる。次に知りたいのは、公開版でもこの再利用を有効にしたうえで、安定な配置に着くまで何秒を縮められるかだ。