B200 8GPUでDeepSeek V4.1 FlashとGLM-5.3を比較――科学的推論、20同時要求、長文入力
HGX B200 8GPUでDeepSeek V4.1 Flash 1017とGLM-5.3を比較。科学問題198問、独自回答例、1件対20件の待ち時間・生成速度、約78万トークン入力の補完試験と未完了例を記録。
2026年10月27日の測定・改訂。GLMの約78万入力・10件/20件同時の補完試験を反映し、1件対20件の待ち時間と生成速度の説明を追加した。動画は日本語原稿を見直し、OpenAI Marinの合成音声で作り直した。専門家による回答レビューは未完了である。
社内で科学的な検討にLLMを使うなら、正答率だけでなく、回答の根拠、待ち時間、最後まで答えられるかを一緒に見る必要がある。HGX B200 8GPUで、DeepSeek V4.1 Flashの公式1017更新版とGLM-5.3を同じ問題群で測定した。
今回のGPQAでは、両モデルが完了した問題に限る正答率は約92.9%だった。20同時要求では、短い科学質問の回答開始はGLMが早く、長文照合と独自の科学的推論の完了はDeepSeekが早かった。一方、GLMにはGPQAで出力上限に達した2問があった。長文容量試験は、当初の作業上の時間枠で打ち切った条件を補完し、約78万入力・20件同時の結果も取得した。以下ではそれぞれの分母と条件を示す。
動画で比較結果を見る
動画の字幕表示を修正しました。日本語字幕はプレーヤーの[CC/字幕]で切り替えられます。音声・検証結果・数値は変更していません。
YouTubeで見る(日本語ナレーション・字幕付き)。動画概要欄からもこの記事に戻れます。
比較条件
| 項目 | DeepSeek V4.1 Flash 1017 | GLM-5.3 |
|---|---|---|
| 重み | 公式1017更新版・FP4+FP8混在 | 公式FP8 |
| コンテキスト設定上限 | 1,048,576 | 1,048,576 |
| 生成上限(推論を含む) | 262,144 | 262,144 |
| 温度 / top_p | 1.0 / 0.95 | 1.0 / 0.95 |
| 科学問題・コード・GPQAの推論量 | 100 | max |
| 短文・長文・容量試験の推論量 | 25 | low |
| GPUメモリー割当上限 | 0.80 | 0.82 |
| KVキャッシュ | FP8、索引用はMXFP4 | FP8 E4M3 |
| 共通実行系 | vLLM 0.31.0、B200×8、TP=8 | 同左 |
| 同時要求 / バッチトークン上限 | 20 / 4,096 | 20 / 4,096 |
| prefix cache / 投機的デコード | 無効 / 無効 | 無効 / 無効 |
重みを追加量子化せず、モデルのリビジョンとコンテナを固定した。Flash配布元、GLM配布元。版・起動条件の詳細は再現条件ファイルに記録する。モデル別の推論量の名称は同じ計算量を意味せず、トークナイザー、attention実装、KV精度にも違いがある。
GLMはメモリー割当0.80では1,048,576コンテキストに必要なKV領域を確保できず、要求受付前に起動検査で停止した。0.82に調整して起動したため、この割当差も比較条件に含める。ホストのドライバーや既存環境は変更していない。
各問題は固定した順序と乱数種の規則で1回ずつ実行し、成功するまでやり直して最良の回答を選ぶ採点はしていない。先行する32K・8K生成枠および1M・64K生成枠の試験は別記録として保持し、この記事の1M・262,144生成枠の結果へ混ぜていない。
科学問題とコードの結果
| 評価 | DeepSeek V4.1 Flash 1017 | GLM-5.3 |
|---|---|---|
| GPQA:正答 / 誤答 / 未完了 | 184 / 14 / 0(198問) | 182 / 14 / 2(198問) |
| GPQA:完了回答中の正答率 | 184/198=92.93% | 182/196=92.86% |
| GPQA:全198問に対する正答回収率 | 92.93% | 91.92%(打ち切り2問は未採点) |
| 独自の科学的推論20問 | 20問完了。数値照合11/12合格、文章評価8問 | 20問完了。数値照合10/12合格、文章評価8問 |
| 科学計算コード10問 | 10/10課題合格、固定テスト61/61合格 | 9/10課題合格、固定テスト60/61合格 |
| 同時利用試験:3課題群×4並列度 | 240/240回答完了 | 240/240回答完了 |
GPQA Diamondは公開の物理・化学・生物の選択問題198問を使った公開ベンチマークのローカル評価である。提供元の公式スコアを再現したものではなく、学習時の問題既知性も除外できない。
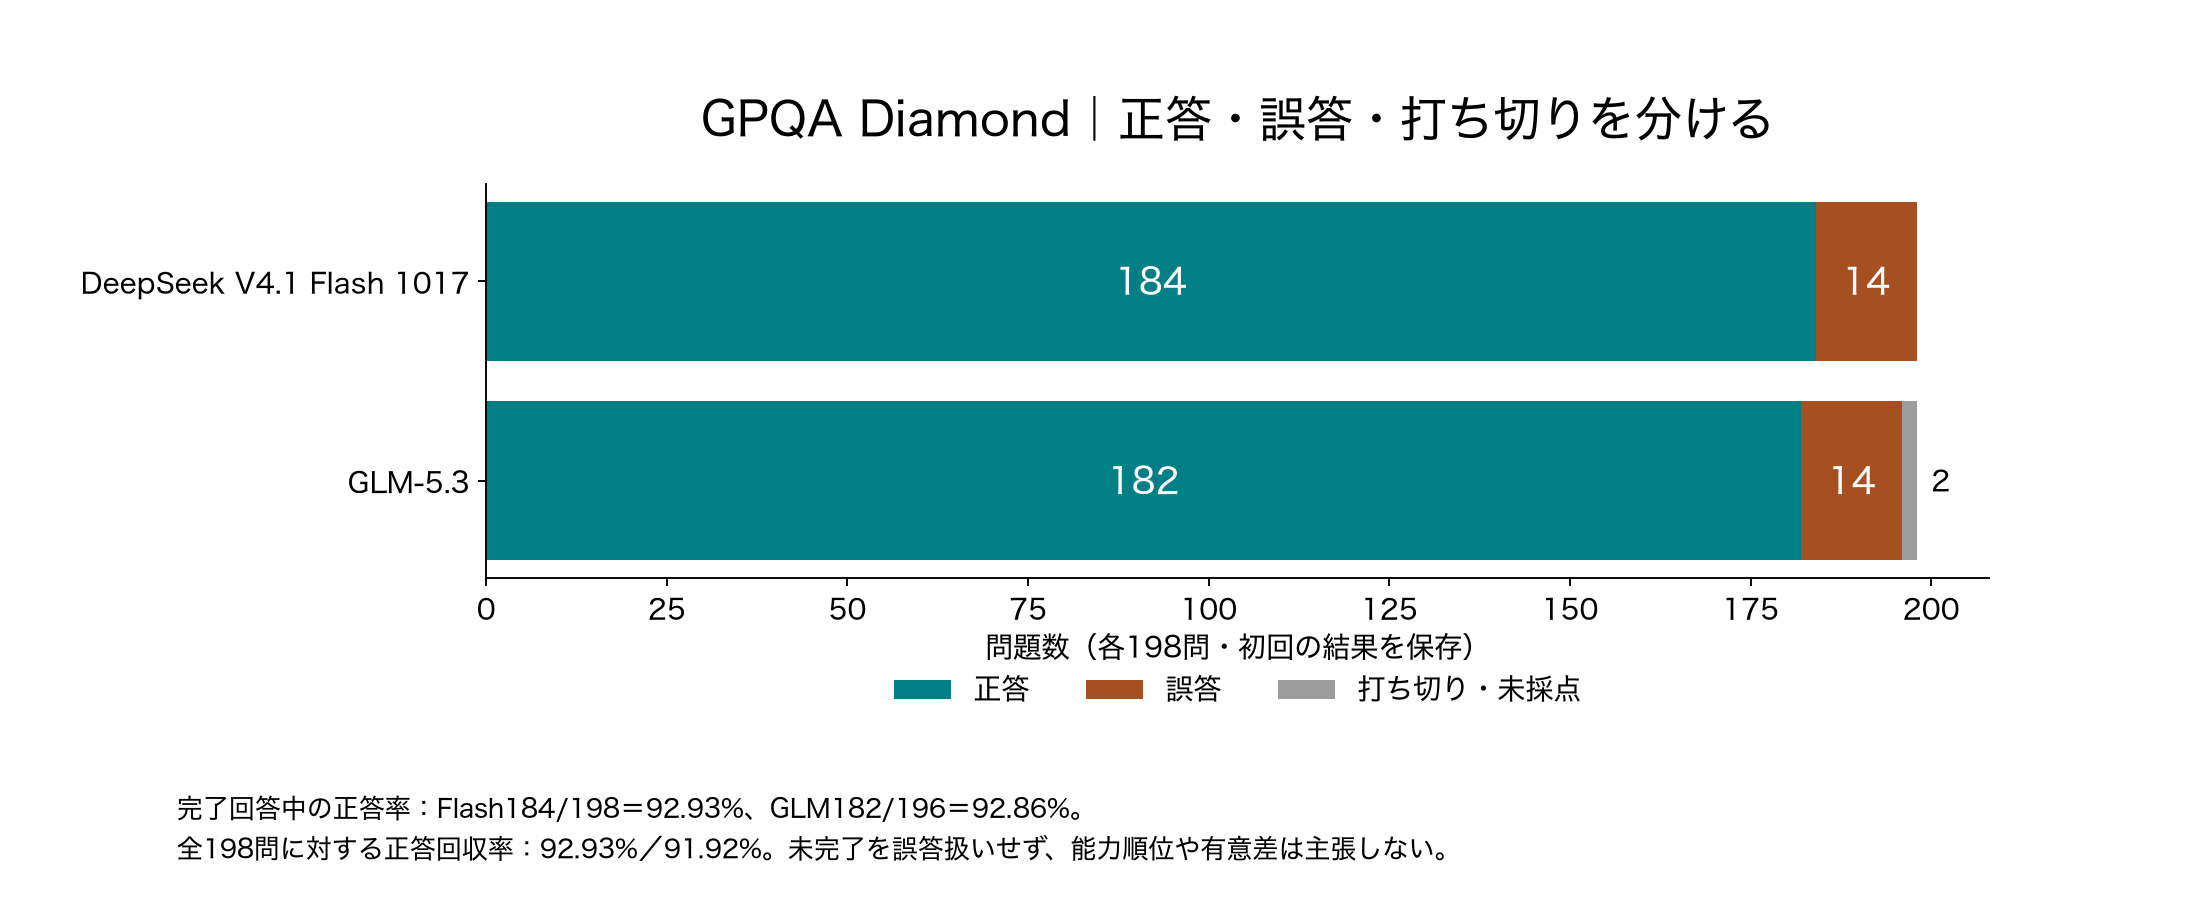
両方が完了した196問では、177問が両方正解、9問が両方不正解、DeepSeekだけ正解が5問、GLMだけ正解も5問だった。残る2問はDeepSeekが正解し、GLMは未完了だった。この一回の測定から、制約のない科学的能力の順位や統計的な優位は主張しない。
GPQAの完了時間は、完了した回答だけの中央値でDeepSeek 58.4秒、GLM 123.4秒、p95は359.5秒と954.2秒だった。全198問の計測区間は約18分34秒と約76分34秒。GLMの完了時間統計からは未完了2件を除いているため、その2件を隠さず上表に併記する。独自の短い科学問題の応答時間とは別に扱う。
答えの中身を比べる
独自の科学的推論は、ベイズ推定、熱収支、誤差伝播、数値解析、因果関係、実験設計、情報不足、データリークなど20問で構成した。数値の答えを自動照合する12問と、論述を読む8問を分ける。コード群は独自の小さな科学計算関数10問であり、公式SciCodeのスコアではない。
| 確認したいこと | DeepSeekの回答と点検 | GLMの回答と点検 |
|---|---|---|
| 密度と不確かさ | 密度8.00、標準不確かさ約0.0358を説明。数値欄0.036は固定許容0.2%を外れた | 同じ式と約0.0358を説明。数値欄0.036も同じ理由で不合格 |
| 相関する測定値の差 | 不確かさ√0.4を約0.632455532として数値照合に合格 | 式と約0.6325の説明は整合するが、数値欄0.63への丸めで固定許容を外れた |
| 材料差と温度差の交絡 | 因果効果を確定できないとし、同一温度比較・要因実験を提案 | 同じく確定不能とし、追加実験・無作為化・ばらつきの確認を提案 |
| 温度差だけで反応熱を計算できるか | 質量・比熱・容器熱容量などの不足を指摘 | 不足情報を指摘し、熱収支とモル量が必要な場合を説明 |
| 指数減衰から到達時刻を逆算 | 主計算の20秒は正しいが、別解の「5秒で8から2」は10秒の誤記 | 20秒を求め、8から2が10秒であることを検算に記載 |
| 積abだけが観測できるモデル | 個々のaとbは一意に決まらないと回答。ただし追加条件a+bが常に一意解を与えるかは要確認 | 同じ結論。追加条件a+bやa=bの例にも、符号や解の一意性の確認が必要 |
| 科学計算コードの境界値 | 分類指標の課題を含む10課題・61テストを通過 | 分類指標の課題で1テスト不合格。他9課題は通過 |
数値照合の不合格をすべて「科学的な計算を間違えた」と扱うと、丸めの差を誤読する。上の不確かさ2例では式を確認できるが、固定済みの自動採点は変更せず、説明上の評価を分けて示す。
コードの不合格は、TP=0、FP=0、FN=3、TN=2のケースだった。固定した採点仕様はF1=2TP/(2TP+FP+FN)=0を期待したが、GLMはprecisionが未定義であることからF1もnullにした。通常入力で動いても、境界条件の扱いに差が出る例である。これは「コードが全く動かない」という失敗ではない。
パラメータ同定の例は、ab=6にa+b=5を加えても(2,3)と(3,2)が残ることを代入で確認できる。両モデルとも結論部分が正しくても、付け加えた説明まで確認する必要がある。ここでの内容点検はCodexによる補助レビューであり、独立した専門家の採点ではない。専門家の点数は未記入のまま保持する。
密度・交絡・情報不足・長文照合・拡散コードは事前に選んだ提示候補。指数減衰、相関する不確かさ、同定、分類指標は結果を確認してから差や注意点を説明するために追加した。これらの例だけからモデル全体の優劣は決めない。
両モデルの独自20問の問題文と最終回答は、左右比較の回答資料で確認できる。内部の長い推論文やGPQAの問題全文はこの資料に転載しない。
20人が使うと、どのくらい待つか
同時要求1・5・10・20で、短文、約1.7万トークンの合成資料の照合、独自の科学的推論を比較した。各条件は同じ20問を1回ずつ使う。初期に最大C件を送り、完了した枠に次の要求を入れる方式であり、20人同時利用は毎秒20件の到着を意味しない。多ターン会話履歴は含めていない。
「開始」は推論表示の開始ではなく、最終回答の最初の出力を受け取るまでの時間である。要求送信直前から測り、サーバーの待ち行列を含む。同じホストのループバック接続を使うため、利用者側のネットワークと業務アプリの遅延は含まない。
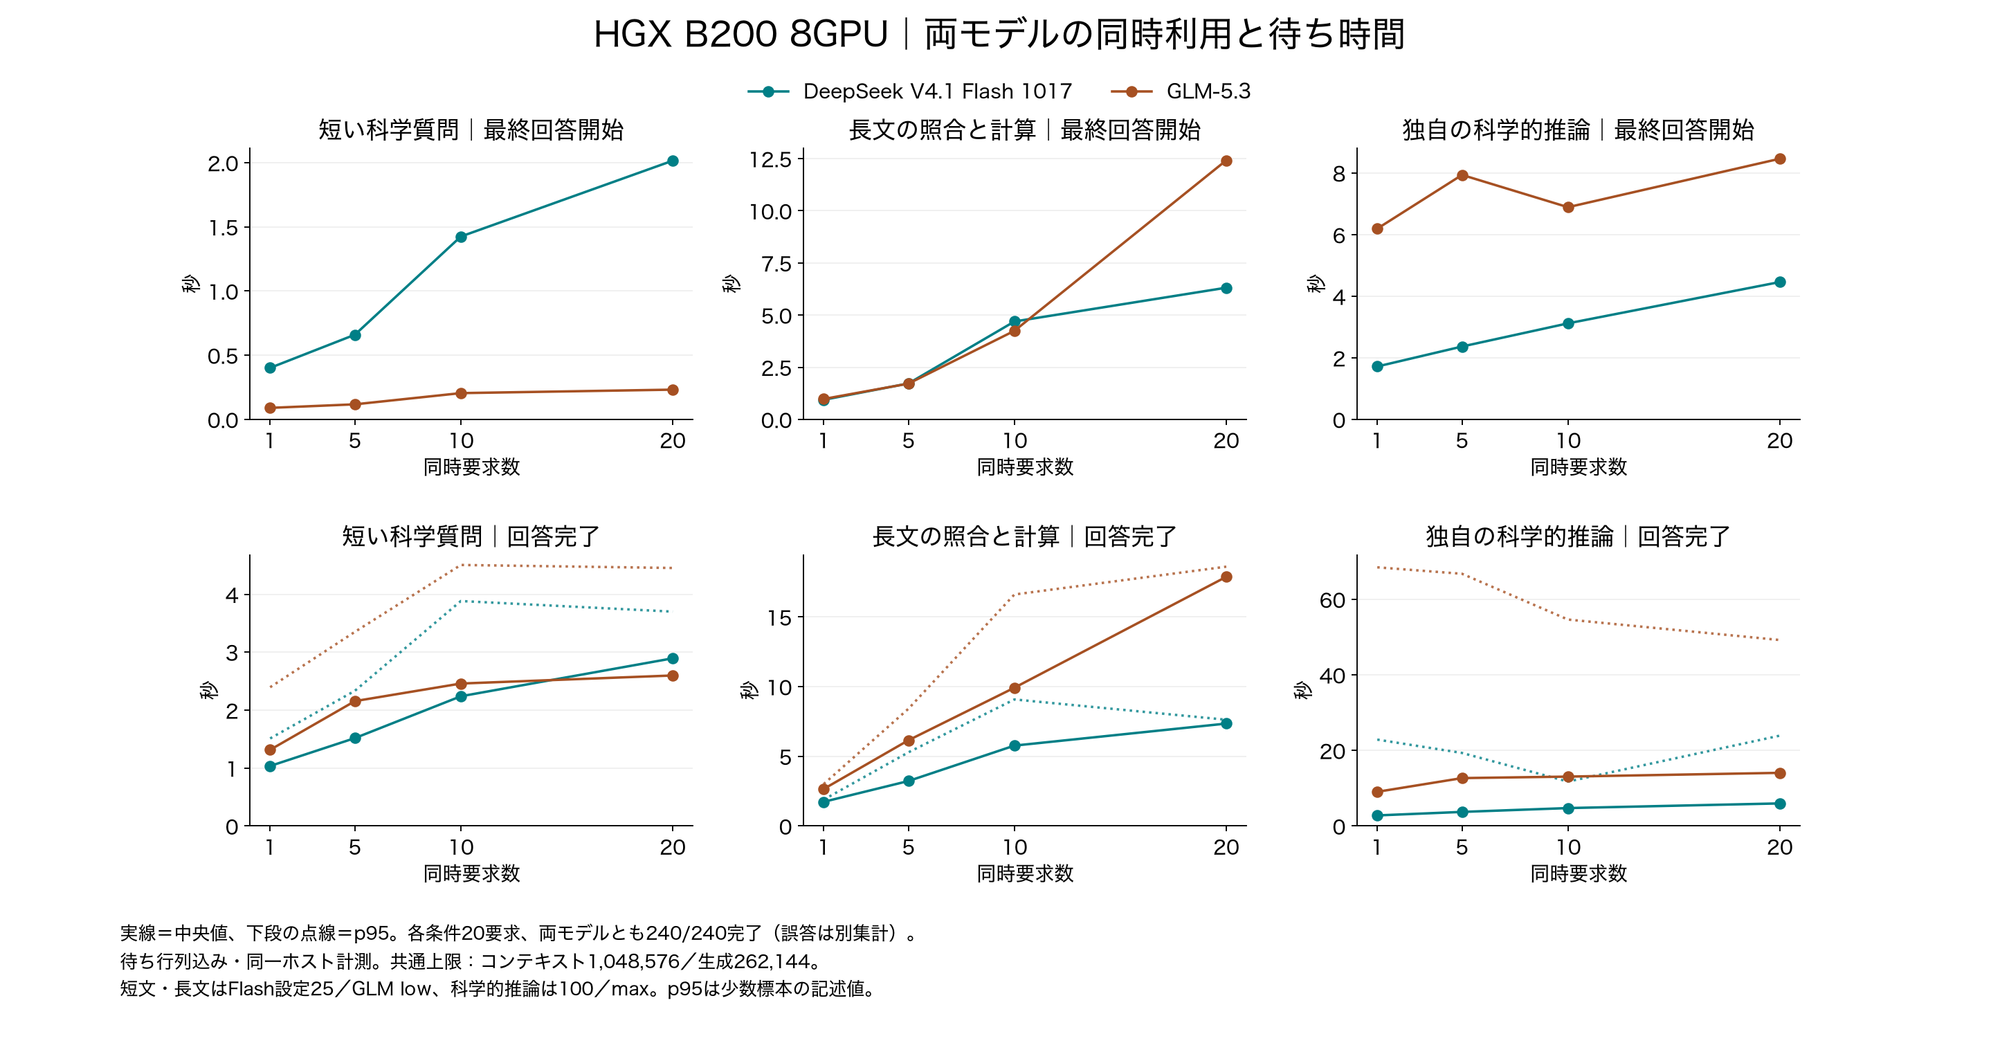
以下は秒。開始・完了は中央値、p95は20件の記述値である。両モデルとも全12条件で20/20件が回答完了し、通信失敗・時間切れ・出力打ち切りは0件だった。これは全件正答という意味ではない。
| 課題 | 同時要求 | Flash開始 | GLM開始 | Flash完了 | GLM完了 | Flash完了p95 | GLM完了p95 |
|---|---|---|---|---|---|---|---|
| 短い科学質問 | 1 | 0.40 | 0.09 | 1.04 | 1.31 | 1.51 | 2.40 |
| 短い科学質問 | 5 | 0.66 | 0.12 | 1.52 | 2.16 | 2.33 | 3.35 |
| 短い科学質問 | 10 | 1.42 | 0.20 | 2.24 | 2.46 | 3.88 | 4.51 |
| 短い科学質問 | 20 | 2.01 | 0.23 | 2.89 | 2.60 | 3.70 | 4.45 |
| 長文の照合・計算 | 1 | 0.94 | 0.98 | 1.73 | 2.66 | 1.89 | 3.01 |
| 長文の照合・計算 | 5 | 1.72 | 1.71 | 3.23 | 6.15 | 5.28 | 8.41 |
| 長文の照合・計算 | 10 | 4.69 | 4.24 | 5.77 | 9.92 | 9.08 | 16.61 |
| 長文の照合・計算 | 20 | 6.31 | 12.42 | 7.35 | 17.88 | 7.62 | 18.61 |
| 独自の科学的推論 | 1 | 1.72 | 6.20 | 2.79 | 9.04 | 22.86 | 68.46 |
| 独自の科学的推論 | 5 | 2.37 | 7.94 | 3.72 | 12.67 | 19.33 | 66.75 |
| 独自の科学的推論 | 10 | 3.12 | 6.89 | 4.74 | 13.06 | 11.75 | 54.63 |
| 独自の科学的推論 | 20 | 4.46 | 8.47 | 5.97 | 14.06 | 23.91 | 49.21 |
20同時の短い科学質問では、開始中央値はGLM 0.23秒、DeepSeek 2.01秒。完了中央値もGLM 2.60秒、DeepSeek 2.89秒だった。一方、長文照合の完了中央値はDeepSeek 7.35秒、GLM 17.88秒、独自の科学的推論では5.97秒と14.06秒だった。短文の開始の早さを全課題の優位に広げず、用途ごとに見る。
1件から20件になると、待ち時間は何秒増えるか
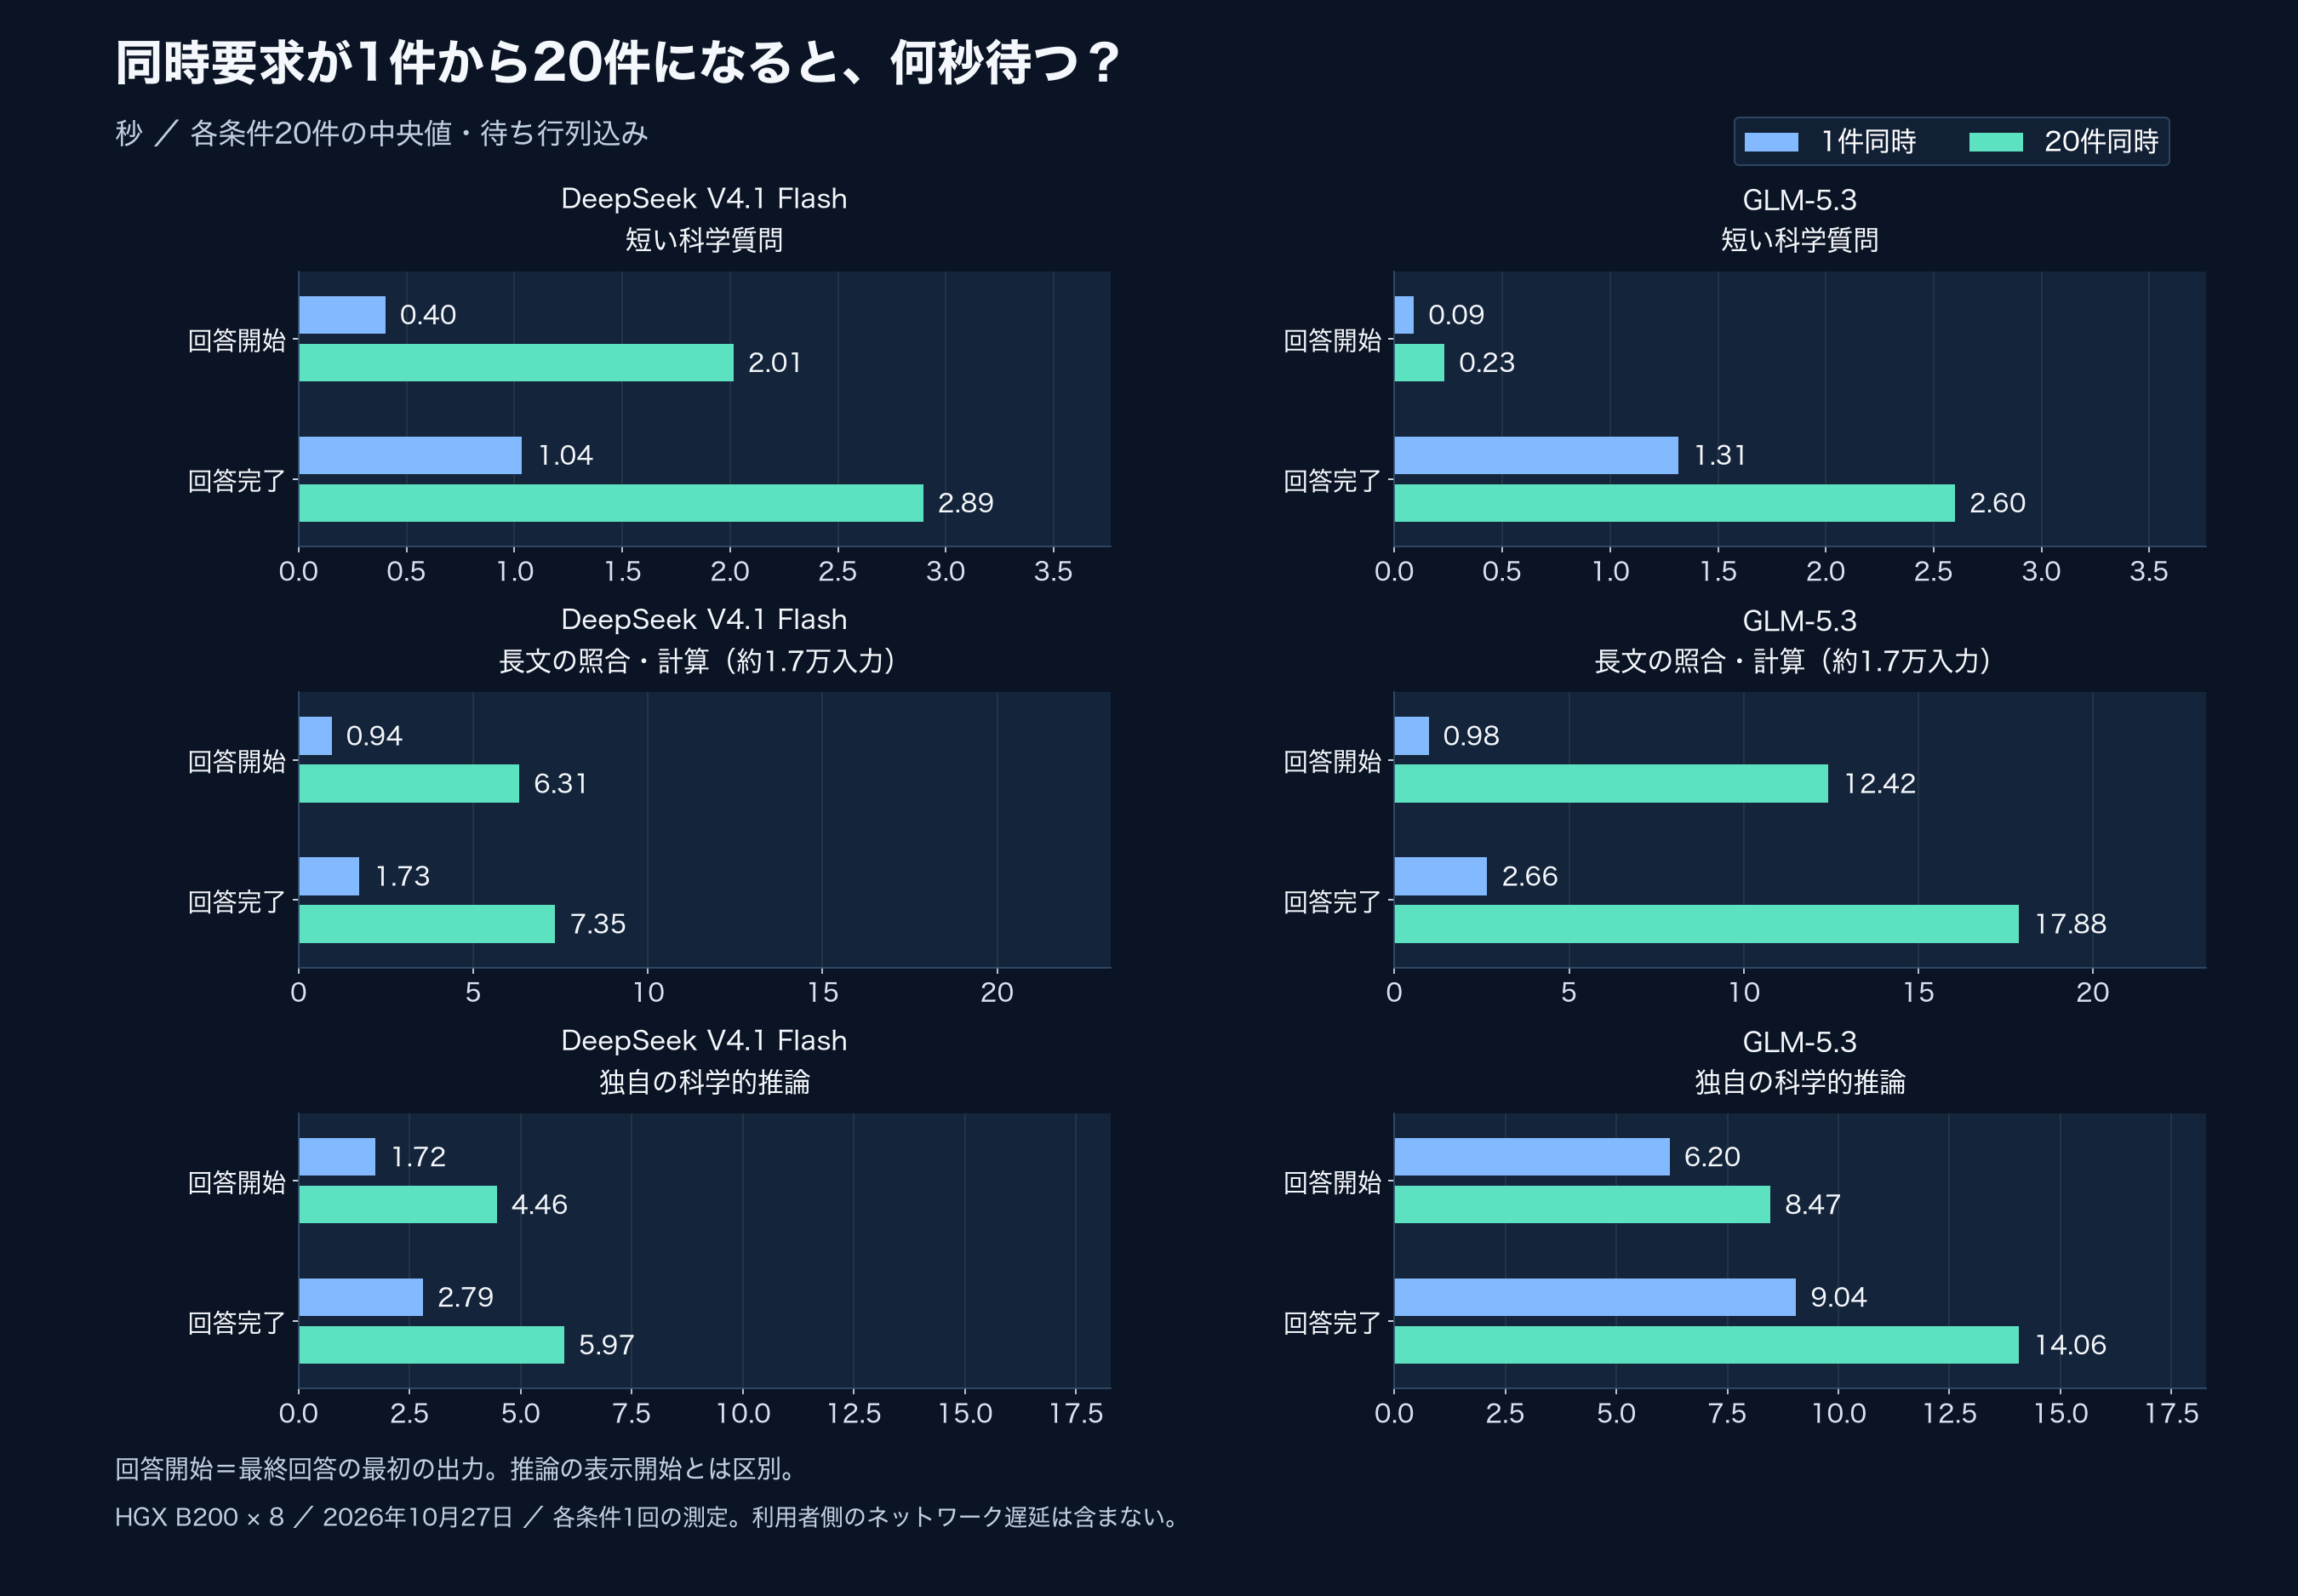
「20人でも使える」だけでは、1人の待ち時間が伝わらない。以下は、同じ問題群で同時要求が1件から20件に増えたときの変化である。秒数は各条件20件の中央値。差と倍率は丸める前の中央値から計算したもので、個々の問題の差を取った中央値ではない。
| 課題 | モデル | 回答開始:1件 → 20件 秒 | 開始の増加 秒 | 回答完了:1件 → 20件 秒 | 完了の増加 秒 | 完了時間の倍率 |
|---|---|---|---|---|---|---|
| 短い科学質問 | DeepSeek V4.1 Flash | 0.40 → 2.01 | +1.61 | 1.04 → 2.89 | +1.86 | 2.80倍 |
| 短い科学質問 | GLM-5.3 | 0.09 → 0.23 | +0.14 | 1.31 → 2.60 | +1.28 | 1.98倍 |
| 長文の照合・計算(約1.7万入力) | DeepSeek V4.1 Flash | 0.94 → 6.31 | +5.37 | 1.73 → 7.35 | +5.61 | 4.24倍 |
| 長文の照合・計算(約1.7万入力) | GLM-5.3 | 0.98 → 12.42 | +11.44 | 2.66 → 17.88 | +15.22 | 6.73倍 |
| 独自の科学的推論 | DeepSeek V4.1 Flash | 1.72 → 4.46 | +2.74 | 2.79 → 5.97 | +3.18 | 2.14倍 |
| 独自の科学的推論 | GLM-5.3 | 6.20 → 8.47 | +2.27 | 9.04 → 14.06 | +5.02 | 1.55倍 |
短文では完了までの中央値は両モデルとも3秒以内だったが、約1.7万トークンの長文ではDeepSeekで約5.61秒、GLMで約15.22秒待ち時間が増えた。「20倍待つ」といった単純な関係ではなく、入力の長さや要求の内容で違いがある。回答開始には順番待ち・入力処理・回答前の推論が含まれ、この測定だけでは、それぞれを個別に分離できない。
1人あたりの生成速度と、サーバー全体の処理量
1件あたりの生成速度の概算も、同時要求を増やすと低下した。以下は、各要求について「推論を含む生成トークン数から1を引いた値 ÷ 最初の生成出力から完了までの秒数」を求め、その中央値を取った値。処理中の休止やスケジューリングを含み、トークン単位の厳密なTPOT、GPUカーネルの速度、最終回答が画面に表示される速さとは異なる。
| 課題 | モデル | 1件あたり概算 tokens/s:1件同時 | 20件同時 | 低下率 |
|---|---|---|---|---|
| 短い科学質問 | DeepSeek V4.1 Flash | 237.8 | 155.1 | 34.8% |
| 短い科学質問 | GLM-5.3 | 122.0 | 71.8 | 41.2% |
| 長文の照合・計算(約1.7万入力) | DeepSeek V4.1 Flash | 233.3 | 68.7 | 70.6% |
| 長文の照合・計算(約1.7万入力) | GLM-5.3 | 113.5 | 22.5 | 80.2% |
| 独自の科学的推論 | DeepSeek V4.1 Flash | 236.5 | 153.1 | 35.3% |
| 独自の科学的推論 | GLM-5.3 | 119.2 | 69.6 | 41.6% |
短文でのサーバー全体の生成量は、DeepSeek V4.1 Flashで毎秒224.0から1287.4トークンへ、約5.75倍に増えた。
短文でのサーバー全体の生成量は、GLM-5.3で毎秒115.3から845.1トークンへ、約7.33倍に増えた。
この全体値は、全20件の生成トークン数を条件全体の所要時間で割ったもの。1人あたりの速度の20倍として計算したものではない。1人が待つ時間が長くなっても、全体では多くの要求を処理できる場合がある。生成長は試行ごとに変わり、モデルごとにトークンの区切り方も異なるため、モデル間のtokens/sを同じ文字量の速度とみなさない。各条件1回・20件の記述値であり、本番のSLAや混雑時の保証ではない。
自動照合の結果も併記する。科学的推論は数値12問だけの分母であり、残る論述8問の専門家評価は含まない。同じ20問でも並列度ごとの生成は別の試行で、実行順による数値・生成差があり得るため、合格数の変化を並列度の因果効果と断定しない。
| 課題 | 同時要求 | Flash自動照合合格 | GLM自動照合合格 |
|---|---|---|---|
| 短い科学質問 | 1 | 20/20 | 18/20 |
| 短い科学質問 | 5 | 20/20 | 18/20 |
| 短い科学質問 | 10 | 20/20 | 18/20 |
| 短い科学質問 | 20 | 20/20 | 18/20 |
| 長文の照合・計算 | 1 | 20/20 | 19/20 |
| 長文の照合・計算 | 5 | 20/20 | 19/20 |
| 長文の照合・計算 | 10 | 20/20 | 20/20 |
| 長文の照合・計算 | 20 | 20/20 | 19/20 |
| 独自の科学的推論 | 1 | 12/12 | 11/12 |
| 独自の科学的推論 | 5 | 12/12 | 12/12 |
| 独自の科学的推論 | 10 | 12/12 | 12/12 |
| 独自の科学的推論 | 20 | 12/12 | 11/12 |
長文入力の確認範囲
設定上限1,048,576は入力と生成の合計枠であり、100万トークンを実入力した成功を意味しない。262,144の生成枠を残し、約13万・26万・52万・78万トークンの入力を順に試した。各モデルのトークナイザーで実入力を計測しており、トークン数は同一ではない。
課題は、離れた場所に置いた測定値・ブランク・希釈倍率を合成資料から見つけ、数値と三つの引用IDを返すもの。長い実在論文の全体を科学的に理解できるかとは別の、検索と計算の試験である。
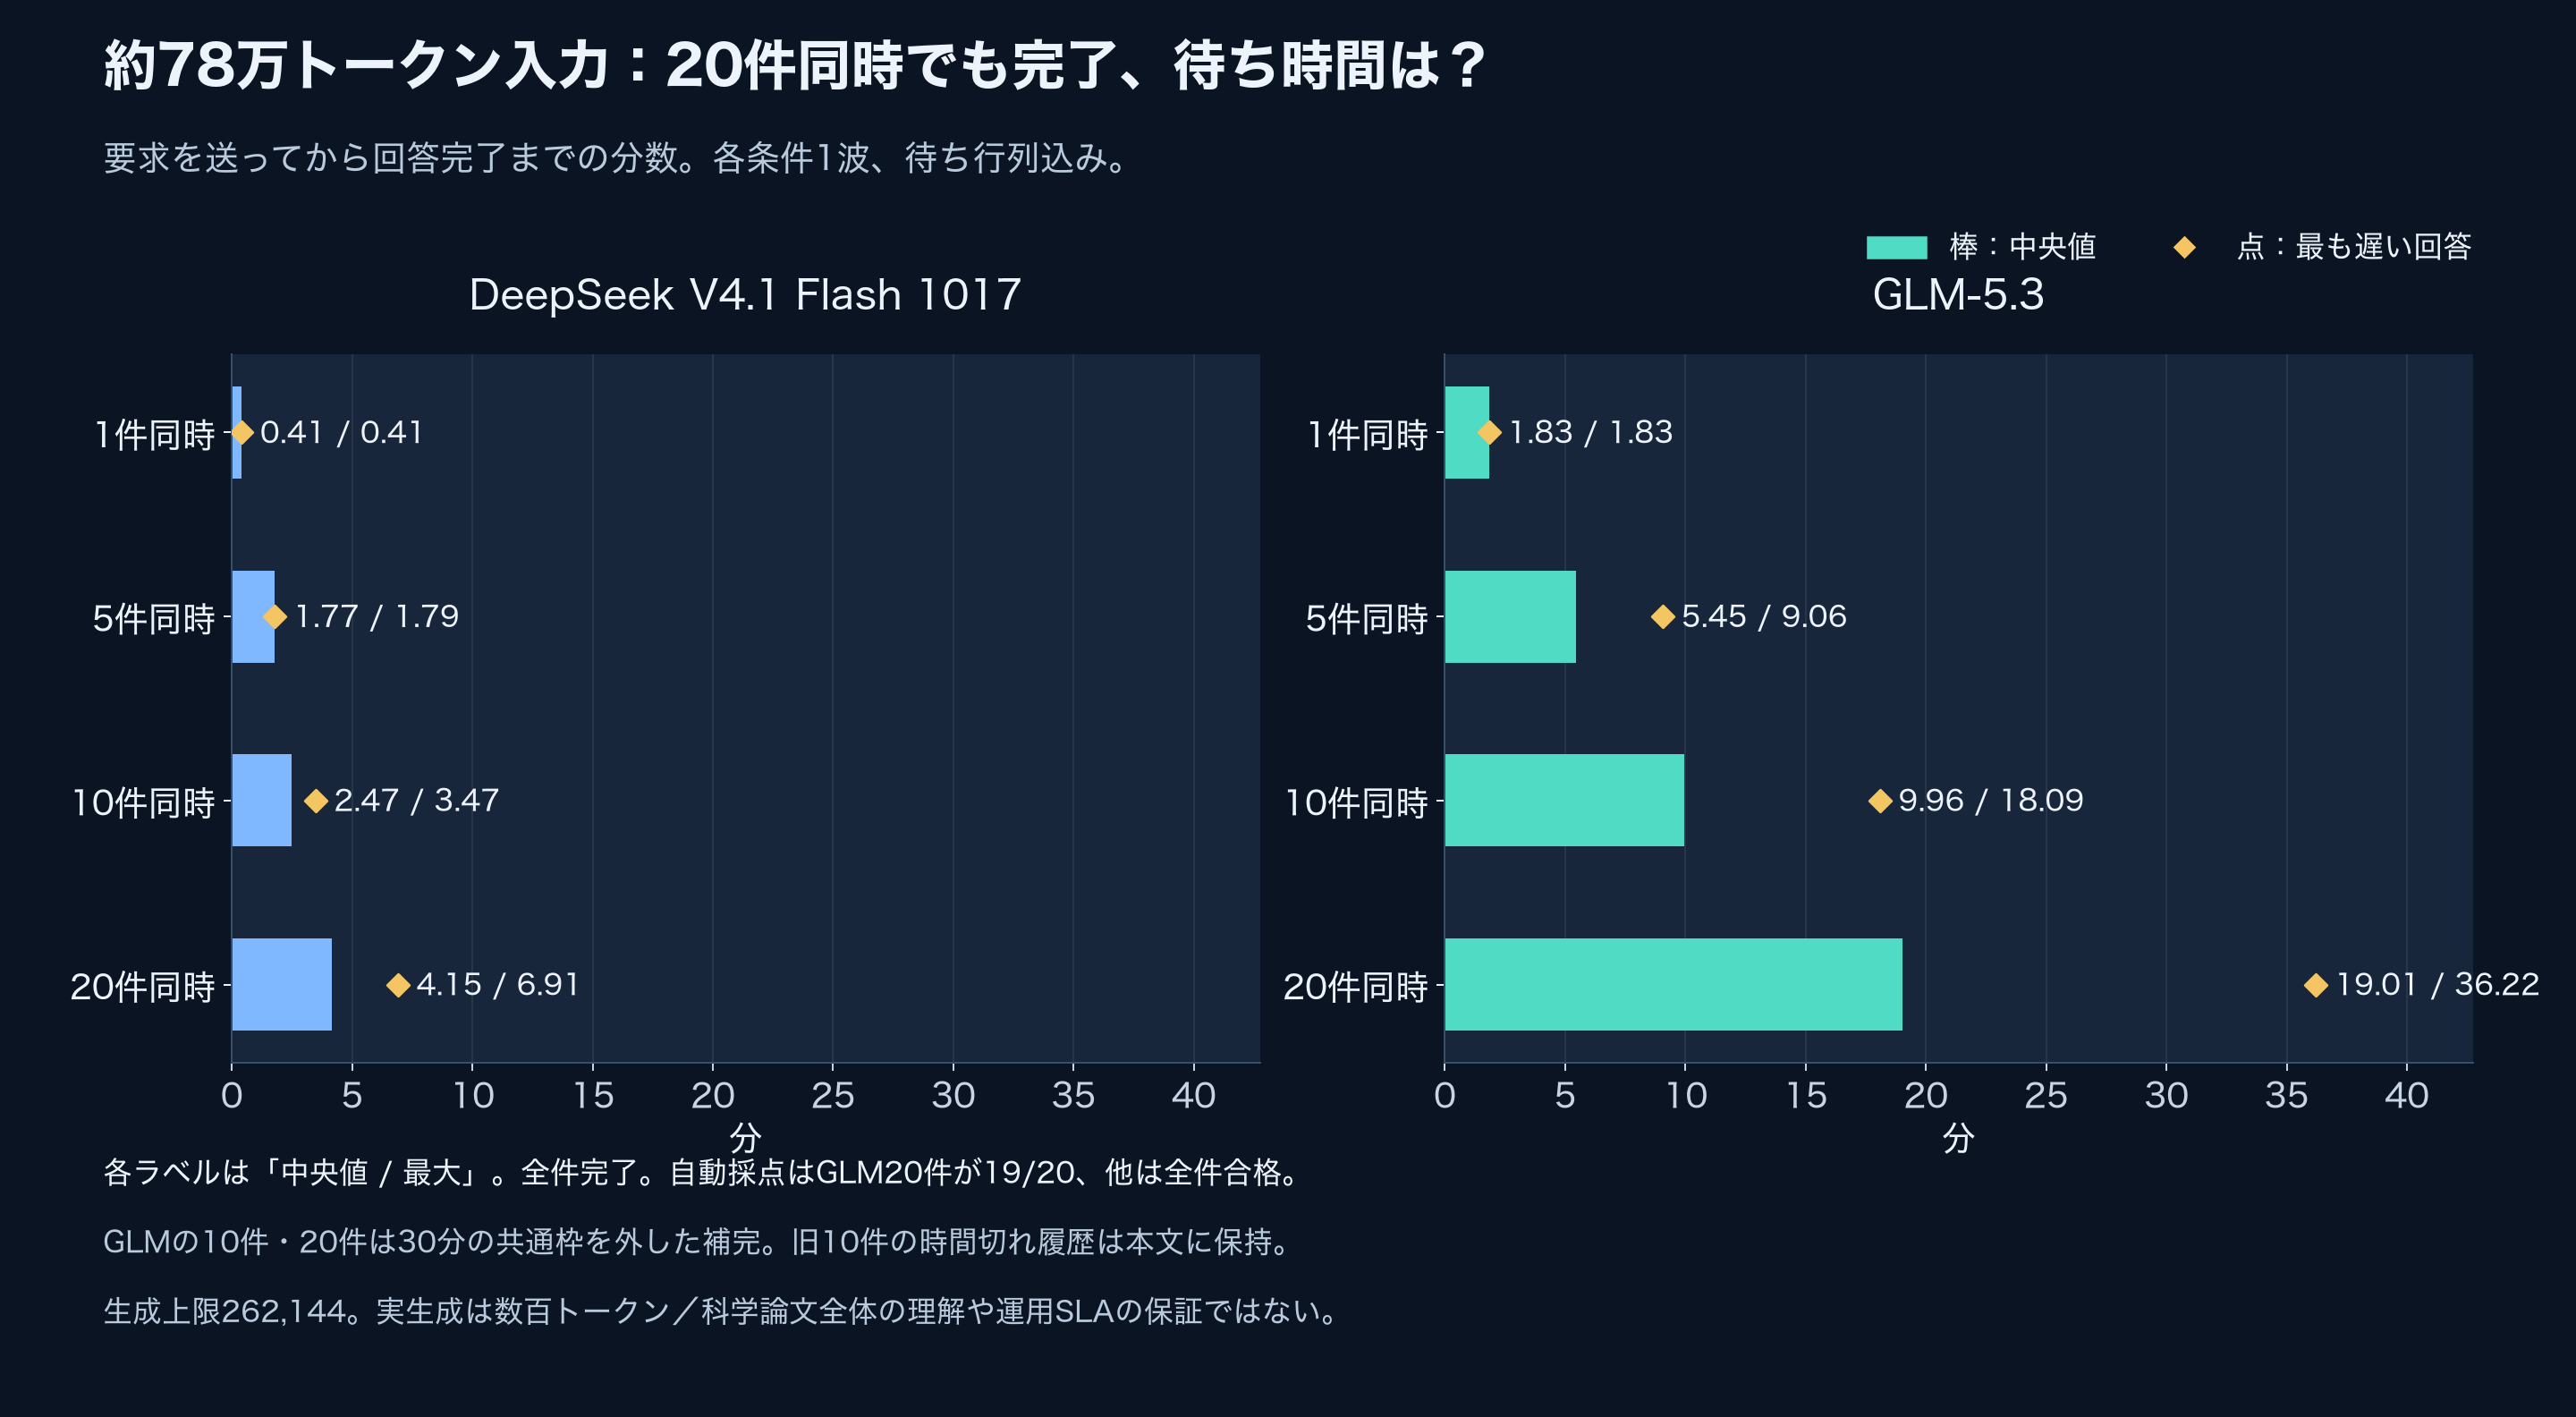
| モデル | 実入力トークン | 同時要求 | 完了 | 数値・引用合格 | 完了中央値 秒 | 完了最大 秒 | 実生成トークン |
|---|---|---|---|---|---|---|---|
| Flash | 130,731 | 1 | 1/1 | 1/1 | 3.96 | 3.96 | 363–363 |
| GLM | 130,513 | 1 | 1/1 | 1/1 | 8.56 | 8.56 | 177–177 |
| Flash | 130,731 | 5 | 5/5 | 5/5 | 12.70 | 12.95 | 303–364 |
| GLM | 130,513 | 5 | 5/5 | 5/5 | 35.66 | 36.79 | 160–232 |
| Flash | 130,731 | 10 | 10/10 | 10/10 | 24.63 | 25.35 | 264–391 |
| GLM | 130,513 | 10 | 10/10 | 10/10 | 69.76 | 71.83 | 167–307 |
| Flash | 130,731 | 20 | 20/20 | 20/20 | 44.66 | 46.41 | 265–397 |
| GLM | 130,513 | 20 | 20/20 | 19/20 | 118.45 | 140.31 | 166–267 |
| Flash | 261,558 | 1 | 1/1 | 1/1 | 6.52 | 6.52 | 304–304 |
| GLM | 261,503 | 1 | 1/1 | 1/1 | 18.59 | 18.59 | 160–160 |
| Flash | 523,717 | 1 | 1/1 | 1/1 | 13.80 | 13.80 | 339–339 |
| GLM | 523,851 | 1 | 1/1 | 1/1 | 51.19 | 51.19 | 288–288 |
| Flash | 785,876 | 1 | 1/1 | 1/1 | 24.48 | 24.48 | 268–268 |
| GLM | 785,941 | 1 | 1/1 | 1/1 | 109.86 | 109.86 | 186–186 |
| Flash | 785,876 | 5 | 5/5 | 5/5 | 105.94 | 107.24 | 311–426 |
| GLM | 785,941 | 5 | 5/5 | 5/5 | 326.86 | 543.44 | 154–211 |
| Flash | 785,876 | 10 | 10/10 | 10/10 | 148.23 | 208.45 | 274–394 |
| GLM(補完) | 785,941 | 10 | 10/10 | 10/10 | 597.38 | 1085.30 | 160–294 |
| Flash | 785,876 | 20 | 20/20 | 20/20 | 249.03 | 414.30 | 280–421 |
| GLM(補完) | 785,941 | 20 | 20/20 | 19/20 | 1140.61 | 2173.38 | 161–645 |
GLMの約78万入力・10件および20件同時の行は、時間枠を見直した補完試験の結果である。10件同時は10/10件、20件同時は20/20件が完了した。指定形式・数値・引用IDを含む自動採点は、それぞれ10/10件、19/20件が合格した。20件同時では、回答完了までの中央値は1140.61秒(約19.0分)、最大は2173.38秒(約36.2分)だった。最終回答の開始までの中央値は1138.58秒で、順番待ちと入力処理、回答前の推論を含む。20件は同時に送った要求数であり、20件分の文脈がGPUメモリーに同時に載ったことを示すものではない。
GLMの不合格1件は、最初のJSONで388 mg/Lと回答した後、説明文と二つ目のJSONで380 mg/Lへ訂正した。訂正後の値は正解だが、指定した単一JSONの形式から外れたため、固定した採点処理では不合格となった。回答の完了、形式への適合、内容の正しさを分けて読み、後から訂正部分だけを取り出して合格へ変更することはしない。
DeepSeekは実入力785,876で20/20件が完了・数値と引用に合格し、完了中央値249.03秒、最大414.30秒だった。実生成は280〜421トークンで、GLMの補完20件は161〜645トークン。設定した生成上限262,144を全量、20件同時に出力した試験ではない。約13万入力のGLMは20件すべて完了したが、自動照合の合格は19件であり、この結果も保持する。
最初の試験を打ち切った理由と、補完した条件
最初は容量を探索する作業全体に30分の枠を設けた。しかし、この作業上の枠には、利用者が許容する応答時間やモデルの限界としての根拠はなかった。GLMの約78万入力・10件同時を始めた時点では約738秒しか残っておらず、6件が完了したところで4件を打ち切った。20件同時は開始していなかった。この履歴を、モデルが処理できなかった証拠として扱うのは適切ではない。
そこで共通の30分枠を外し、補完の各要求には本来の90分(5,400秒)の上限を確保した。重みの版・精度、実行環境、保存済みの入力、採点基準、推論量、コンテキストと生成上限は維持し、10件同時、20件同時の順に別試験として実施した。90分は無制限の停止待ちを避ける運用上の上限であり、サービスの合格基準ではない。今回の全要求はその上限に達する前に完了した。旧試験の6/10件完了・4件時間切れと20件未実施の記録は、当初の集計に残し、補完結果と分けて公開する。GPQAの未完了2問や同時利用試験の点数は差し替えていない。
各容量条件は1波だけの探索的測定である。成功した最長値は今回の確認範囲であり、ハードウェアの絶対限界でも運用SLAでもない。待ち行列込みで完了したことは、20件が同時にKV領域へ常駐した証明でもない。
長い推論が終わらなかった問題
GLMの最初のGPQA評価では、2問が生成上限262,144トークンに達し、最終回答を出せなかった。保存ストリームとの照合では、一方に同じ段落が774回、もう一方に約4,200文字の同じ段落が155回あった。単に長く考えた成功例とは区別し、未完了として残した。
その2問と正常終了した対照2問を、3種類の乱数種・推論設定max/highで比較した追加24回答は、すべて完了した。maxは11/12正答、highは12/12正答で、200文字以上の同一段落が10回以上現れる検知基準には両設定とも該当しなかった。生成を検知器で途中停止した結果ではない。
ただし元のmaxでも反復が再現しなかったため、highへの変更が問題を解消したとは判定できない。highでも最大206,892トークン・約36.5分を要した回答があり、設定を下げれば常に短くなるわけではない。同じ乱数種でも要求の組み合わせやバッチ実行順まで同一とは限らず、意味的な堂々巡りがないことも保証しない。原因は未確定であり、選択した4問の追加診断を元の198問のスコアに差し替えない。
導入提案にどう使うか
この構成では、DeepSeekは今回の科学問題の完了、長文処理、コードの固定テストで有望な結果を得た。GLMは短い質問の回答開始が早く、GPQAでもDeepSeekが誤答した5問に正答した。採用を決めるには、実際の業務に近い問題と許容待ち時間を決め、両モデルの説明・根拠・失敗例を確認する必要がある。
GLMの約78万入力・20件同時の補完は完了した。残るのは、独自問題の論述回答に対する専門家のレビューと、実際の業務データを使った評価である。回答が完了したことや数値・引用IDが合ったことだけで、科学的な説明全体が正しいとは判断しない。
今回の結果は、B200を8基搭載したHGXサーバーで測定したものです。他のGPUや構成では性能が変わるため、同じ結果を保証するものではありません。
数値を確認する資料
図表と数値の照合は完了している。回答内容の点検はCodexによる補助レビューであり、独立した専門家の評価ではない。
図表・集計値・再現条件・独自問題の回答をまとめてダウンロード(ZIP)
社内LLM・GPUサーバーの構成・見積を相談する
科学的な検討に使う社内LLMや、GPUサーバーの導入をご検討の方は、サーバー相談・見積フォームをご利用ください。
用途に近い問題と待ち時間を確認
モデル・人数・資料長・予算
必要な追加検証と構成を相談
相談時には、希望モデルと版、用途、最大同時利用人数、通常・最大の資料長、許容待ち時間、導入時期・予算を分かる範囲でお知らせください。
この測定はB200 8GPUの記載条件によるものです。他のGPU構成の性能や、特定業務での回答品質を保証するものではありません。
実際の応答速度を、等速の映像で見る
HGX B200 8GPUでDeepSeekに質問したときの待ち時間、20件同時の応答、長い科学解説が生成される様子を録画しました。実演の狙い・プロンプト・測定値とYouTube動画はこちらをご覧ください。