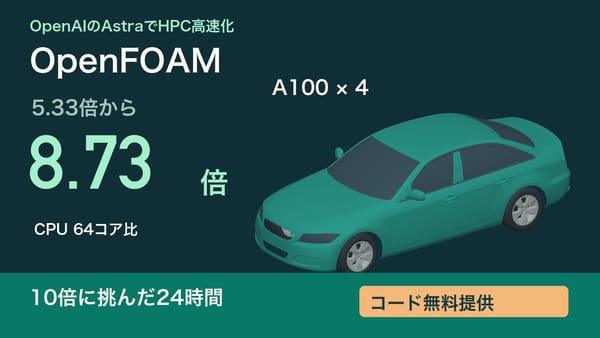
OpenFOAMの6,533万セル計算を、A100×4でCPU 64コアの5.33倍に高速化した
DrivAerの6,533万セルを対象に、CPU 64コアとA100 4枚で同じ480反復を計測。Nsight Systemsを使った改善と、5.33倍を達成した条件、速度場・圧力場に残る差を紹介します。
CPUで108分40秒かかったDrivAerの車体まわりの流れを、4枚のA100で20分23秒まで短縮した。以前のGPU版は63分37秒。同じ車体、同じメッシュ、同じ480反復で、従来のGPU版からも68.0%時間を削れた。
続報 CPU 64コア比で5.33倍から8.73倍へ
同じDrivAerの480反復をA100×4でさらに高速化し、20分23秒から平均12分27秒に短縮しました。8.73倍の測定条件と結果を見る · 続編を動画で見る
以前にも同じA100サーバーで高速化を試した。HGX B200を借りた期間にもOpenFOAMに取り組んだが、そのときは目ぼしい成果を得られなかった。今回の糸口は、GPUの世代を変えることよりも、各反復でCPUとGPUの間を何GBのデータが動いているのかを測ったことだった。
CPUは一度測り、GPUだけを変える
対象はOpenFOAM v2606の定常流ソルバー simpleFoam。乱流モデルはk–ω SST、セル数は65,334,765。CPU基準はXeon Gold 6430を2基、計64物理コア・64 MPIランクで実行した6,520.41秒とした。GPUはPCIe版A100 80 GBを4枚、計8 MPIランク、カードあたり2ランクで使用した。
CPUとGPUは同じ400反復目の保存場から再開し、880反復目まで進めた。開始場は元のセル番号に戻して速度や圧力などの一致を確認済みだ。倍精度、空間離散化、内部反復数を維持し、圧力は12回、速度は各成分15回、kとωは各8回とした。全体時間はMPIの起動から終了までで、ケース読み込みと120反復ごとの場出力を含む。ケース複製とMPSの立ち上げは計時前に行った。午後は保存済みのCPU測定を使い、GPUの改良版を順に比較した。
ボトルネックは境界のデータ移動に見えた
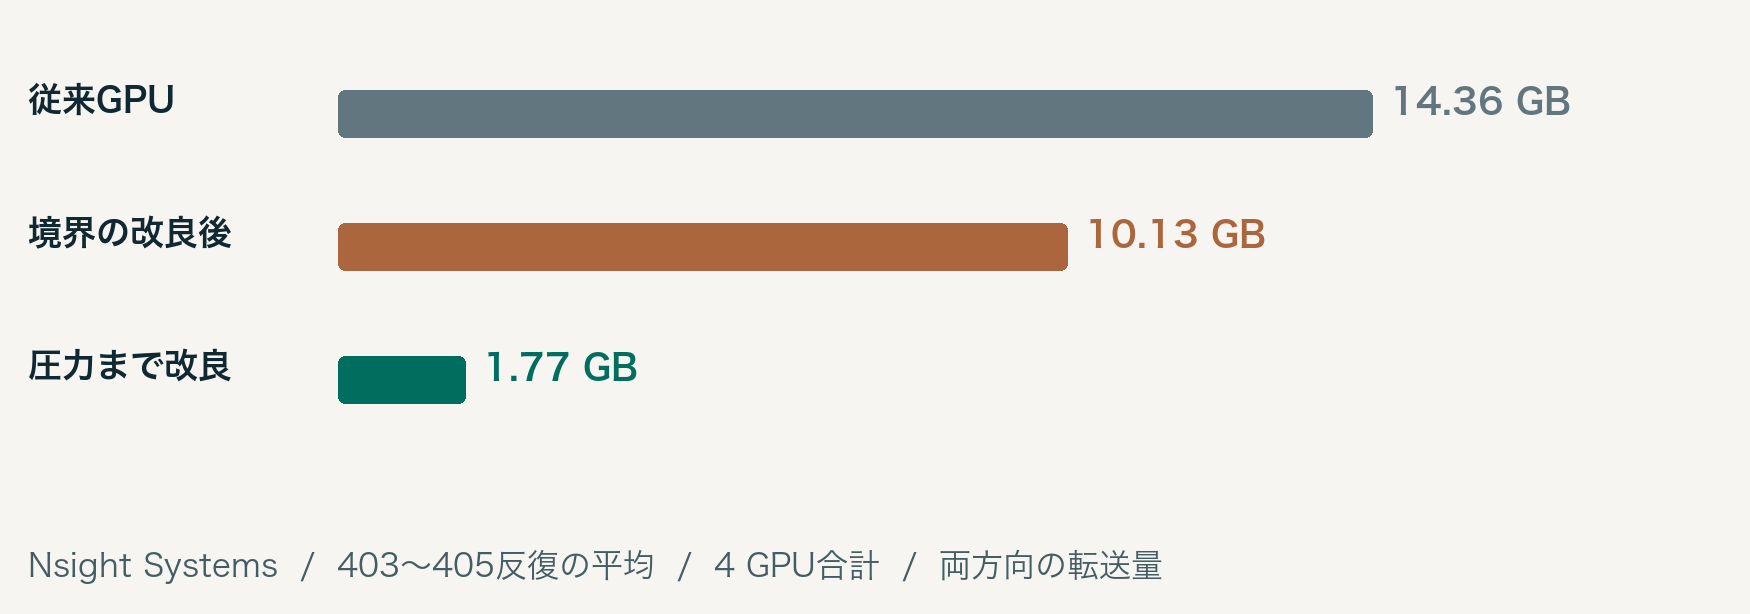
NVIDIA Nsight Systemsで403~405反復を切り出した。従来GPU版の統合メモリ転送は、ホストからGPUへ7.18 GB、逆方向にも7.18 GB。4枚合計では1反復あたり14.36 GBだった。途中版では速度成分を取り出す処理と、圧力補正でベクトル場をセル体積で割る処理の実行中に、それぞれ約1.13 GBのホスト→GPU転送が重なっていた。トレースで時間帯を絞り、コードに戻って呼び出し元を追った。
同じセルを何度もたどる処理をまとめた
境界面の値を補正するたびに、広い領域を走査し、細かいGPU処理を何度も起動する経路があった。静止メッシュでは境界面とセルの対応は変わらない。その対応を再利用し、同じセルに寄与する境界係数をまとめて加算するようにした。CPU側の経路へ入っていた処理を修正し、速度予測場と対角係数の計算もGPU上の少ない回数の走査にまとめた。
圧力方程式の多重格子法GAMGでは、分割領域の境界で隣のMPIランクから値を受け取る。境界データの詰め込みと受け取り後の加算をまとめ、内部セルの平滑化計算を通信に重ねた。見落としやすかったのは、ライブラリに加えた変更の一部が実行ファイル内の既存実装に届かなかったことだ。実行ファイルも作り直し、実際に呼ばれる処理を変えた。
最後の構成では、乱流モデル k–ω SST の混合関数と実効拡散係数など、同じセルの値を何度も読む計算もまとめた。さらに、同一サーバー内のMPI通信を共有メモリ経由にし、領域の隣接関係に合わせて8ランクを4枚のGPUに配置した。この組み合わせを最後に480反復で計時した。
480反復を完走して時間を比べる
| 構成 | 総時間 | 分・秒 | CPU比 |
|---|---|---|---|
| CPU 64コア | 6,520.41 秒 | 108分40秒 | 1.00 倍 |
| 従来GPU | 3,817.30 秒 | 63分37秒 | 1.71 倍 |
| 先行改良版 | 2,608.59 秒 | 43分29秒 | 2.50 倍 |
| 境界・圧力改良版 | 1,472.45 秒 | 24分32秒 | 4.43 倍 |
| 最終改良版 | 1,222.71 秒 | 20分23秒 | 5.33 倍 |
数反復のテストは候補の選別に使い、表には480反復を完走した構成を載せた。最速版の通常反復の中央値は2.404秒。表の速度比はこの中央値の比ではなく、CPUとGPUの総時間から計算した。構成ごとの長時間測定は各1回で、反復測定から得た誤差幅はない。
途中の4.43倍の試験では、過去のケースを読み込んだLinuxのファイルキャッシュが蓄積し、序盤が一時12秒以上かかった。完了済みケースのキャッシュを解放すると、同じ実行のまま約2.5~3秒に戻った。保存データは保持し、遅かった区間もその試験の総時間に算入した。
速くなった流れ場は、CPUとどこまで一致したか
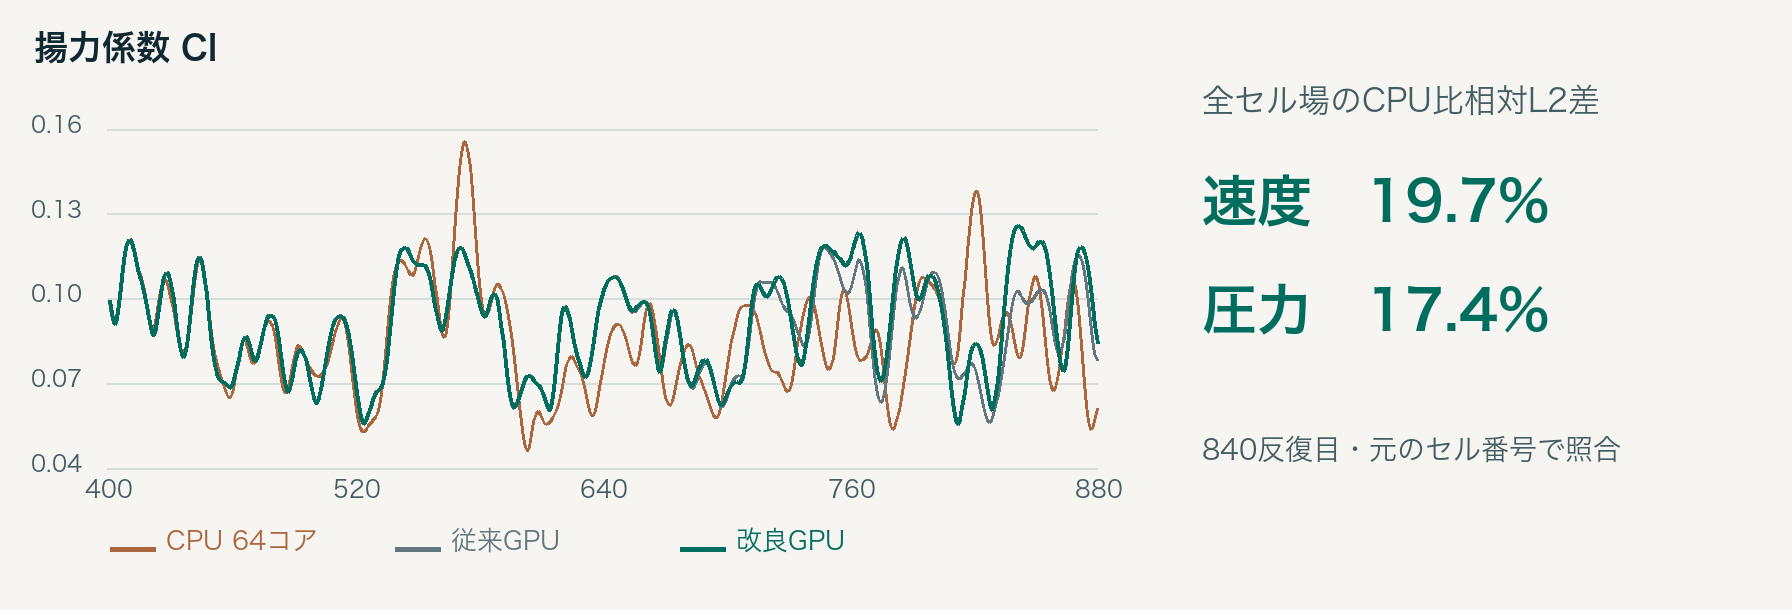
CPUの64分割とGPUの8分割を、元のセル番号で対応させた。840反復目に保存された全セル場の相対L2差を示す。これは差のL2ノルムをCPU場のL2ノルムで割った値で、各セルの誤差率の平均ではない。GPUの高速化前から、同じ反復番号でCPUとGPUの流れ場には差があった。
| 840反復目 | 速度 U | 圧力 p | 乱流エネルギー k | 比散逸率 ω |
|---|---|---|---|---|
| 従来GPU 対 CPU | 19.10% | 16.73% | 25.94% | 4.24% |
| 最速GPU 対 CPU | 19.65% | 17.39% | 26.68% | 4.31% |
| 空力係数 | CPU Cd | 最速GPU Cd | CPU Cl | 最速GPU Cl |
|---|---|---|---|---|
| 最後の20反復平均 | 0.27243 | 0.27280 | 0.08033 | 0.09742 |
最後の20反復平均の差(最速GPU-CPU)は、抗力係数Cdが+0.00037、揚力係数Clが+0.01710だった。定常性は直近60反復を20反復ずつの3区間に分け、Cd・Clそれぞれの各区間の振れ幅が0.001以下、隣接区間の平均差が0.0001以下になるかを20反復ごとに評価した。2回連続合格を到達条件としたが、880反復目までにCPU、最速GPUとも到達を確認できなかった。
今回実証できたのは、この65Mセルのケースで480反復を5.33倍速く処理できたことだ。実務で次に比べたいのは、抗力・揚力の平均とばらつきが所定の範囲に収まるまでの時間である。
数値・図は今回のA100×4による計測。HGX B200の過去の試行は性能表に含めていない。計測機能の参考資料 NVIDIA Nsight Systems User Guide