A100×4でDrivAer 65Mを解く ── OpenFOAMの実測をSPUMA論文と比較する
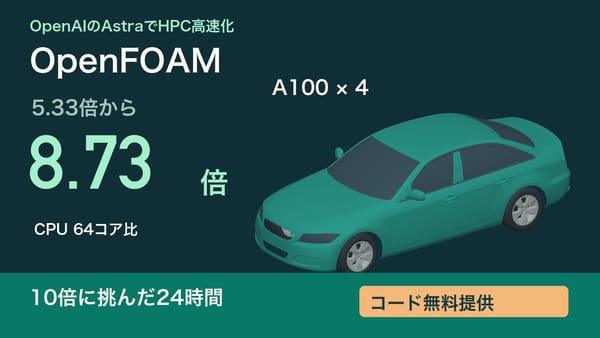
6,533万4,765セルの車体まわりの流れを、A100 PCIe 80 GBを4枚使って計算した。480反復の平均は747.17秒、CPU 64物理コアでは6,520.41秒だった。この8.73倍という結果を、同じDrivAerを解いたSPUMA論文の「100反復172.41秒」とどう比較できるだろうか。
6,533万4,765セルの車体まわりの流れを、A100 PCIe 80 GBを4枚使って計算した。480反復の平均は747.17秒、CPU 64物理コアでは6,520.41秒だった。この8.73倍という結果を、同じDrivAerを解いたSPUMA論文の「100反復172.41秒」とどう比較できるだろうか。
比較の軸は二つある。CPUとの比較では、同じ保存場から同じ回数だけ方程式を解いた総時間を見る。論文との比較では、100回の外側反復を進める時間を取り出し、その100回に含まれる内部計算の違いを確認する。
「1反復」の中で何を計算したか
対象はOpenFOAM v2606のsimpleFoamによる定常・非圧縮のRANS計算で、乱流モデルはk–ω SST。SIMPLEの外側反復を1回進めると、その中で速度、圧力、乱流量の線形方程式を解く。すべて倍精度で、セル番号は32ビットとした。CPUはXeon Gold 6430を2基、64物理コア・64 MPIランク。A100は1枚1ランクで、4分割の各領域内のセルをHilbert順に並べた。
CPUとGPUを元のセル番号で照合した400反復目の共通の保存場から再開し、880反復目まで進めた。速度の各成分を15回、圧力はGAMGを12サイクル、最粗格子のPCGを35回、kとωは各8回。MPI起動から終了までを計り、480・600・720・840反復目の場出力を含めた。CPUは既存の1回の実測値を使い、GPUの採用構成は壁面距離を毎回計算して独立に2回測った。
CPU 64コアとA100×4の480反復
| 構成 | 480反復の総時間 | 計測 |
|---|---|---|
| Xeon Gold 6430×2・64コア | 6,520.41秒 | 1回 |
| A100×4・正午の構成 | 平均 775.70秒 | 2回 |
| A100×4・採用構成 | 平均 747.17秒 | 747.68/746.66 秒 |
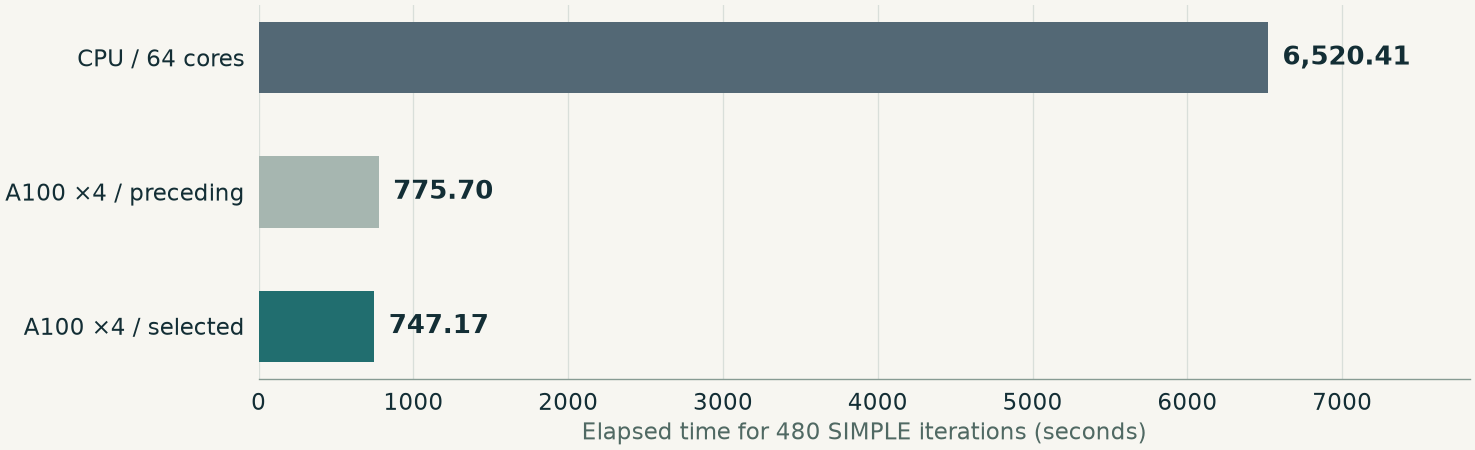
正午からさらに28.53秒、3.68%短縮した。MPI起動から初回反復開始までが51.40秒から36.41秒、初回反復も25.00秒から17.27秒になった。通常反復の中央値は1.410秒から1.401秒。ここでいう通常反復は、401~402反復目と場出力の回を除いたもの。各計測の中央値を2回分平均した。
壁面から各セルまでの距離を伝播・抽出する処理をGPUに移し、壁面近傍の幾何計算をCPUで並列に実行した。格子・粗格子の対応表をGPUで安定ソートし、近隣セルの番号を16ビットの差分で持てる部分では読み出し量を減らした。Nsight Computeで細かい格子の残差・補正カーネルを4回採取したところ、DRAM帯域は持続ピークの約69~75%だった。プロファイラを付けた時間は速度表から除いた。
採用構成では、回数固定の圧力解法で途中の停止判定に使われない残差ノルムの全体集計も省いた。最終残差と特異性の確認は維持した。面のテンソル流束計算では、積和の順序を照合した上で、同じ所有セルに属する複数の面でテンソルの読み出しを再利用した。これらを組み合わせた結果を下の保存場と履歴で照合している。
SPUMA論文の表13と同じ尺度で読む
BnàらはイタリアのスーパーコンピューターLeonardoで、10反復終了から110反復終了までの経過時間を測っている。圧力ソルバーにGAMGを用い、同じ6,533万セルのままGPUの枚数を変えた結果を引用する。表13。
| 実装・機種 | GPU枚数 | 100反復の時間 |
|---|---|---|
| SPUMA・Leonardo A100 | 2 | 302.80秒 |
| SPUMA・Leonardo A100 | 4 | 172.41秒 |
| SPUMA・Leonardo A100 | 8 | 116.56秒 |
| 今回・PCIe A100 | 4 | 143.29秒 |
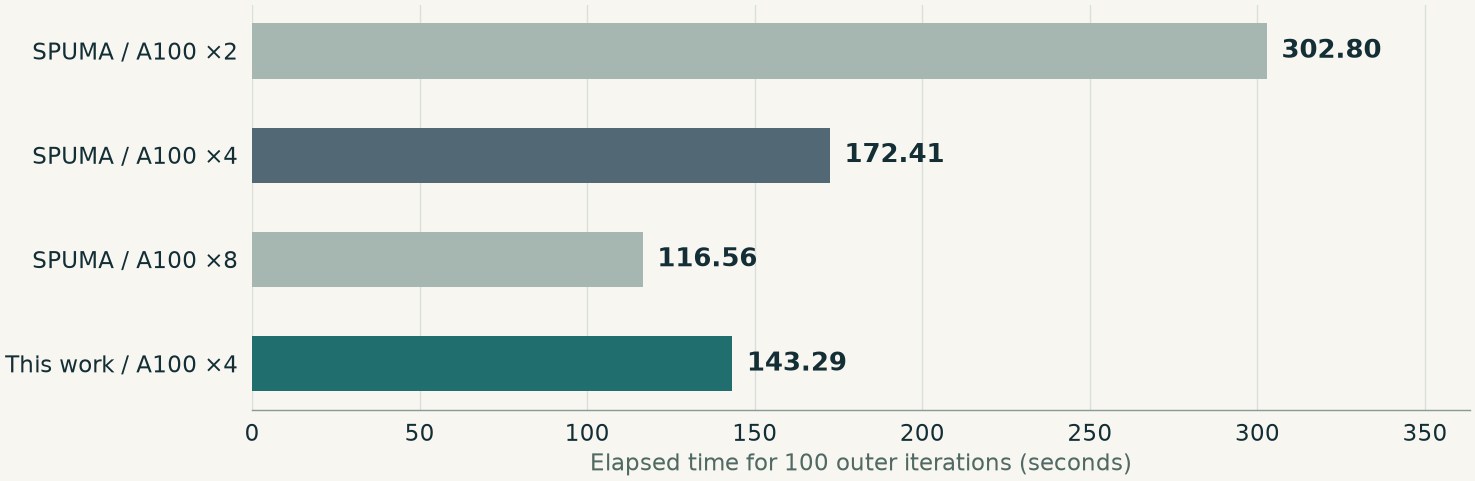
今回も時刻0の初期場から計算し、10反復終了から110反復終了までを計時した。最終的な格子番号に合わせて4領域の全初期場を生成し、初期速度は全6,533万4,765セルで大域場と一致することを確認した。別に行った480反復計測の410反復終了から510反復終了までは平均143.93秒で、場出力1回を含む。
4枚同士の経過時間では今回が16.9%短く、外側反復の処理数で見ると1.20倍になる。論文は64 GB版のA100とOpenFOAM v2412系の実装を使用した。圧力はGAMG+Richardson、速度・乱流量はPBiCG+aDILUで、相対許容誤差は0.1。手元は内部反復を固定している。分割、初期化、出力設定の差もある。外側反復に含まれる仕事量が違うため、この時間差から個々の実装の優劣や、同精度の解を得るまでの速さは決められない。付録A。
同じ結果を保てた範囲
全480反復の力係数、6方程式の初期・最終残差と内部反復数、連続の式の誤差(局所・全体・累積)は、記録した桁まで正午のGPUと一致した。840反復目のU・p・k・ω・nut・φは、4領域の計24ファイルがバイト単位で一致した。一方、同じ840反復目のCPUに対する全セルの相対L2差は、速度19.35%、圧力16.98%だった。元のセル番号に戻し、セル体積による重みを付けず、差のL2ノルムをCPU場のL2ノルムで割った値である。
同じ全セルでも、各セルの体積で二乗誤差を重み付けすると、速度は0.35%、圧力は6.84%となる。セルを一つずつ等しく数えた場合と、流体の各部分を体積に応じて数えた場合の両方を示した。
採用構成の480反復では、乱流量を下限に補正する記録がωに480回、kに324回あった。これは補正を記録した回数で、影響を受けたセル数は表さない。定常解の品質を判断する際には、この履歴も検討する必要がある。
この試験で示せたのは一定の反復数を処理する速さまでで、抗力・揚力が定常化するまでの時間は確定していない。次のHGX B300では、まずA100と同じ4分割・4枚、次に8枚を測定する。再開場・内部反復・出力間隔を固定して世代差と台数差を調べる予定だ。
English abstract
We compare our double-precision OpenFOAM v2606 benchmark on four A100 PCIe GPUs with the SPUMA paper on the same 65.3-million-cell DrivAer mesh. The 480-iteration restart and 100-iteration comparison use explicit clock boundaries. Different inner solvers and stopping criteria limit the interpretation of cross-study speed ratios. Read the full article in English.
出典・データ・実装
Bnà et al., Computer Physics Communications 321 (2026), 110009 · arXiv:2512.22215 · CINECA / SPUMA · OpenFOAM HPC Technical Committee: occDrivAerStaticMesh · OHC-1 mesh files · CC BY 4.0 · 前回のA100実測.
各反復の計時・残差・力係数と設定をダウンロード · 測定値・誤差を収録したJSON · 解説動画(日本語) · English subtitles · 日本語字幕