GLM-5.3 Flashの3ビットと4ビットを比較:RTX PRO 6000 Max-Q×2、llama.cppの速度と回答品質
RTX PRO 6000 Blackwell Max-Q 96GB×2で、GLM-5.3 Flashの3ビット・4ビットをMTPなし/ありで実測。生成速度、25.8万トークンの長文処理、同じ16問の回答品質を比較します。
RTX PRO 6000 Blackwell Max-Q 96GB×2で、GLM-5.3 Flashの3ビット・4ビットをMTPなし/ありで実測。生成速度、25.8万トークンの長文処理、同じ16問の回答品質を比較します。
科学的推論20問が完了し、数値照合は12/12。一方、回答完了は中央値73秒。短問の5並列は中央値269秒、10セッションは起動時に停止しました。B200との比較条件と全回答を公開します。
A100・H100・HGX B200でLAMMPS、GROMACS、Quantum ESPRESSOを36条件×3回。計算時間と起動終了時間、GPU増設で速くなった条件・遅くなった条件を、全108回の数値と再現情報で紹介。
H100×2でGLM-5.3-Flashは指定条件の生成速度50 tokens/s超。MTPの基礎、1M容量での待ち時間、出力上限4,096・8,192の288回答、個別の誤答と限界を公開します。
質問から回答までを等速で収録。1件と20件同時の待ち時間、長い科学解説の生成速度を、実際の映像と測定値で紹介します。
HGX B200 8GPUでDeepSeek V4.1 Flash 1017とGLM-5.3を比較。科学問題198問、独自回答例、1件対20件の待ち時間・生成速度、約78万トークン入力の補完試験と未完了例を記録。
サーバー・ワークステーションの部品情報をHTML・CSV・JSONに整理する無料ツール。シリアルなしの共有用と保守用を選択し、A100・H100実機で検証しました。
CPU・メモリ・GPU・実行時間からSlurmのジョブスクリプトと投入手順を自動生成。対話モードの使い方と、H100・A100で実行した検証結果を動画付きで解説します。
DockerとNVIDIA Container Toolkitを新規導入し、GPUなし・1枚・全GPUの一時コンテナでCUDA計算を確認する無料スクリプト。H100×2での実測結果と、既存環境で停止する条件を解説します。
GPU温度・ECC・メモリ・ディスク容量を読み取る無料スクリプト。A100×4、H100×2で取得した実際のレポートを使い、実行手順と要確認・未確認の読み方、相談方法を紹介します。
CPU・メモリ・GPUを検出して、単一UbuntuサーバーにSlurmを導入。H100×2、A100×4でGPUの割り当てとアクセス制限を確認した無料スクリプトを、動画・コマンド・検証条件とともに紹介します。
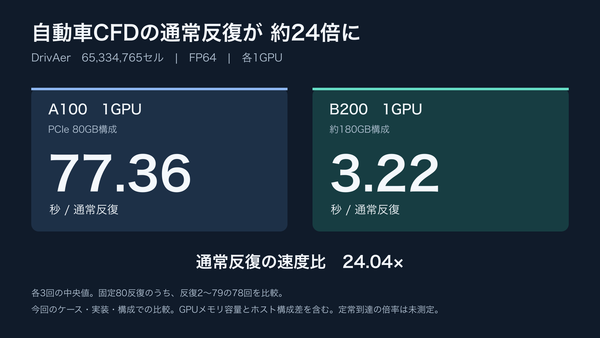
6,533万セルのDrivAerをA100とB200で各1GPU計測。今回の同一数値条件では、通常反復77.36秒→3.22秒、約24倍。CPU64/128コアの参考時間、構成と適用範囲も公開します。